NVIDIA в 3,5 раза ускорила работу модели для картинок FLUX 3 Image Klein
С настройками NVIDIA полная версия FLUX 3 Image Klein рисует картинку 2048×2048 на ускорителе B200 за 6,5 секунды вместо 22, но часть приёмов меняет результат.
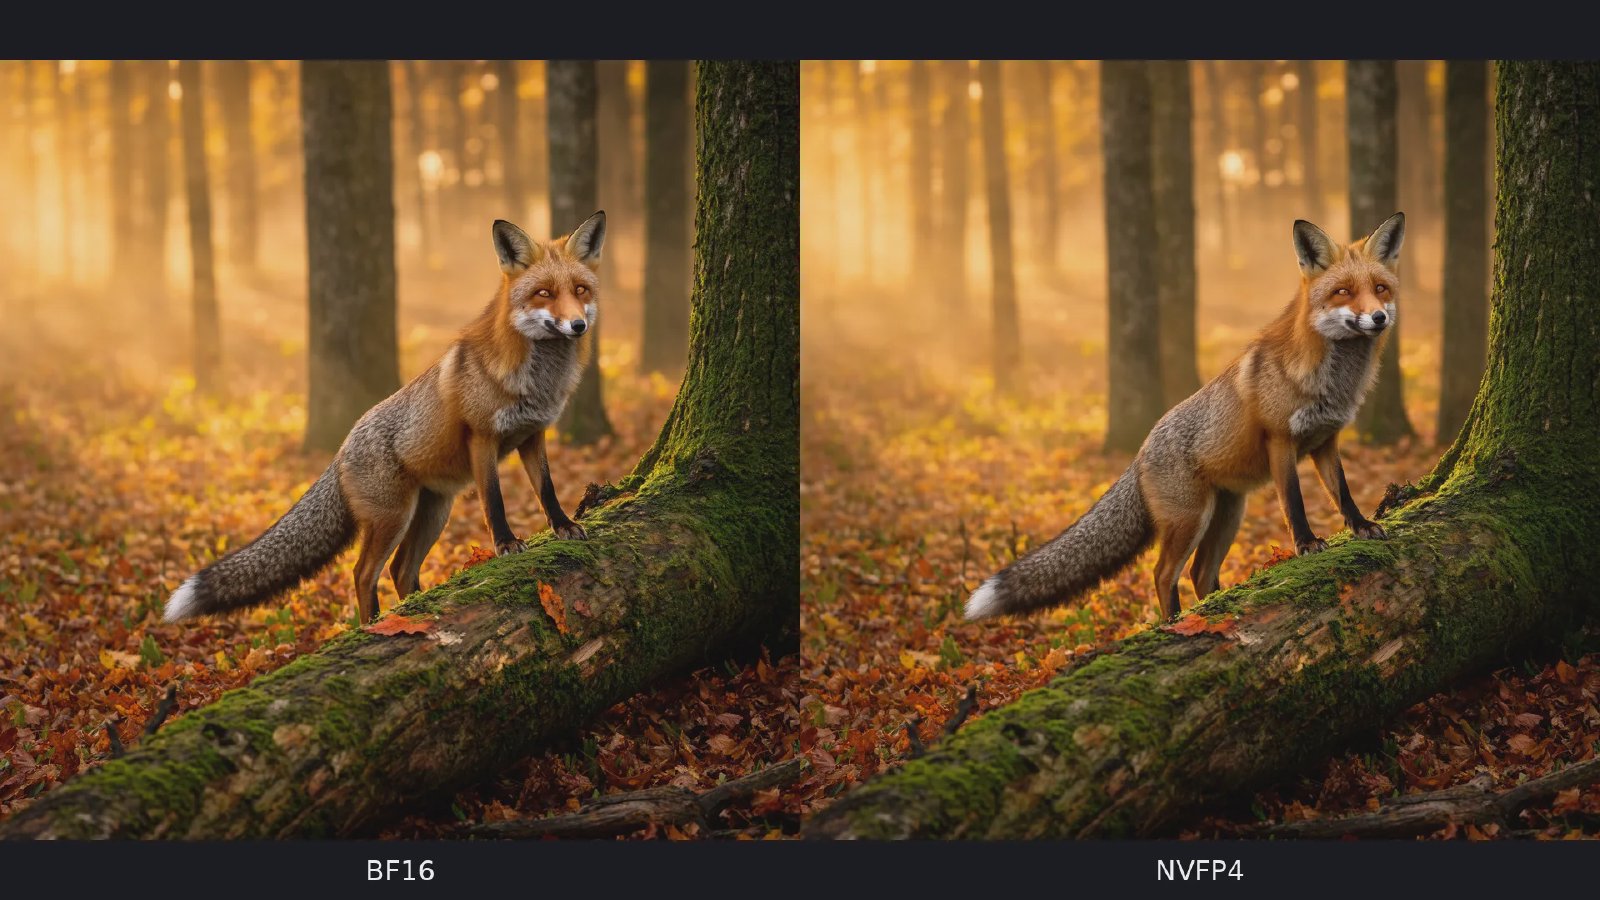
С набором настроек из библиотеки NVIDIA TensorRT LLM1 полная версия модели FLUX 3 Image Klein от Black Forest Labs рисует картинку 2048×2048 на одном ускорителе B2002 за 6,5 секунды. Без оптимизаций на это уходило 22,4 секунды. Правка готового изображения по запросу ускоряется ещё сильнее — с 54,6 до 12,3 секунды, в 4,45 раза, следует из замеров NVIDIA.
Предыстория: Black Forest Labs выложила Klein 15 октября. Открытая модель рисует картинки по описанию и правит готовые, а обучали её, по словам NVIDIA, на серверных стойках NVIDIA GB200 NVL72. Запуск модели в TensorRT LLM, в том числе с весами в четырёхбитном формате NVFP43, NVIDIA поддержала с первого дня. Теперь компания описала, какие настройки дают выигрыш и чем за него приходится платить.
Как это работает: диффузионная модель рисует, шаг за шагом очищая изображение от шума, и каждый шаг — это проход через сеть из миллиардов параметров. Исходному варианту, Klein Base, нужно 50 шагов, и на каждом он считает картинку дважды — с учётом запроса и без него. Дистиллированный вариант научили обходиться 16 шагами, и на каждом из них сеть считает картинку один раз. Поэтому он с самого начала быстрее, а от оптимизаций выигрывает меньше — до 2,34 раза.
Детали: больше всего времени уходит на очистку от шума, а внутри неё — на механизм внимания4. При разрешении 2048×2048 на него приходилось около 60% времени, которое видеокарта тратит на основную сеть.
Что дал каждый приём по отдельности:
- Веса в формате NVFP4 вместо 16-битного BF16 ускоряют рисование до 1,62 раза, а правку — до 1,58 раза. Готовые веса в этом формате выпускает сама Black Forest Labs.
- Внимание в восьмибитном формате (VC-Attention FP8) ускоряет генерацию в 1,16–1,18 раза.
- Разреженное внимание (Sol-Attention) пропускает часть вычислений: Base ускоряется в 1,24 раза, если первые 16 шагов считать полностью, и в 1,3 раза, если первые 12. Разреживать сильнее, по словам NVIDIA, смысла нет: картинка портится, а скорость почти не растёт.
- Кэширование (Cache-DiT) подставляет промежуточные результаты прошлых шагов, пока они почти не меняются. Base от него становится быстрее в 1,94 раза, дистиллированный вариант — лишь в 1,2 раза.
В цифрах: в отдельном замере NVIDIA сравнила один ускоритель и восемь на сервере DGX B200. Модель работала с весами NVFP4, но без части приёмов, которые дали 6,5 секунды. На восьми ускорителях картинка 2048×2048 у Base получается за 3 секунды против 14,9 на одном, у дистиллированного варианта — за 1,08 секунды против 2,73. Сама очистка от шума ускоряется в 6 и 4,4 раза соответственно. Но у дистиллированного варианта на восьми ускорителях около половины времени уходит на другие этапы, и они сдерживают общий выигрыш. На серверной видеокарте RTX PRO 6000 Blackwell Server Edition набор попроще, без приёмов для внимания, ускорил генерацию в 1,73–3,25 раза.
Но: часть приёмов меняет саму картинку. NVIDIA измеряла это метрикой LPIPS: она оценивает, насколько заметна глазу разница между двумя изображениями, и чем ближе к нулю, тем разница меньше. У восьмибитного внимания она составила 0,086 для Base и 0,151 для дистиллированного варианта, у кэширования — 0,03–0,04. В замеры не вошло время работы модели, которую Black Forest Labs выложила 14 октября, чтобы дописывать короткие запросы.
NVIDIA приложила готовые файлы настроек и уже собранный контейнер TensorRT LLM — упакованную среду, где установлено всё нужное для запуска, так что собирать её самому не надо. Модель можно запускать из командной строки или поднять как сервис: другие программы шлют ему запросы на картинки в том же формате, что и сервису OpenAI для создания изображений.