Vera Rubin NVL72 в тесте MLPerf обошла GB300 NVL72 до 3,7 раза
Новая стойка NVIDIA впервые прошла MLPerf. Облако Lambda с системой распределения питания DSX MaxLPS разместило 19 серверов в энергобюджете 16 и выдало на 24% больше токенов.
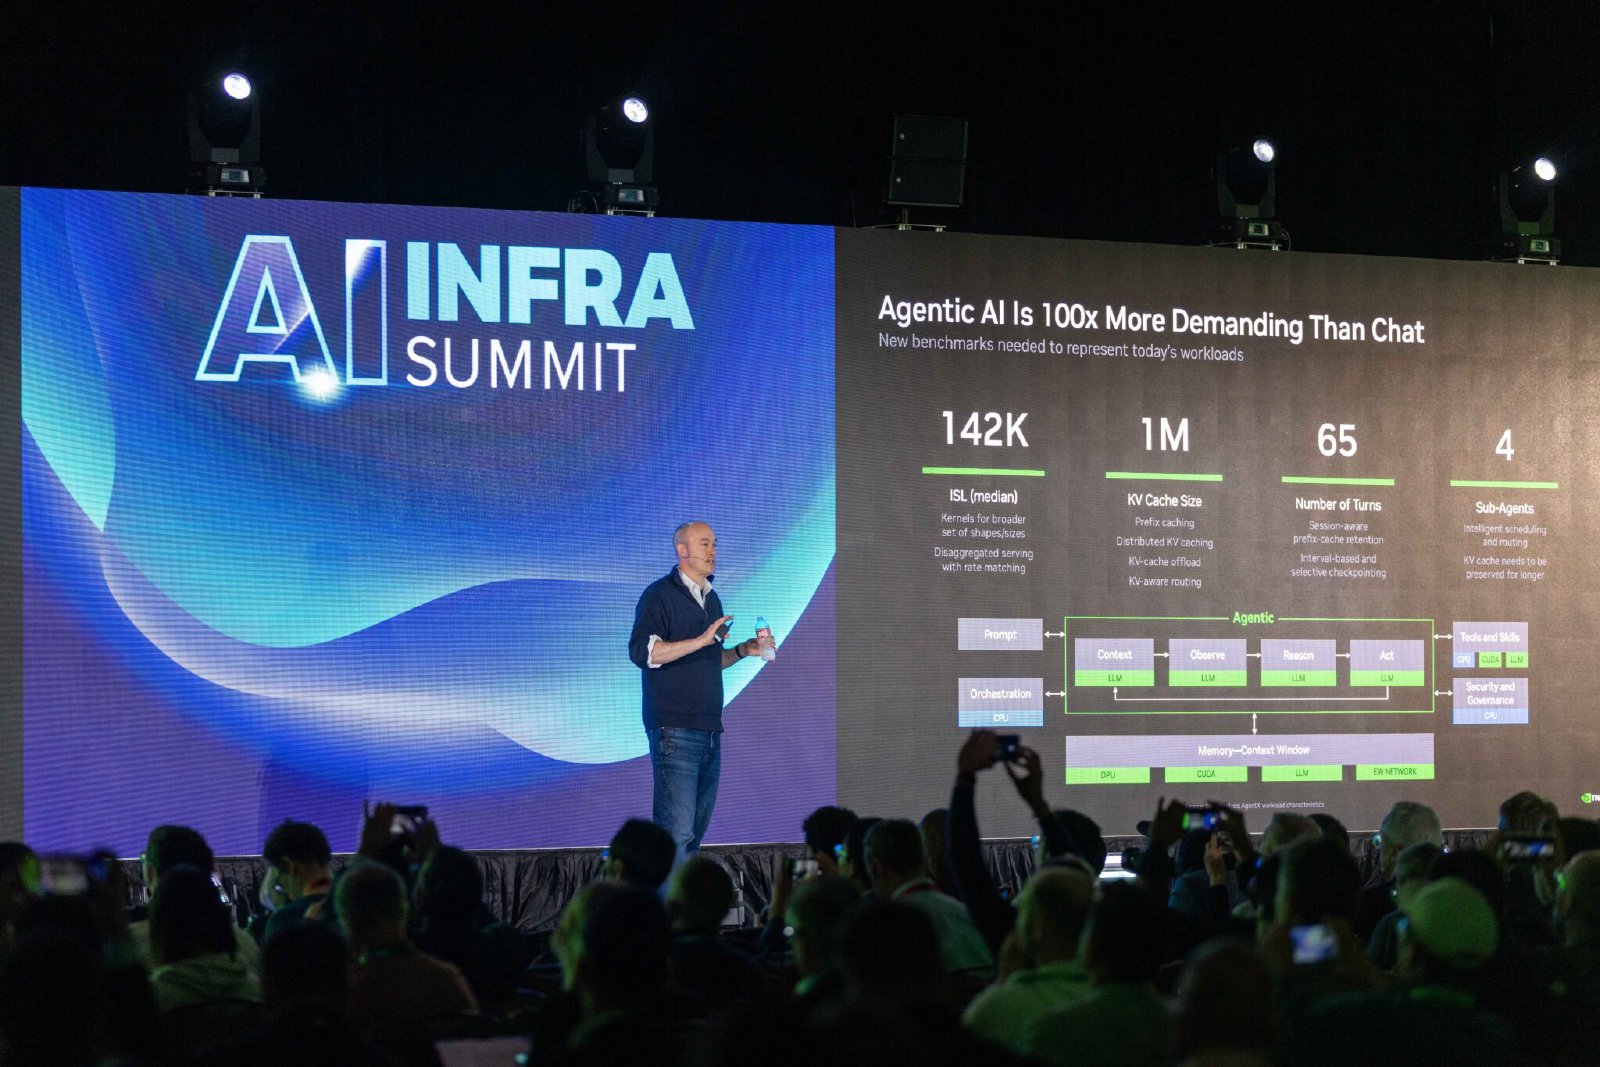
Серверная стойка Vera Rubin NVL72 в тесте MLPerf Inference v6.1 обработала до 3,7 раза больше запросов в единицу времени, чем GB300 NVL72 прошлого поколения, сообщила NVIDIA. Результаты 15 сентября представил вице-президент компании Иэн Бак на конференции AI Infra Summit в Санта-Кларе. По данным NVIDIA, в этом году её посетили более 8 000 человек против 3 500 годом ранее.
MLPerf Inference — отраслевой бенчмарк консорциума MLCommons. Он охватывает много разных моделей, и каждый результат до публикации проверяют другие участники. Vera Rubin NVL72 участвовала впервые, в категории предварительных заявок.
Часть прироста NVIDIA получила без новой техники. Только за счёт оптимизации программ её результаты в v6.1 оказались до 1,6 раза выше, чем в предыдущей версии теста v6.0. Четыре стойки GB300 NVL72 с 288 GPU сохранили 99% эффективности масштабирования: производительность росла почти пропорционально числу стоек.
Облачный провайдер Lambda первым проверил на серверах Blackwell систему DSX MaxLPS. Она постоянно следит за потреблением энергии видеокартами и стойками и перебрасывает мощность туда, где она нужна сейчас. Обычно этот запас простаивает, потому что каждому серверу заранее выделяют питание с расчётом на пиковую нагрузку. Lambda запустила 19 узлов в энергобюджете, рассчитанном на 16 узлов на полной мощности. Кластер стал выдавать на 24% больше токенов — около 5 млн в секунду вместо 4 млн, а производительность на ватт выросла на 23%.
Для стоек Vera Rubin NVL72 NVIDIA обещает с DSX MaxLPS до 40% больше GPU при той же мощности площадки, но только «в подходящих условиях развёртывания».
Стартап Emerald AI вместе с NVIDIA показал, как дата-центр сам снижает потребление по запросу энергосети. Опыт прошёл в программе гибкого подключения Silicon Valley Power — муниципальной энергокомпании Санта-Клары. Система ответила на сотни сигналов сети: важные задачи продолжали работать, второстепенные останавливались и затем возобновлялись.
Бак также назвал новых партнёров. Подразделение Amazon Annapurna Labs1 вместе с NVIDIA разрабатывает собственный вариант скоростной памяти NVHBM. Компания d-Matrix2 через NVLink Fusion3 подключит свои ускорители Raptor к процессорам NVIDIA Vera.
В августе NVIDIA уже приводила результаты Vera Rubin NVL72 в тесте SemiAnalysis AgentX: до 30 раз больше работы агентов на мегаватт, чем у GB300 NVL72. Тогда же компания запустила в серию ускоритель Groq 3 LPX, а в конце месяца начала поставки процессора Vera.