Meta* показала модель, которая даёт ИИ-агенту Muse лицо в видеозвонке
Модель Muse Realtime Avatar превращает фото, рисунок или предмет в собеседника, который отвечает голосом и мимикой меньше чем через секунду.
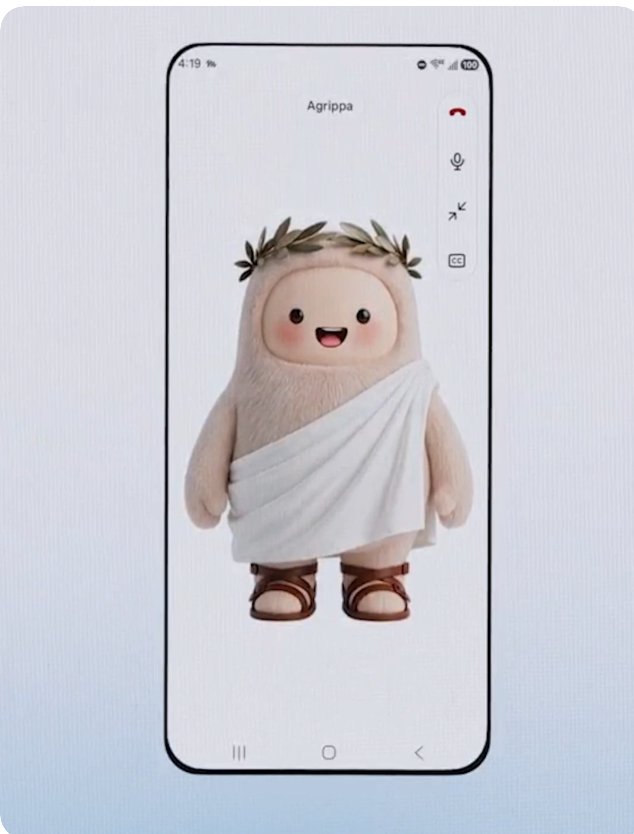
Meta показала Muse Realtime Avatar — модель, которая превращает портрет, рисунок, животное или даже предмет в собеседника, отвечающего по видео голосом, мимикой и жестами меньше чем через секунду.
Почему это важно: с агентом Muse можно будет разговаривать как по видеосвязи. Систему Meta строила под свои масштабы: ответ быстрее секунды и много разговоров на одном чипе.
Повод: модель показал Марк Цукерберг на конференции Meta Connect1, а аккаунт AI at Meta в соцсети X сразу разобрал её устройство в ветке постов. Главное в ветке — ускорение в 60 раз и сравнение с коммерческими аватарами, в котором модель Meta вышла вперёд.
Как это работает: аватар работает в паре с голосовой моделью Muse Realtime Voice, которая ведёт сам разговор.
- Голосовая модель выдаёт поток речевых токенов — коротких кодов, в которых записано и что сказать, и с какой интонацией.
- Из этого потока декодер делает звук, а Muse Realtime Avatar — видео, поэтому голос, движения губ и мимика совпадают.
- Видео идёт короткими кусками, и каждый опирается на окно последних кадров фиксированной длины, поэтому вычислений не становится больше, как бы долго ни шёл разговор.
- В ролик встраивается невидимый водяной знак Meta Video Seal, по которому сгенерированное видео можно опознать; задержки он не добавляет.
Детали: облик аватара задаёт образец — фотография или картинка.
- Фотопортрет отвечает сдержанной мимикой и сохраняет её от реплики к реплике.
- Рисованный персонаж в полный рост жестикулирует и меняет позу, пока говорит.
- Животные и обычные предметы тоже становятся выразительными и при этом остаются узнаваемыми.
Интрига: скорость Meta получила, обучив маленькую модель-ученика повторять большую модель-учителя.
- Учитель доводит каждый кусок видео за 40 шагов по три прохода на шаг — всего 120 вычислений.
- Ученику хватает двух проходов, то есть в 60 раз меньше, а качество, по словам Meta, почти как у учителя.
- Ученика тренировали на его собственных кадрах, как в живом разговоре, чтобы мелкие ошибки не копились и картинка не «уплывала».
В цифрах: ради скорости Meta с нуля переделала свою систему для работы ИИ-моделей в реальном времени и вместе с NVIDIA ускорила саму модель.
- Видео вертикальное, 448×768 точек, 25 кадров в секунду.
- От конца реплики пользователя до первых данных ответа с голосом и видео проходит около 870 мс.
- На одном ускорителе GB2002 модель делает восемь кадров, то есть 320 мс видео, за 20 мс.
- Один GB200 ведёт 12 разговоров одновременно — в восемь раз больше, чем исходная двухшаговая версия без оптимизаций.
Расклад: для сравнения Meta взяла аватары компаний Runway3 и HeyGen4 — Runway Characters и HeyGen LiveAvatar, которые называет двумя ведущими коммерческими системами. Оценщики по две-три минуты говорили с каждой системой в её собственном приложении, с одинаковыми по облику аватарами, и по общему впечатлению чаще выбирали Muse Realtime Avatar.
Но: сравнение проводила сама Meta и показала только график общего предпочтения, без числа оценщиков. Не все аватары из примеров компании есть в приложении Muse, а пользоваться им можно только с 18 лет.
Подробнее: самого агента Muse Meta запустила 8 сентября в WhatsApp и в отдельном приложении: он ведёт долгие задачи в облаке и спрашивает разрешения перед покупками.
* Meta Platforms Inc., которой принадлежат Facebook и Instagram, признана в России экстремистской организацией, её деятельность запрещена.