OpenAI усилила защиту моделей GPT-6 обучением на ИИ-атаках
В тестах OpenAI обучение на автоматически найденных атаках повысило устойчивость моделей, а GPT-6 Astra не стала чаще отклонять безобидные запросы.
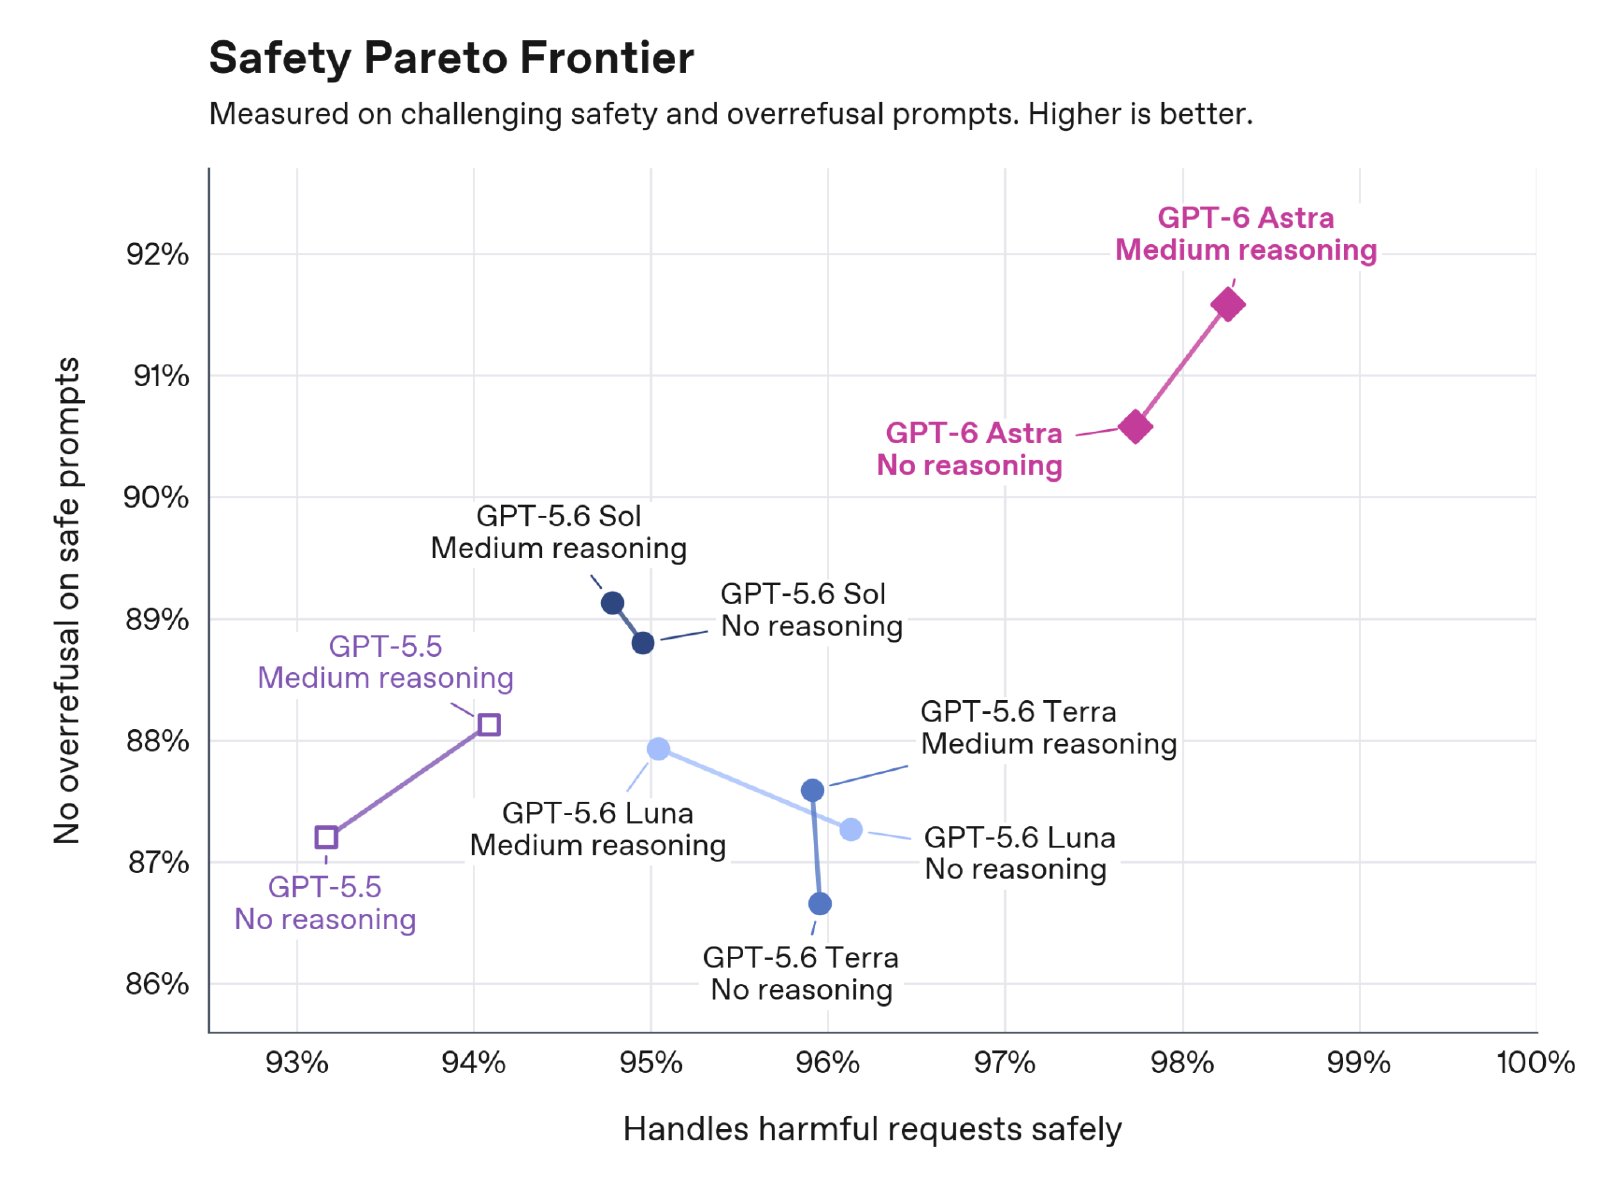
При обучении GPT-6 Astra и GPT-6 Sol OpenAI использовала запросы, которыми другая модель пыталась добиться запрещённых ответов. Найденные способы обхода защиты стали примерами для её усиления.
Почему это важно: Одна и та же информация в биологии или кибербезопасности может помогать исследователю и злоумышленнику. Задача — научить модель сопротивляться опасным просьбам, сохранив полезные ответы на допустимые запросы.
Как это работает: В контролируемом эксперименте запросы подбирала модель семейства GPT-5.6 Sol, обученная помогать пользователю. Специально обходить защиту других моделей её не учили. Она пыталась получить запрещённые ответы от GPT-5.4 и GPT-5.5, видела их ответы и оценки безопасности, затем меняла формулировки. Каждая новая попытка учитывала результат предыдущей.
Детали: Доработанные запросы о биологии, кибератаках и насилии собрали в учебный набор. На нём провели обучение с подкреплением: модель училась по оценкам своих ответов. В контрольном варианте использовали исходные опасные запросы, которые атакующая модель не усложняла. На усложнённых примерах оценка безопасности начиналась с более низкого уровня и росла по мере обучения.
Проверка включала два вида атак. Сначала использовали готовые запросы от другой модели, не участвовавшей в подготовке учебных примеров. Затем атакующей модели дали возможность менять запросы в зависимости от ответов и пробовать снова. В обоих испытаниях обучение на усложнённых запросах дало более высокую устойчивость, чем контрольный вариант. Для OpenAI особенно важен второй результат: улучшение сохранилось против атак, отличавшихся от учебных.
У GPT-6 Astra усиление защиты не привело к более частым отказам на безобидные запросы, сообщает OpenAI. В тесте со сложными запросами она также безопаснее обрабатывала вредные просьбы и реже отклоняла допустимые, чем более ранние модели.
Но: устойчивость к атакам измеряли без дополнительных защитных механизмов, действующих в продуктах OpenAI. Результаты характеризуют защиту самой модели; при использовании её дополняют другие меры безопасности.