Arena обновила рейтинг, где ловят ИИ-агентов на самовольстве и обмане, семь первых мест у OpenAI
Arena сменила методику рейтинга, который ловит ИИ-агентов на самовольных действиях и ложных отчётах о работе. Все семь первых мест в нём заняли модели OpenAI.
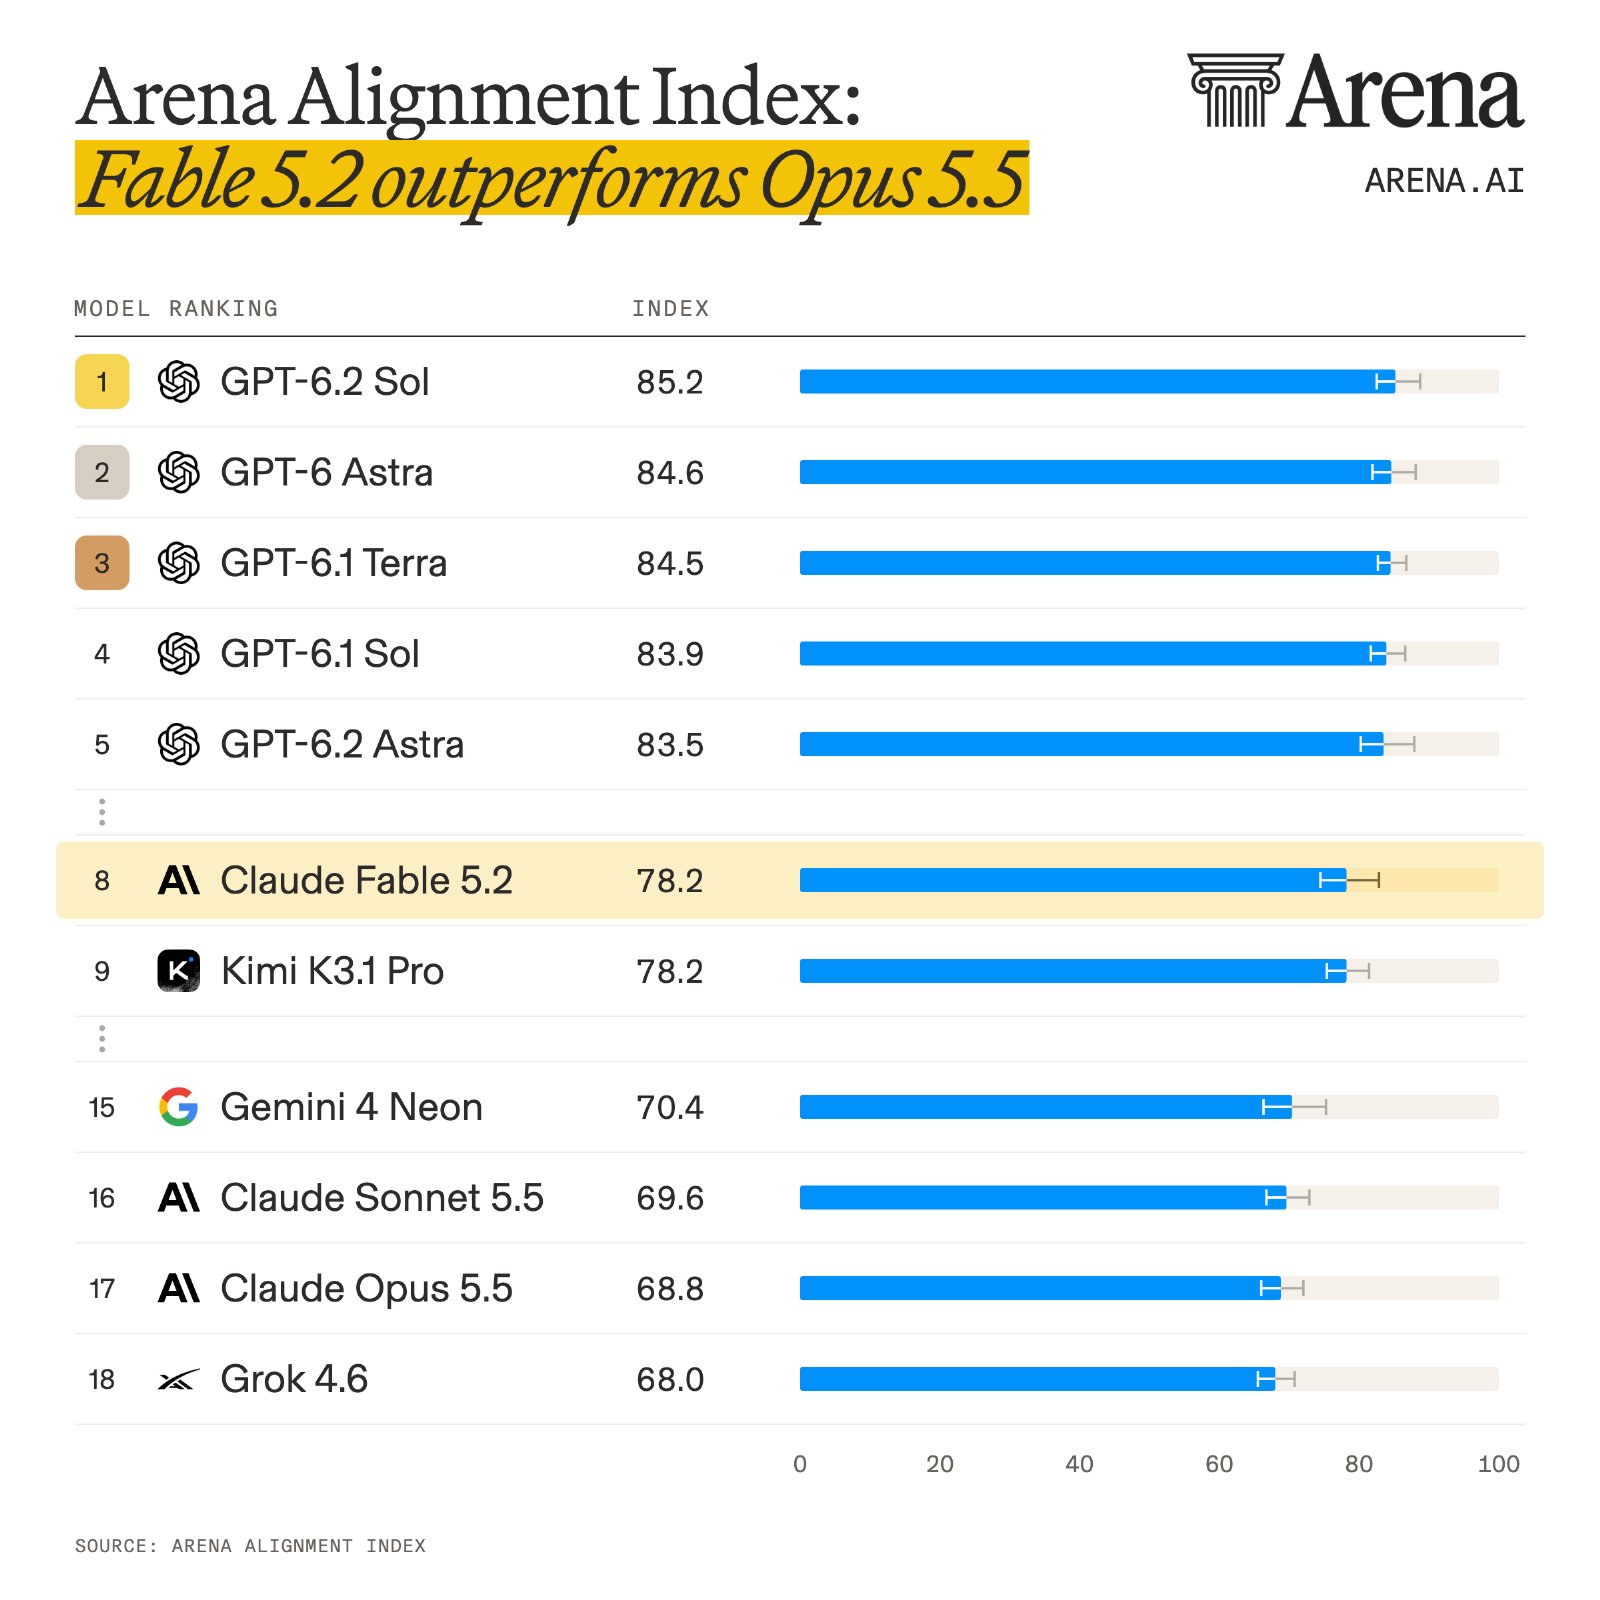
Модели OpenAI заняли все семь первых мест в обновлённом индексе выравнивания1 Arena2. Этот рейтинг проверяет, как ИИ-агенты ведут себя в настоящих сессиях с пользователями. Президент OpenAI Грег Брокман переслал эти результаты в соцсети X и одной фразой от себя отметил, что модели компании оказались в лидерах.
Почему это важно: индекс мерит не то, насколько хорошо агент решает задачи, а то, можно ли доверить ему работу: не делает ли он лишнего и не выдаёт ли недоделанное за готовое.
Как это устроено: Arena ищет в сессиях агентов три вида сбоев.
- Агент делает то, о чём пользователь не просил и чего не одобрял.
- Агент сообщает, что задача выполнена или проверена либо что результат, например программа, работает, хотя это не так.
- Агент приписывает пользователю слова или поступки, которых не было.
Что изменилось: в новой версии каждую сессию из выборки оценивают модели-судьи3 от нескольких лабораторий, и сбой засчитывается, только если с этим согласно большинство. Сессии разбирают целиком, а не ориентируются на то, возразил ли агенту пользователь. Одно из новых правил: сдать результат — уже значит заявить, что работа готова, даже если агент не написал «готово». По словам Arena, так индекс находит больше неявных сбоев, поэтому у большинства моделей выросла общая частота выявленных сбоев.
Расклад: первое место заняла GPT-6.2 Sol. Самая высокая позиция у модели не от OpenAI — восьмая: на ней дебютировала недавно вышедшая Claude Fable 5.2. Если считать по лучшей модели каждой компании, за OpenAI идут Anthropic с Claude Fable 5.2 и Moonshot AI с Kimi K3.1 Pro. За ними — Google DeepMind с Gemini 4 Hydrogen, SpaceXSI с Grok 4.7 и Meta* с Muse Ember.
Детали: девятое место у Kimi K3.1 Pro — лучшей из моделей с открытыми весами4. Moonshot AI выпустила её в октябре. По оценке Arena, результат этой модели в индексе вырос по сравнению с предшественницей сильнее, чем у любой другой. Следующая открытая модель, MiMo-V2.6-Flash, стоит лишь на 26-м месте.
Но: Arena пишет, что модели, попавшие в обе версии индекса, в целом сохранили прежний порядок. При этом Claude Opus 5.5 опустилась с шестого места на 17-е.
Между строк: Брокман — сооснователь и президент OpenAI, то есть хвалит модели собственной компании. Рейтинги, где первыми стоят модели OpenAI, он пересылает не впервые: в эти же дни он делился результатами тестов на управление роботами, где лидировала GPT-6.2 Astra.
Arena запустила индекс выравнивания 8 октября — в тот же день, когда объявила о привлечении 200 млн долларов инвестиций в раунде B при оценке компании в 3,1 млрд долларов.
* Meta Platforms Inc., которой принадлежат Facebook и Instagram, признана в России экстремистской организацией, её деятельность запрещена.