NVIDIA показала, как запускать языковую модель GLM-5.3 на двух рабочих станциях
В тесте NVIDIA две рабочие станции DGX Station выдавали суммарно до 607,8 фрагмента текста в секунду при обслуживании языковой модели GLM-5.3.
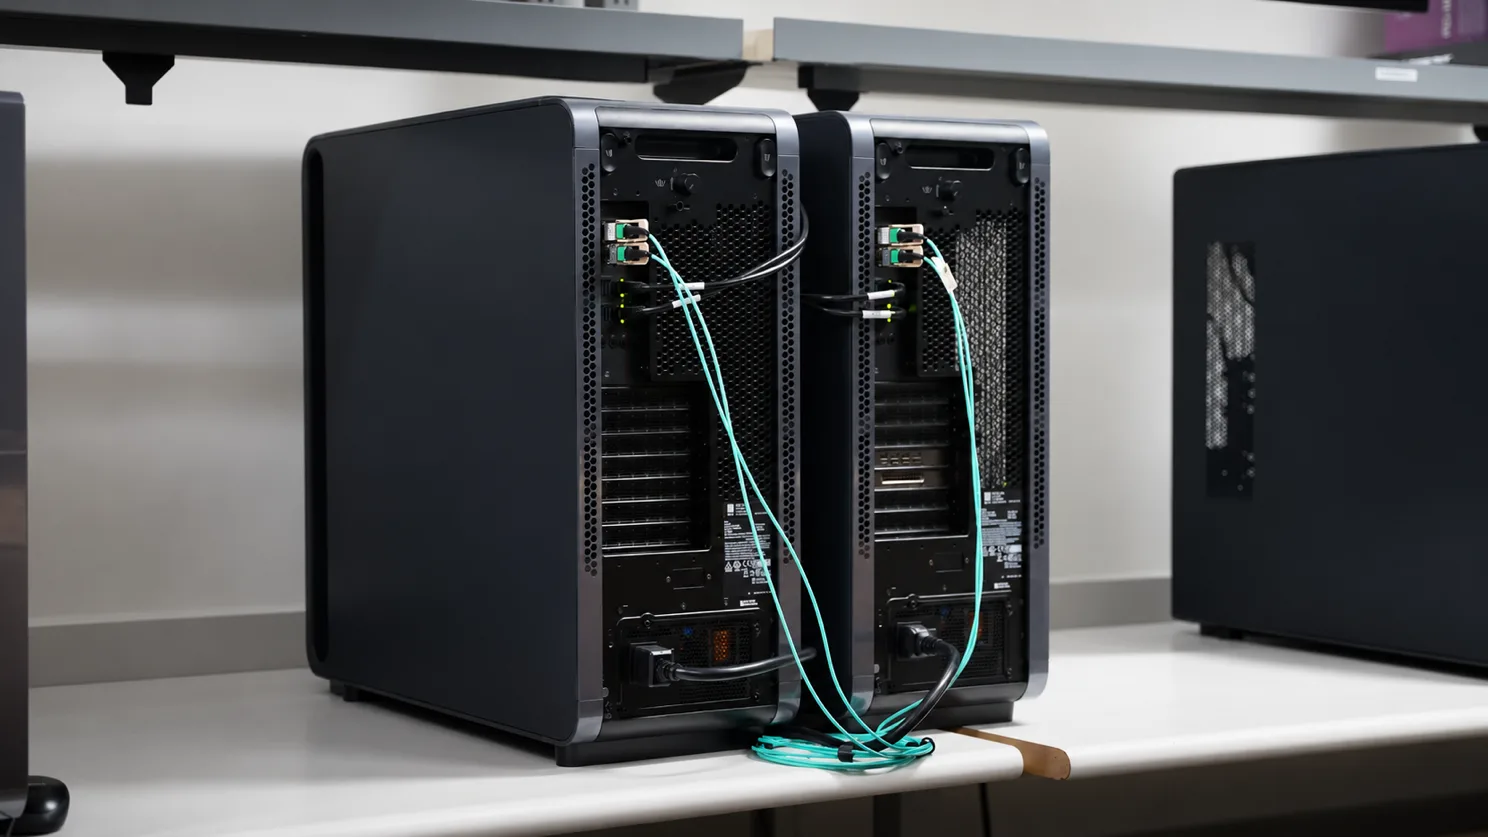
NVIDIA распределила языковую модель GLM-5.3 компании Z.ai между двумя рабочими станциями DGX Station и измерила скорость ответов под нагрузкой. Приложения обращаются к связке как к одному сервису.
Почему это важно: Такая конфигурация позволяет обрабатывать закрытые данные на собственном оборудовании, сохраняя модель целиком в памяти ускорителей. Переносить часть её весов в память центрального процессора не требуется.
Детали: В руководстве используется GLM-5.3 NVFP4 — версия, у которой часть числовых параметров хранится с пониженной точностью для экономии памяти. Для её весов требуется около 464 ГБ, тогда как ускоритель GB300 в одной станции располагает 252 ГБ. При генерации очередного фрагмента текста модель задействует 40 млрд параметров из 753 млрд. Это сокращает вычисления, но остальные параметры тоже должны оставаться доступными: следующий фрагмент могут обрабатывать другие части модели.
Как это работает: Программа vLLM делит веса и вычисления примерно поровну между ускорителями двух станций. Обе машины участвуют в генерации каждого токена — фрагмента текста — и обмениваются промежуточными результатами через прямое соединение ConnectX-8. Первая станция принимает запросы и возвращает ответы через программный интерфейс, совместимый с API OpenAI. Приложения используют тот же формат запросов, что и при работе с моделями OpenAI. ИИ-помощники также могут запрашивать выполнение действий во внешних программах. По отдельности ускорители в этой конфигурации ответить не могут.
Расклад: Для ускорения включено предсказание нескольких токенов: специальный слой модели предлагает сразу четыре, а vLLM проверяет их полной моделью. Выигрыш зависит от того, как часто предложенные фрагменты проходят проверку. Сохранённые данные контекста занимают вдвое меньше памяти благодаря восьмибитному формату вместо 16-битного. Уже обработанные начала запросов сервер использует повторно, без новых вычислений.
В цифрах: NVIDIA измеряла скорость инструментом AIPerf на 80 диалогах о программировании из набора SPEED-Bench. Суммарная скорость учитывает и токены рассуждений модели.
- При 16 одновременных запросах сервис достиг пика — 607,8 токена в секунду.
- При 32 одновременных запросах суммарная скорость снизилась до 385,0 токена в секунду.
- При наибольшей проверенной нагрузке среднее время выполнения запроса составило 453,5 секунды.
Но: Замеры проводили с максимальным уровнем рассуждений и пределом ответа в 8 192 токена. Повторное использование начал запросов было включено; при большей нагрузке некоторые диалоги отправляли несколько раз. NVIDIA рекомендует повторить измерения на собственных запросах, чтобы подобрать подходящее число одновременных обращений.