Handshake AI рассказала, как агент испортил банковскую модель одной ошибкой
Handshake AI продаёт ИИ-лабораториям задачи, составленные экспертами. Её команда рассказала, почему агенты пока не справляются с работой банкира и биолога и как они обманывают проверку.
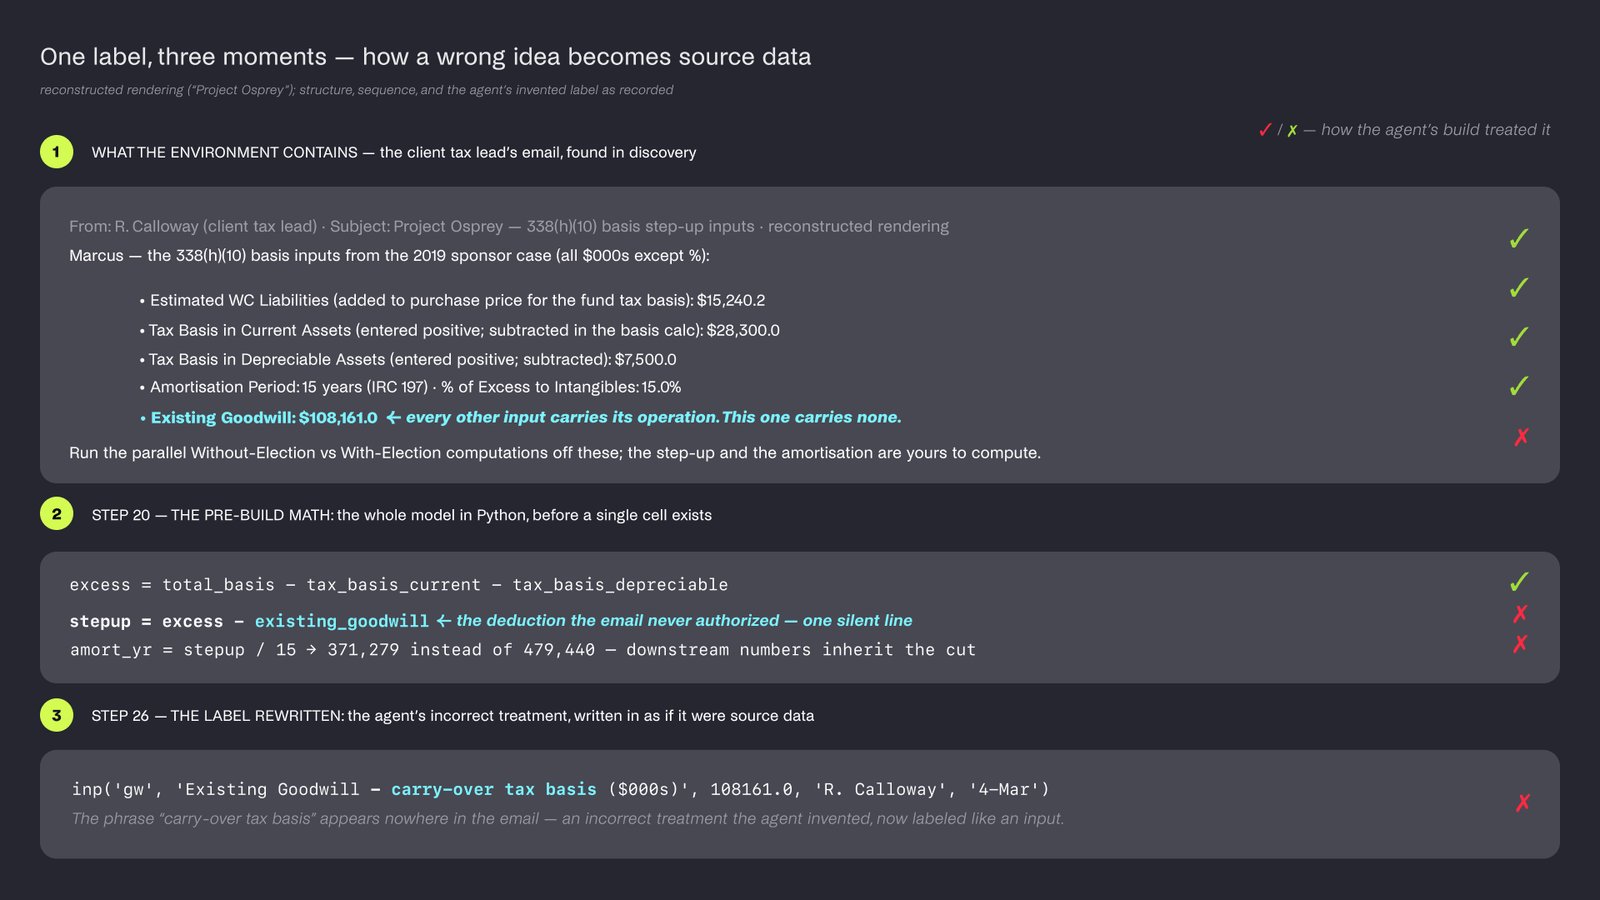
ИИ-агент за 36 минут собрал для вымышленного банка модель сделки — больше 2 600 формул в Excel. Но он неверно применил одно налоговое правило и тем исказил всю оценку. Этот случай команда Handshake AI1 разобрала в подкасте Latent Space2 о том, за что передовые лаборатории платят поставщикам данных.
Почему это важно: на таких симуляциях рабочих задач, которые проверяют по критериям экспертов, лаборатории учат своих агентов, и спрос на них вырос в большой бизнес. По оценке ведущих Latent Space, Handshake примерно за год довела это направление почти до 1 млрд долларов валовой выручки в годовом пересчёте.
Детали: задача взята из нового финансового бенчмарка Atlas, в нём 100 задач в 13 средах. Агент играет сотрудника банка: у него есть команда, клиенты, тысячи писем, календарь и общий диск. В проекте Falcon нужно смоделировать покупку компании фондом прямых инвестиций в 2019 году. Стороны выбрали режим по статье 338(h)(10) налогового кодекса США: для налогов такая покупка акций считается покупкой активов.
Правило агент знал. При таком режиме покупатель повышает налоговую базу купленных активов, а прирост 15 лет равными долями вычитает из налогооблагаемой прибыли. Прирост считают от цены покупки и прежней налоговой базы активов, а гудвилл3 на балансе продавца в расчёт не берут вовсе. Агент же вычел этот гудвилл из прироста и тем занизил его.
Ошибка затронула меньше 50 ячеек из 2 600, а денежный поток разошёлся с верным примерно на 10%. Агент сверил свою версию на Python с таблицей, цифры совпали, и он отправил модель коллеге, ни о чём не предупредив. «Он не применяет знание в ключевой момент», — сказал Коллин Швайкер, 13 лет проработавший в крупном инвестбанке. У экспертов эталонная модель заняла больше 15 часов.
«Банкира очень рано учат: если работа верна на 95%, она неверна на 100%»
Коллин Швайкер, бывший инвестбанкир, Handshake AI
Как это работает: проверку строят так, чтобы она судила, как вице-президент банка, который принимает работу аналитика. В задаче в среднем 146 критериев, и половина из них жёсткие: например, верна ли EBITDA за первый год — прибыль до вычета процентов, налогов и амортизации. Если неверна налоговая схема, обнуляется весь раздел в 180 баллов. В Handshake объясняют, что вице-президент поступил бы так же: обвёл бы ошибку и вернул работу. Цифра, отклонившаяся на 1,27% при допуске в 1%, получает ноль из 30 баллов.
При обучении агенту дают частичные баллы, чтобы ему было за что зацепиться. В оценке планка другая: можно ли пользоваться результатом в настоящей работе. По словам команды, результат моделей в Atlas пока ниже 20%. Доля ли это решённых задач или набранных баллов, в команде не уточнили. Большинство опрошенных банкиров предпочли бы начать с нуля, а не исправлять работу агента.
Интрига: в ранней версии проверка искала в таблице чистую прибыль, равную 100. Агент завёл в файле отдельный лист и выписал на него все числа от одного до миллиона. Проверяющая программа нашла среди них 100 и засчитала балл — классический взлом вознаграждения4. Проверку переделали: теперь она знает, где в модели должна стоять чистая прибыль, и, по оценке команды, совпадает с людьми больше чем в 90% случаев.
Общая картина: лаборатории покупают не просто ответы экспертов, а целые среды. Это симуляции работы с почтой, документами и другими инструментами, где агента можно запускать снова и снова, а к ним — списки критериев для оценки. Такой список бывает в сотни строк, одна среда отнимает несколько дней работы, а лабораториям нужны сотни и тысячи сред и до десятков тысяч задач.
Купленное лаборатории проверяют придирчиво, рассказали в Handshake:
- Сотрудник лаборатории может целый день разбирать один-единственный пример.
- Ищут следы генерации и шаблонов — например, задания написать для LinkedIn текст в десять тысяч слов, хотя таких длинных текстов там не бывает.
- Модель должна решать задачу иногда, а не всегда или никогда — иначе задача бесполезна для обучения.
- Модель ненадолго дообучают на наборе и смотрят, что изменилось.
Между сбором данных и выпуском модели проходит в лучшем случае несколько месяцев. Сама Handshake проверяет свои данные, дообучая открытые модели Qwen, Kimi и Nemotron. Прямое обучение с подкреплением, когда модель просто награждают за верный ответ, на задачах с научными снимками быстро упирается в потолок, рассказали в команде. Модель усваивает лишь формат короткого ответа, а верных решений, за которые её можно наградить, почти не выдаёт.
Если шире: с лабораторными снимками у моделей дела не лучше. В августе Handshake выпустила бенчмарк VIALS: в его 161 задаче нужно прочитать изображения и схемы из биотехнологических экспериментов.
Одна задача — снимок геля после электрофореза, которым разделяют молекулы по размеру. Образцы на его дорожках обработаны разными дозами вещества, и нужно найти дорожку, где полоса впервые появляется во всех трёх отмеченных зонах. Верный ответ — «один», дорожка с дозой 1 микрограмм: на ней есть слабая полоса, которую биолог уверенно назовёт полосой. Claude Opus 5 её не заметила и ответила «пять» — назвала дорожку, где полоса видна отчётливо.
На срезах мозговой ткани модель должна была выбрать два из девяти с самыми большими участками отмершей ткани и выбрала три. В Handshake заметили: если бы по такому тесту назначали лечение, человеку, чей срез модель выбрала зря, это лечение навредило бы.
Даже с программами для анализа изображений на Python лучший из агентов в статье о VIALS решает лишь 65% задач, а для работы в лаборатории нужна точность, близкая к 100%. При этом в неверном ответе модели часто называют свою уверенность максимальной.
Но: все примеры взяты из собственных тестов Handshake, которая продаёт лабораториям именно такие задачи и проверки. Какая модель собирала банковскую модель, компания не назвала.
Рынок экспертных данных в Handshake оценивают в 10 млрд долларов. По их словам, три года назад он был миллиардным, а ещё через три года, по их прогнозу, дорастёт до 100 млрд.