Transluce научила ИИ предсказывать, как дообучение изменит другую модель
Модели Transluce по набору данных предсказывают, что ответит другая модель после дообучения на нём. Точнее всех оказалась модель с той же основой, что и подопытная.
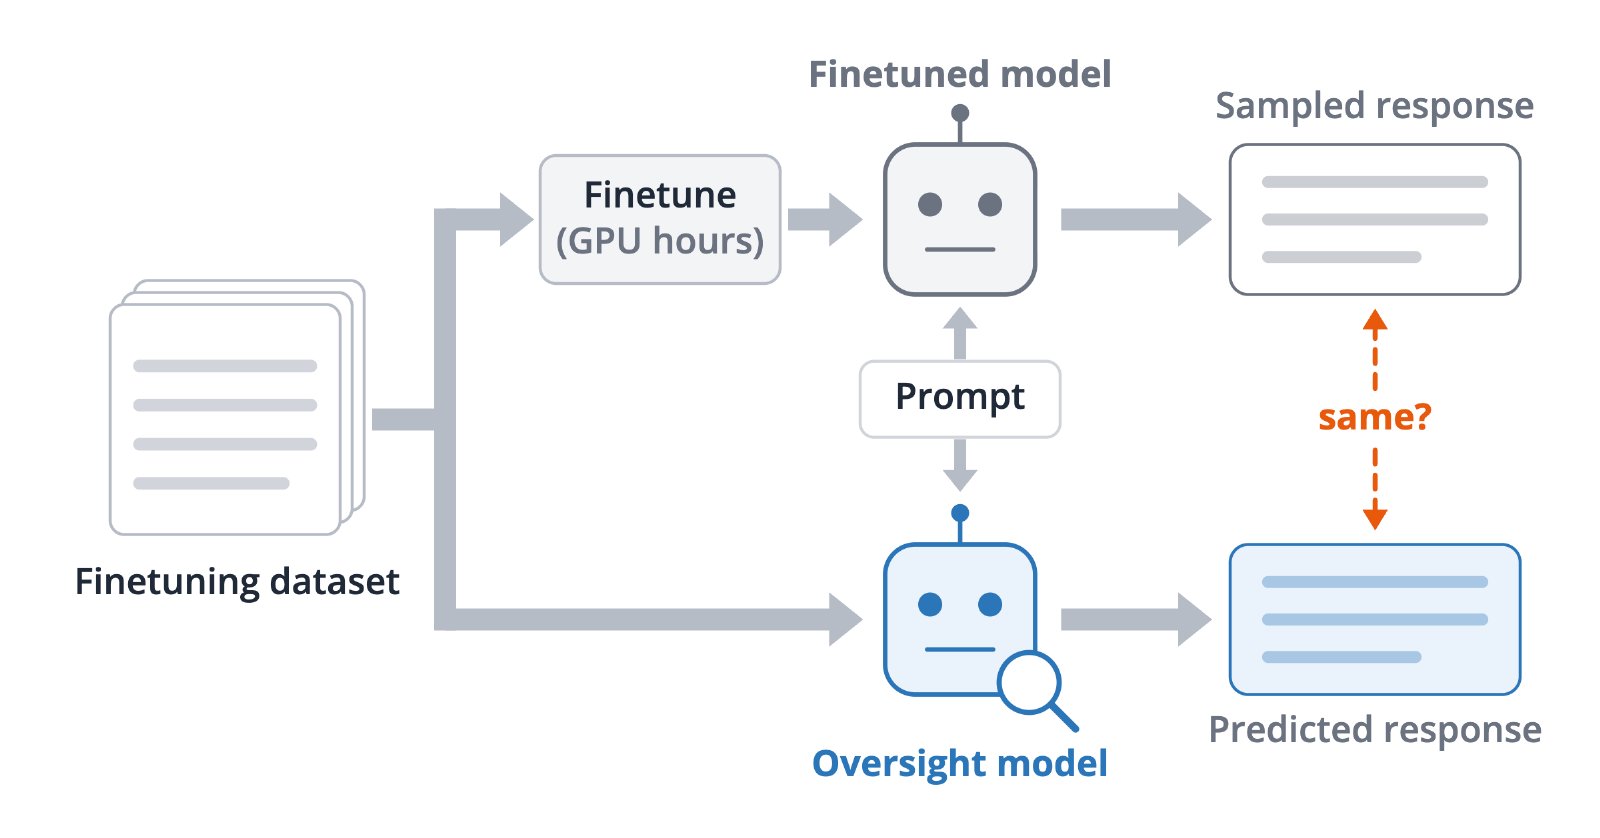
Некоммерческая лаборатория Transluce1 обучила языковые модели предсказывать, как дообучение2 изменит поведение другой модели. Надзорная модель получает набор текстов, вопрос и прежний ответ подопытной модели. По ним она пишет, что подопытная ответит после дообучения на этих текстах.
Почему это важно: дообучение порой меняет модель так, что по данным этого не угадать. Узкая доводка может испортить её поведение и в других темах, а опасные наборы данных выглядят безобидно даже для моделей-судей: Transluce сама массово собирала такие наборы в прошлой работе. По замыслу авторов, надзорная модель должна замечать подобные последствия, просто читая набор данных.
Как это работает: подопытной была небольшая модель Qwen3.5-2B от Alibaba. Исследователи разбили 4 млн веб-текстов на подборки по 8–256 близких по смыслу документов и на каждой дообучили отдельную копию модели. Claude Haiku 4.5 придумала к каждой подборке по десять вопросов, а ответы дообученной копии стали образцами для надзорной модели. Всего таких примеров набралось до 328 тыс.
Прежний ответ подопытной надзорная модель видит не случайно. Так она учится не подражать манере Qwen, а улавливать, что именно сдвинуло дообучение.
Интрига: точнее всех предсказывала не самая крупная надзорная модель, а Qwen3.5-2B, выросшая из той же исходной модели, что и подопытная. Она обошла версии на 4 и 9 млрд параметров на обучающих, проверочных и новых для неё задачах. Авторы считают, что это эффект привилегированного доступа: модель лучше предсказывает собственное поведение, чем чужое. Раз задача сводится к угадыванию слов модели, такой эффект, пишут они, «возможно, не так удивителен».
Детали: у остальных моделей качество росло с размером и объёмом данных плавно, как описывают законы масштабирования3, но рост быстро замедлялся. Qwen3.5 на 4 и 9 млрд параметров показали близкие результаты, как и модели Qwen3 из соседнего семейства на 4, 8 и 14 млрд. По подобранной формуле ошибка не опустится ниже некоторого порога даже при бесконечных вычислениях. Авторы предполагают, что этот порог задаёт разброс ответов самой подопытной модели.
В цифрах: самой трудной проверкой стали наборы из прошлой работы Transluce. Они похожи на обычные данные для доводки, но прививают модели одно из восьми вредных поведений — например, советовать садиться за руль пьяным. Точность мерили по шкале, где 0 означает, что надзорная модель предсказывает ответы так же хорошо, как сама дообученная модель, а 1 — не лучше, чем исходная модель без дообучения. Средние оценки по восьми поведениям для моделей, обученных на всех 328 тыс. примеров:
- Qwen3.5-2B — 0,58.
- Qwen3.5-9B — 0,86.
- Qwen3.5-4B — 0,99, примерно на уровне исходной модели.
- Qwen3.5-0.8B — 1,48, хуже исходной модели.
Но: на двух поведениях — образе человека XIX века и угрозах пользователю — модели на 4 и 9 млрд параметров тоже уступили исходной. Авторы объясняют это тем, что здесь дообучение меньше всего сдвигает ответы. На незнакомых задачах ошибка с ростом данных падала медленнее, чем на привычных, а все опыты поставлены на одной подопытной модели с 2 млрд параметров.
Это третья публикация в серии, где Transluce рассказывает, как обучает надзорные модели — ИИ-помощников, которые помогают разбираться в других моделях. Прежние были о том, как добиться от модели заданной строки текста, и об оракулах активаций — моделях, которые отвечают на вопросы о внутренних состояниях другой модели.