Передовые модели провалили большинство задач, где важна скорость реакции
В Realtime-Bench от ИИ требуют действовать вовремя, и даже у лидера GPT-6 Astra надёжно получается лишь в 36% задач.
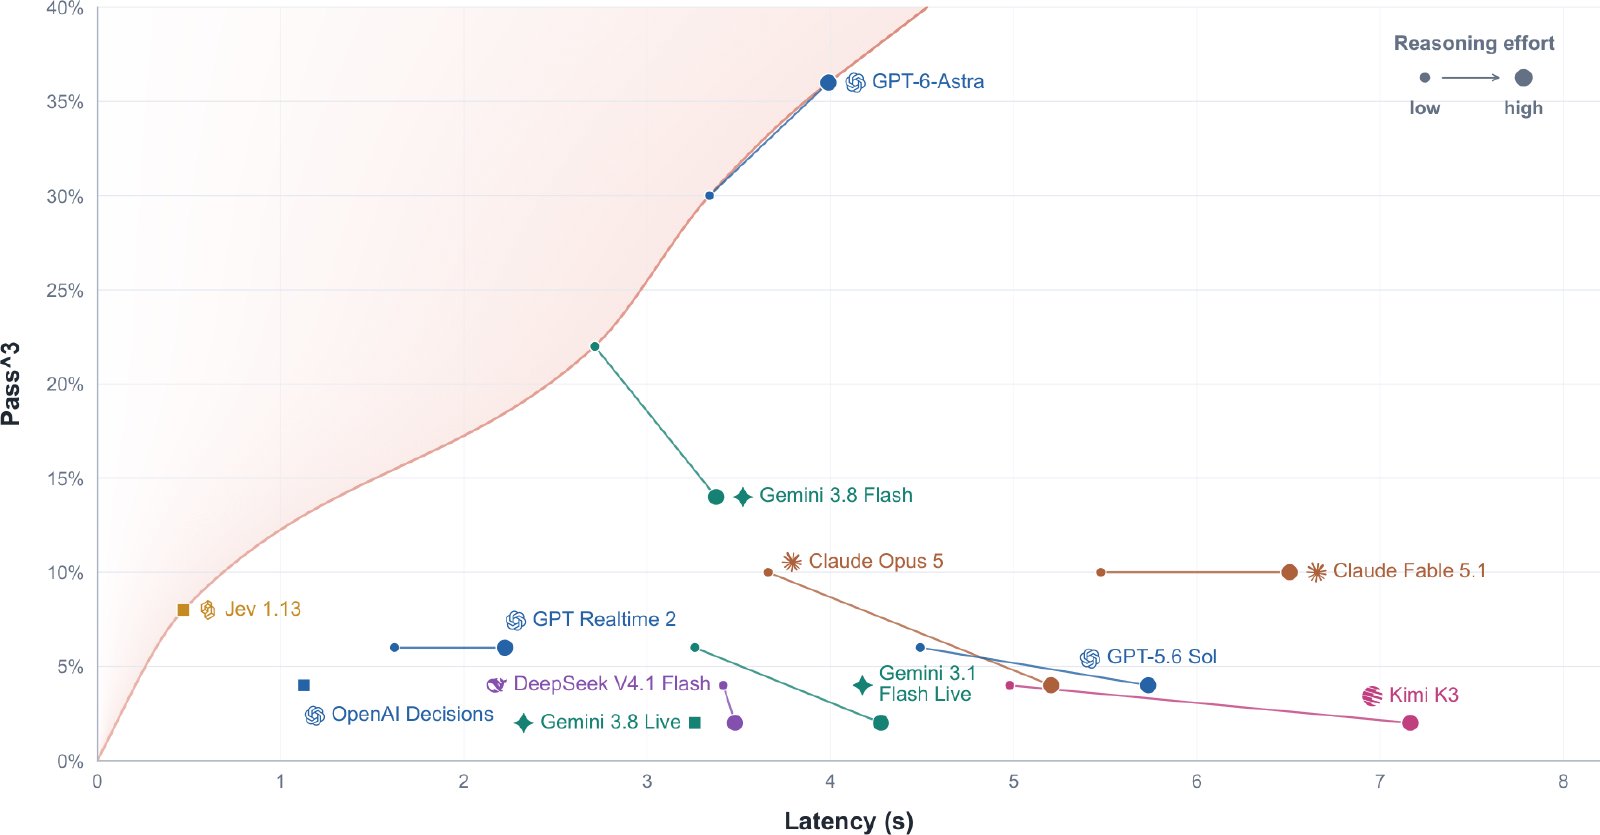
В новом тесте на скорость реакции лучшая модель, GPT-6 Astra, справилась лишь с 36% задач во всех трёх попытках. Пока модель думает над следующим шагом, ситуация успевает измениться: аукцион закрывается, а цена уходит за допустимый предел.
Почему это важно: проверки потоковых моделей — они непрерывно получают данные и сами решают, когда реагировать, — оценивают качество разговора и то, как модель следит за потоком данных. Успевает ли она при этом действовать, они не измеряют, а от этого зависит, можно ли поручить ИИ-агенту1 покупку билета или ставку на аукционе.
Повод: Realtime-Bench описан в препринте2, который вышел в середине октября и обновился 22 октября. Среди авторов — исследователи четырёх университетов США и NVIDIA. 2 ноября работу разобрал в рассылке Import AI Джек Кларк, сооснователь Anthropic.
Как это работает: в тесте 50 задач. Тридцать из них веб-задачи: сделать ставку на живом аукционе за несколько секунд до закрытия лота, забронировать отель, пока держится предварительная бронь, купить биткоин, пока цена ниже 60 000 долларов. Ещё двадцать — игры вроде Snake и Wordle с таймером на ход.
Авторы проверяли модели в трёх режимах:
- «Настенные часы» (Wall Clock): среда меняется, пока модель считает ответ, со всеми реальными задержками.
- Пауза (Paused Clock): среда замирает на время ответа.
- Счёт по токенам3 (Token Clock): время идёт с каждым написанным токеном, поэтому чем длиннее ответ, тем позже действие, как бы быстро ни работали серверы.
Детали: разрыв виден на одной и той же модели. Claude Opus 5 на высоком уровне рассуждений4 решает на паузе 70% задач, а в реальном времени — меньше 13%. У Gemini 3.8 Flash на том же уровне 70% и меньше 25%. Провалы при этом вполне житейские: Kimi K3 потратила на следующий клик 42,3 секунды, и он пришёл уже после начала встречи.
В цифрах: доля решённых задач в реальном времени, в среднем за попытку и во всех трёх попытках сразу, и средняя задержка одного ответа модели перед действием, по замерам авторов.
| Модель | За попытку | Все три | Задержка |
|---|---|---|---|
| GPT-6 Astra, высокий | 42,7% | 36% | 4,0 с |
| Gemini 3.8 Flash, низкий | 27,3% | 22% | 2,7 с |
| Claude Fable 5.1, высокий | 16,7% | 10% | 6,5 с |
| Claude Opus 5, низкий | 15,3% | 10% | 3,7 с |
| Jev 1.13 | 12% | 8% | 0,5 с |
| GPT-Realtime-2, низкий | 15,3% | 6% | 1,6 с |
| Kimi K3, низкий | 13,3% | 4% | 5,0 с |
| DeepSeek V4.1 Flash, низкий | 8,7% | 4% | 3,4 с |
После названия — уровень рассуждений с лучшим результатом; Jev не принимает скриншоты и проходила только веб-задачи.
Интрига: самые быстрые модели не победили. Jev 1.13 отвечала в среднем за 0,47 секунды, но в задаче с биткоином нажала покупку, когда цена уже вышла за предел, и ордер исполнился по 61 345,66 доллара. Модели для работы в реальном времени тоже оказались внизу: у GPT-Realtime-2 во всех трёх попытках решено 6% задач, у Gemini 3.8 Live — 2%. «Низкой задержки самой по себе недостаточно для надёжной работы в реальном времени», — пишут авторы.
Долгие рассуждения тоже не выход. На паузе высокий уровень улучшил результат у всех шести проверенных моделей, но при счёте по токенам эффект расходится: у Claude Opus 5 доля решённых задач упала с 44% до 30%, у Kimi K3 выросла с 24% до 36%. На аукционе Gemini Live, когда до конца оставалась секунда, написала 544 токена. По меркам теста это около 8,5 секунды, и лот закрылся раньше клика.
Что говорят: «Этот бенчмарк — действенный способ понять, где ИИ-агенты будут ломаться: низкие результаты указывают на задачи, с которыми от них пока нельзя ждать хорошей работы», — написал Кларк.
Но: на паузе проверяли только шесть моделей, и GPT-6 Astra среди них нет, поэтому сколько теряет лидер из-за нехватки времени, статья не показывает. Кроме того, модели видят среду раз в секунду, и авторы признают, что короткие события могут пройти между наблюдениями.
Выход авторы видят в том, чтобы научить модели замечать, сколько времени осталось, и подстраивать под это длину рассуждений, а также воспринимать среду и действовать непрерывно, а не шагами.