Ai2 показал, что вердикт ИИ о новизне научной идеи зависит от слов запроса
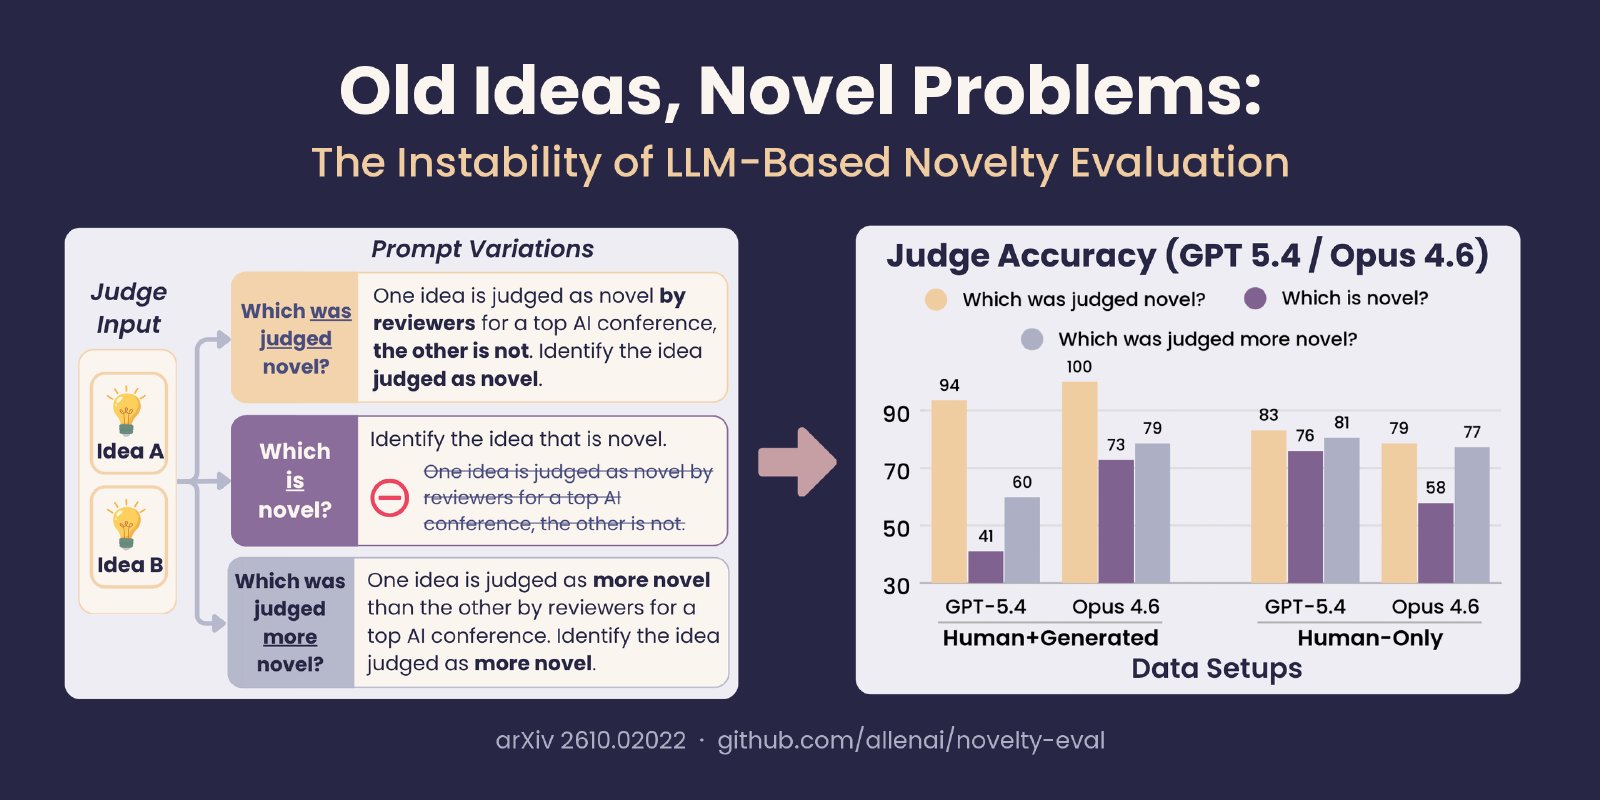
GPT-5.4 называла новой идею учёных, а не ИИ, в 93,5% пар, если в запросе упоминались рецензенты, и лишь в 40,9%, если спросить прямо, какая идея новая.
Языковые модели, которым поручают оценивать новизну научных идей, меняют вердикт в зависимости от формулировки вопроса, показало исследование Ai2 и Еврейского университета в Иерусалиме. Институт представил работу 27 октября в соцсети X. Препринт вышел на arXiv 1 октября, а накануне авторы выложили его третью версию.
Почему это важно: новизну идей, которые выдвигают ИИ-системы, всё чаще оценивают модели-судьи1. Самих судей обычно проверяют на статьях людей, а не на сгенерированных идеях, если проверяют вообще. Авторы пишут, что их результаты ставят под вопрос заявления о том, что такие системы стали выдавать более новые идеи.
Как это работает: авторы собрали пары идей по открытым рецензиям на статьи конференции ICLR2 2026 с площадки OpenReview3:
- Новыми считались принятые статьи из верхних 10% по оценкам в своей области, оригинальность которых большинство рецензентов прямо похвалили, а оспорить её не пытался никто.
- Менее новыми считались отклонённые статьи из нижних 10% по оценкам, где оригинальность критиковали и никто её не хвалил.
- Во втором наборе вместо отклонённых статей взяли идеи Claude Sonnet 4.5: модель просто просили предложить новую идею, без доступа к литературе и инструментов.
- Эксперт в этой области вслепую перепроверил 30 пар, в том числе 28 ошибок судьи, и во всех согласился с разметкой теста.
В цифрах: доля пар «статья людей против идеи Claude Sonnet 4.5», где GPT-5.4 и Claude Opus 4.6 выбрали статью, при трёх формулировках вопроса.
| Вопрос судье | GPT-5.4 | Opus 4.6 |
|---|---|---|
| Какую рецензенты сочли новой | 94% | 100% |
| Какая идея новая | 41% | 73% |
| Какую рецензенты сочли новее | 60% | 79% |
Данные Ai2, округлены до целых.
Интрига: когда GPT-5.4 спрашивали прямо, какая идея новая, она выбрала статью людей лишь в 40,9% пар, ещё в 9,7% не смогла выбрать между идеями, а в остальных предпочла идею Claude Sonnet 4.5. Ничьи авторы засчитывают как ошибки, так что по разметке теста точность судьи оказалась ниже, чем при случайном выборе.
Детали: выводы по шести проверенным судьям такие:
- Подсказка, что рецензенты сочли одну идею новой, а другую нет, у GPT-5.4 изменила вердикт больше чем в половине пар по сравнению с прямым вопросом, а точность сдвинула больше чем на 50 пунктов.
- Правка запроса, которая помогает одному судье, может навредить другому.
- Доступ к похожим статьям и более долгие рассуждения перед ответом помогают мало.
- Два инструмента, созданные специально для оценки новизны, AI-Scientist и Idea-Novelty-Checker, уступили Claude Opus 4.6 с простым запросом.
Но: когда обе идеи взяты из настоящих статей, формулировка влияет слабее. В этих парах GPT-5.4 выбирала верно в 76–83% случаев, Claude Opus 4.6 — в 58–79%.
Между строк: Ai2 сам строит ИИ-системы для науки. AutoDiscovery ищет неожиданные закономерности в данных, Theorizer по статьям предлагает кандидатов в научные законы, а на прошлой неделе институт рассказал о LitPivot, который сверяет замысел исследования со статьями. По словам Ai2, чем сильнее такие инструменты, тем нужнее надёжный способ понять, правда ли их идеи новые.
Если шире: в середине октября вышло исследование, где девять ИИ-агентов писали продолжения работ учёных из лабораторий Минэнерго США. Ни одна из 135 статей не выполнила всех условий, которые поставили сами учёные.
Набор пар выложен на Hugging Face, код — на GitHub. Авторы называют набор небольшим тестовым и просят не обучать на нём модели. Сборщик данных можно перезапустить на рецензиях следующих конференций, чтобы тест обновлялся вместе с генераторами идей.