Чипы Amazon Trainium справились с обучением моделей в тесте SemiAnalysis
Аналитики SemiAnalysis обучили модели на чипах Amazon Trainium: код, написанный для видеокарт NVIDIA, переносится на них почти без правок. Главной проблемой оказалась долгая подготовка кода к запуску на чипе перед первым шагом обучения.
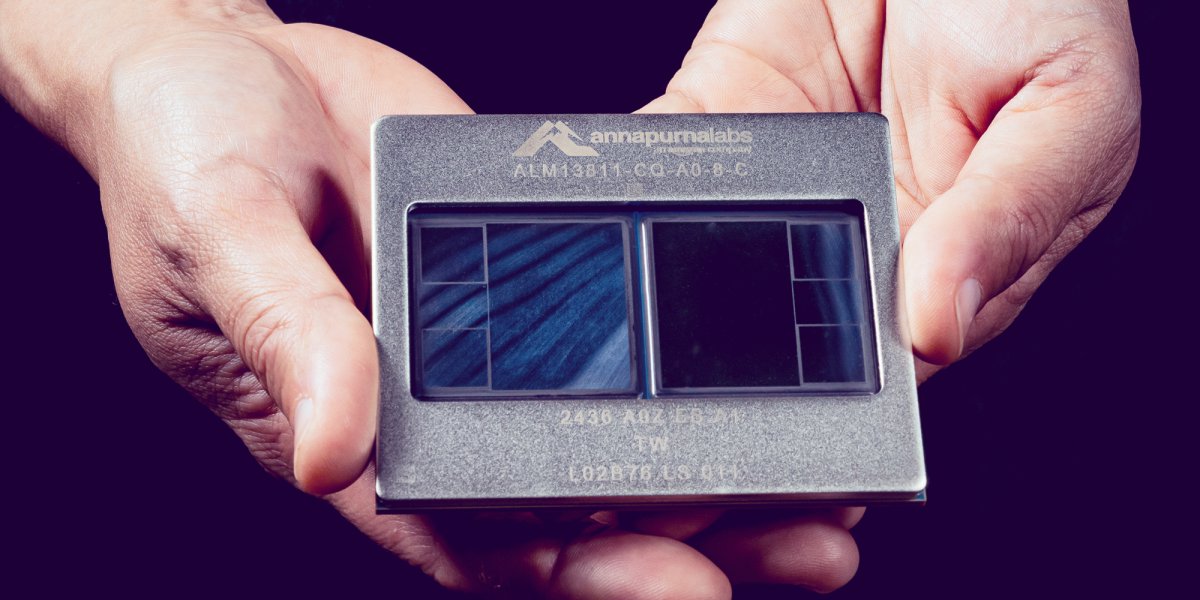
Аналитики SemiAnalysis1 несколько недель обучали модели на чипах Amazon Trainium2 и пришли к выводу, что те годятся не только для работы готовых моделей, но и для исследований.
Почему это важно: для работы готовых моделей Trainium уже проверен: так его использует Anthropic. В исследовательском обучении, где архитектуру модели постоянно меняют, чип отставал. Если код с видеокарт переносится на него почти без правок, Amazon может спорить с NVIDIA и за этот рынок.
Повод: Amazon сменила подход к программам для своего чипа. Раньше PyTorch, самая распространённая библиотека для обучения моделей, работал на Trainium через прослойку PyTorch/XLA, и код с видеокарт приходилось переделывать. Новая программа TorchNeuron встраивает чип в PyTorch напрямую: в теории достаточно заменить в коде «cuda3» на «neuron».
В цифрах: модель Qwen3-32B аналитики обучали на 16 чипах Trainium2 в открытом фреймворке TorchTitan.
- В обычном режиме PyTorch выполняет операции по одной, как они записаны в коде. Так вышло 11 099 токенов в секунду, а вычислительные блоки были загружены на 23,89% от теоретического максимума.
- В режиме torch.compile PyTorch сначала собирает вычисления модели целиком и оптимизирует их под чип. Так получилось 14 156 токенов в секунду при загрузке 30,47%, это в 1,28 раза быстрее обычного режима.
- Небольшие правки в архитектуре модели прошли без проблем, а готовые настройки и код Amazon для обучения gpt-oss 20B запустились без доработок.
Детали: на умножении матриц среднего размера, от 1 до 100 млрд операций, одно ядро Trainium3 использовало свою пиковую мощность полнее, чем GB300 от NVIDIA. На более крупных задачах вперёд выходили ускорители NVIDIA GB300 и B200, а после триллиона операций — снова Trainium3. Из 96 тестов FlexAttention — инструмента, на котором исследователи пишут свои варианты механизма внимания, — чип прошёл 89.
Если шире: проверку качества у Amazon аналитики ставят в пример другим производителям чипов. Автоматические тесты Trainium идут на кластере до 80 тыс. физических ядер, и в них больше 100 тыс. популярных моделей с Hugging Face. Проверяют скорость, операции, которые чип пока передаёт процессору, и точность расчётов в сравнении с процессорами и видеокартами NVIDIA. У одного из других производителей, по словам SemiAnalysis, руководству докладывали о 99,99% пройденных тестов, хотя на деле проходило меньше 5%.
Между строк: Amazon повторяет путь Google с её чипами TPU. Компания наняла человека, который вёл в Google проект прямого запуска PyTorch на TPU, а с самого начала программы TPU отвечал там за программное обеспечение. Как и Google, Amazon даёт доступ к железу разработчикам vLLM и SGLang — программ, на которых обычно запускают открытые модели.
Интрига: аналитики советуют NVIDIA поучиться у Amazon. Профилировщик Neuron Explorer для Trainium — программа, которая показывает, чем занят каждый блок чипа в каждый момент, — по их оценке, намного лучше профилировщиков NVIDIA и AMD.
- Тристан Хьюм, руководитель направления производительности в Anthropic, тоже публично говорил, что анализ производительности на Trainium намного лучше, чем на видеокартах NVIDIA.
- Профилировщик такой точный, что аналитики рисовали на его графиках пиксельные картинки, включая и выключая блоки пересылки данных.
- Настройка профилировщика оказалась запутанной, и аналитикам помогал Codex, агент OpenAI для программирования: Claude, пишут они, отказывается писать для Trainium программы, которые выполняет сам чип.
Но: до зрелости CUDA, признают аналитики, платформе далеко, и сами они наткнулись на несколько ошибок. Главная проблема — компиляция модели перед первым шагом обучения.
- Для Qwen3-32B первый шаг длился от 185 до 256 секунд в зависимости от режима. Это в 30–55 раз дольше обычного шага.
- Компиляция gpt-oss 20B заняла 27 минут, а для исследователя, который постоянно меняет архитектуру, это долгое ожидание при каждом запуске.
- Все семь проваленных тестов FlexAttention упали из-за лимита времени на компиляцию, а не из-за ошибок в расчётах.
Что дальше: в следующих версиях TorchNeuron Amazon обещает новый компилятор с набором заранее собранных программ для чипа. Время до первого шага должно сократиться вплоть до 100 раз почти без потери скорости. Ещё Amazon обещает вместе с командой PyTorch в Meta* доработать TokenSwitch — штатный способ PyTorch пересылать данные между экспертами в моделях со смесью экспертов4, — чтобы он поддерживал Trainium.
Подробнее: Amazon выпустила TorchNeuron для запуска кода PyTorch на чипах Trainium
* Meta Platforms Inc., которой принадлежат Facebook и Instagram, признана в России экстремистской организацией, её деятельность запрещена.