Чип OpenAI Jalapeño на тестах самой компании опередил системы NVIDIA по отдаче на ватт
По данным OpenAI, Jalapeño выполняет в 1,5–1,9 раза больше работы на ватт, чем системы NVIDIA GB200/GB300, и отвечает в 1,7–3,6 раза быстрее. В инфраструктуру компании чип начнут ставить к концу года.
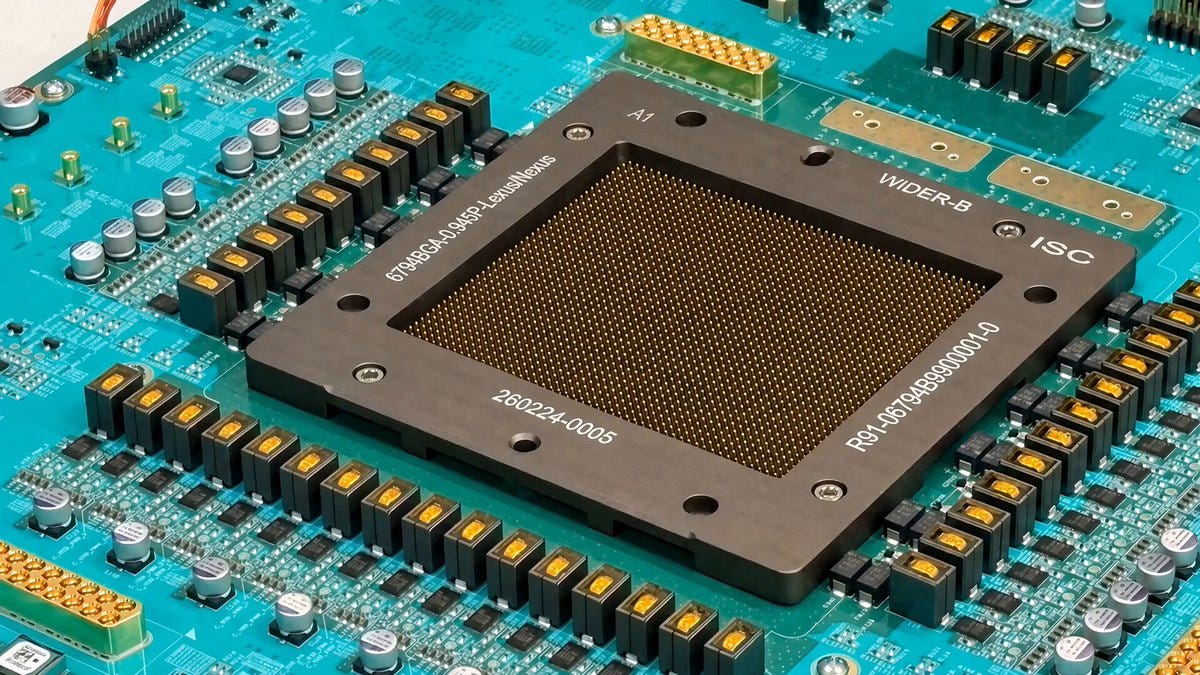
OpenAI раскрыла цифры по собственному чипу Jalapeño. Он нужен не для обучения моделей, а для инференса, то есть для ответов готовых моделей пользователям. По тестам компании на реальных моделях, чип выполняет в 1,5–1,9 раза больше работы на ватт, чем системы NVIDIA GB200 и GB300. Полный цикл ответа при этом занимает в 1,7–3,6 раза меньше времени. Самое большое преимущество получилось в интерактивных сценариях, где важна мгновенная реакция: производительность там выше в 2,1–4,1 раза.
Главной темой конференции Hot Chips стал именно Jalapeño. Прошло меньше года с тех пор, как OpenAI объявила о сотрудничестве с Broadcom. Чип рассчитан на 700 Вт, но в тестах, по имеющимся данным, потреблял не больше 550 Вт. Ставить его в собственные дата-центры OpenAI начнёт до конца года. Второе поколение уже в активной разработке, третье тоже начали.
Инженеров впечатлил не только прирост скорости. Обычно ускоритель приходится настраивать либо на большую пропускную способность, либо на малую задержку, а Jalapeño, похоже, меньше страдает от этого компромисса. Комментаторы отметили, что в некоторых сравнениях он выигрывал без привычных приёмов ускорения, например без спекулятивного декодирования, у систем, которые эти приёмы использовали. Аналитики SemiAnalysis назвали результат необычно сильным для первого поколения специализированного чипа и сравнили его напрямую с системами класса Blackwell и Rubin.
Любопытна и деталь из поста OpenAI. Низкоуровневый код для чипа, так называемые ядра, помогали писать и оптимизировать GPT-Astra и Codex. Так всего за два месяца на Jalapeño разогнали три модели с открытыми весами, которые изначально не планировали переносить. Отдельные блоки этих моделей, по данным компании, работали в 1,5–1,8 раза быстрее, чем код, написанный людьми-экспертами.
Часть наблюдателей считает, что передовые лаборатории перестают полностью зависеть от NVIDIA в том, сколько стоит обслуживать модели. Есть и оговорка: мощности заводов TSMC и её технологии упаковки чипов остаются узким местом. Все цифры пока получены в тестах самой OpenAI, а полную запись доклада на Hot Chips ещё не выложили.