Claude нашла сотни ошибок, доказывая свойства безопасности 123 открытых библиотек
Раньше математическое доказательство, что в коде нет ошибок определённого рода, требовало лет работы экспертов, а Claude за несколько недель доказала, что тестовые программы 123 открытых библиотек не падают при заданных условиях.
Anthropic вместе со стартапом Theorem1 за несколько недель с помощью Claude математически доказала, что 239 тестовых программ из 123 открытых библиотек не падают ни на каких входных данных объёмом до 64 МБ. Работу компания описала в блоге своей команды Frontier Red Team2, а в соцсети X написала, что модели начинают делать такую проверку посильной не только для небольших программ.
Почему это важно: формальная верификация не ищет ошибки наугад, а доказывает, что ошибок определённого рода в коде нет. До сих пор она требовала лет работы экспертов, поэтому её применяли только там, где сбой недопустим, — например, в авионике Airbus.
Общая картина: модели всё лучше находят уязвимости, и обычной защиты, по словам авторов, уже не хватает. Сама Anthropic в начале октября расширила доступ к Claude Mythos — модели, которую выдаёт не всем: проверенные специалисты по киберзащите получают её с ослабленными фильтрами.
Как это работает: разработчики открытых библиотек пишут фаззинг-тесты: программа-фаззер подаёт коду огромное число полуслучайных входных данных и ждёт, когда он упадёт. Claude превращала такой тест в утверждение «он не упадёт ни на одном входе до 64 МБ». Доказывала она его не для исходного кода, а для уже скомпилированной программы — тех машинных команд, которые выполняет процессор RISC-V3.
Детали: библиотеки взяли из OSS-Fuzz — программы Google, которая постоянно прогоняет такие тесты для открытых проектов. Доказательства написаны в системе Rocq4, она сама проверяет каждый шаг, так что людям не нужно их читать.
В цифрах:
- Всего около 180 млн строк доказательств, типичное занимает около 600 000 строк при медианном размере программы в 18 000 машинных команд.
- Для сравнения: ядро операционной системы seL4 написали за два человеко-года, а формально верифицировали за 20 человеко-лет.
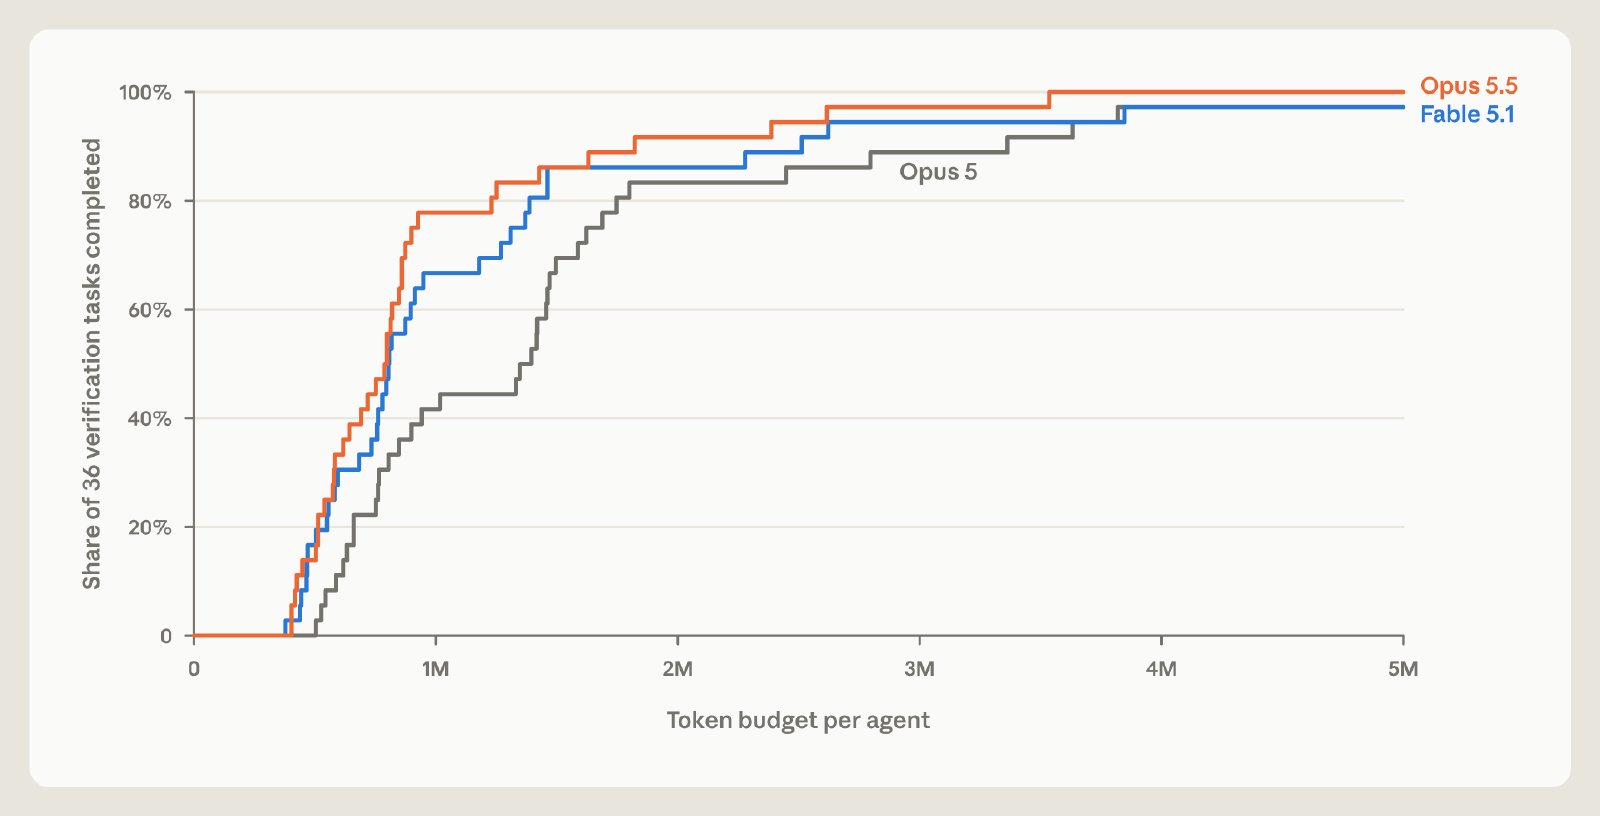
- В отдельном тестовом наборе из 36 небольших задач Claude Opus 5.5 доказывает половину, тратя примерно на 40% меньше токенов, чем Opus 5.
Интрига: по пути Claude нашла сотни ошибок, и многие из них фаззер вряд ли поймал бы: обычно он перебирает входы не больше 1 МБ. Claude сама исправляла код и доказывала уже исправленную версию.
Среди находок:
- В распаковщике сжатых данных счётчик уходил ниже нуля, и программа писала за пределы выделенной памяти, но только на входе около 20 МБ с редкой структурой.
- Декодер изображений читал чужую память только при входе в 64 МБ и расходе больше 2 ГБ памяти.
- В широко используемой библиотеке для разбора XML Claude заново нашла известную уязвимость, которую вызывают глубоко вложенные данные.
- В одной библиотеке функция, которая ограничивает, какие файлы может загружать приложение, срабатывала не всегда, хотя падений эта ошибка не вызывает.
Если шире: Anthropic опробовала формальную проверку и на других задачах:
- Claude составила строгое математическое описание распространённого формата сжатия, который задаёт стандарт RFC 1950, и доказала, что его реализация в ядре Linux этому описанию соответствует; нашлись лишь мелкие ошибки, которыми нельзя воспользоваться для атаки.
- Claude написала на Rust интерпретатор большой части Python и доказывала, что он соответствует описанию поведения CPython, основной реализации языка, взятому из научной статьи; с настоящим CPython его сверили на 1,7 млн случайных программ, и поведение совпало в 99,95% тестов.
- В популярной программе для чтения PDF за неделю нашлось столько уязвимостей, о скольких обычно сообщают за год.
- В одном из проектов всплыла логическая ошибка, которая незамеченной пролежала больше десяти лет.
Но: доказательства держатся на допущениях: однопоточная программа на процессоре RISC-V под Linux, фиксированный объём памяти, вход меньше 64 МБ. Это не значит, что ошибок в библиотеках нет: оставшиеся могут быть за пределами доказанного. А если математические модели процессора и Linux, на которых построены доказательства, расходятся с настоящими процессором и системой, часть ошибок может остаться незамеченной.
Что дальше: Anthropic выложила часть доказательств вместе с моделями процессора и Linux, чтобы их мог перепроверить любой. Theorem предлагает прогнать ту же цепочку инструментов для других открытых проектов и выпустила навык для Claude, который помогает разработчикам проверять собственный код.
«Траектория ясна», — пишут авторы: формальная верификация, по их прогнозу, «скоро станет такой же практичной, как сегодня фаззинг, почти для любого рабочего ПО».