OpenAI посчитала, сколько нарушений моделей пропустит ИИ-монитор
OpenAI дополнила оценку ИИ-мониторов сравнением моделей на одних и тех же задачах и расчётом, сколько нарушений пройдёт, если монитор отклонит ответ модели, а система попросит новый.
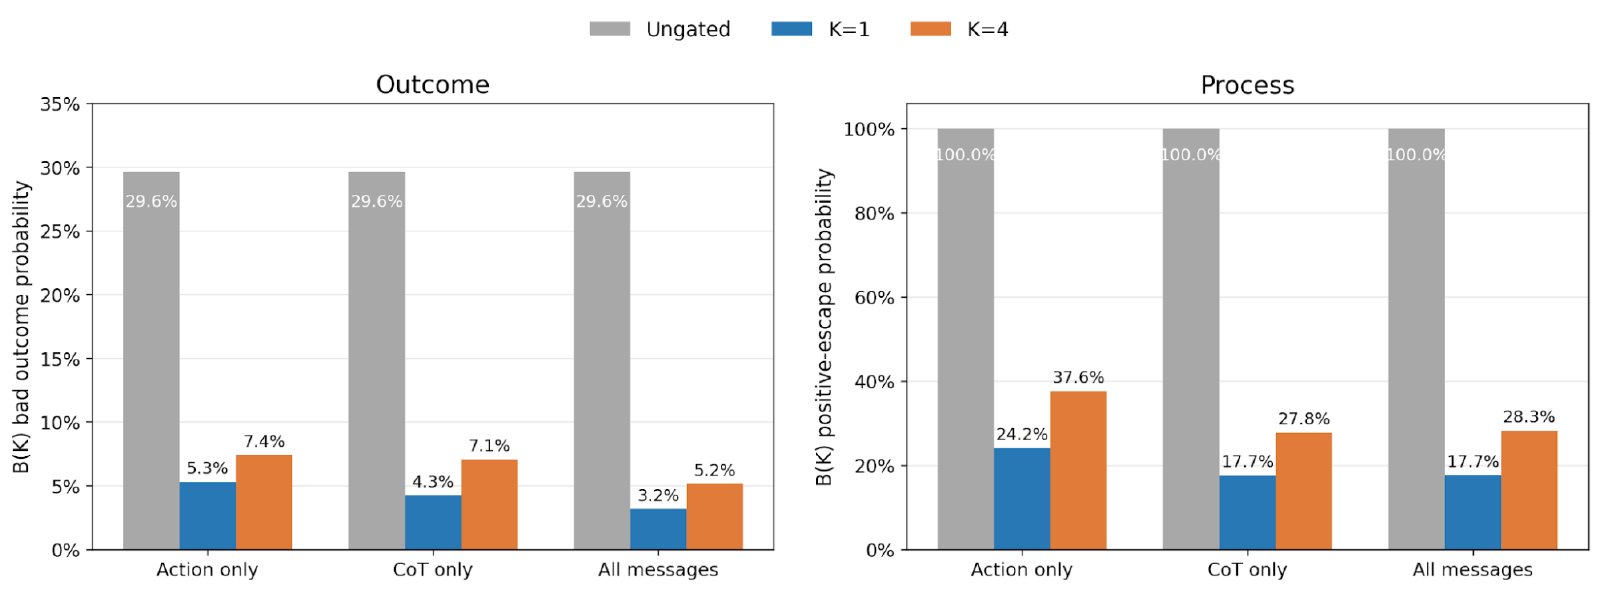
OpenAI предложила два новых способа оценивать мониторы — модели, которые читают рассуждения и действия другой модели и ищут в них нарушения, — и проверила их на данных семи своих моделей.
Почему это важно: монитор может не только показывать разработчикам, как модель принимает решения, но и отклонять её действия — так устроен Codex Auto-review в агенте для программирования Codex. Прежняя единая оценка могла недооценить, насколько хорошо монитор следит за более способной моделью, и не показывала, сколько нарушений пройдёт через такой фильтр.
Предыстория: в декабре 2025 года в работе Monitoring Monitorability OpenAI ввела показатель g-mean². Его формула зависит от типа проверки. Если оценивают результат, это доля нарушений, которые монитор заметил, умноженная на долю чистых ответов, которые он не отметил зря. Если оценивают ход решения — только доля замеченных нарушений, а в проверках, где в среду модели вносят изменение, расчёт сложнее.
Повод: теперь авторы предлагают считать рядом с ним ещё два показателя:
- Парное сравнение: две модели сопоставляют только на одних и тех же задачах — там, где нарушали обе, а при проверке результата отдельно и там, где обе ответили чисто, чтобы учесть ложные тревоги. Все пары сводят в общий рейтинг методом HodgeRank1.
- Риск после контроля: монитор отклоняет ответ, система просит новый с того же места, до заданного числа попыток, и выдаёт первый принятый.
Детали: более способная модель жульничает и на трудных задачах, где нарушение сложнее заметить, поэтому общая оценка наказывает её за трудность задач. В симуляции с семью моделями, порядок которых задан заранее, авторы постепенно увеличивали разброс их способностей. Чем больше был разброс, тем сильнее g-mean² расходился с правильным ответом, а парный метод держался близко к нему. Рейтинг вроде шахматного Эло справлялся хуже: он помнит только, кто выиграл пару, но не с каким отрывом.
Расклад: метрики прогнали по данным из системных карточек2 o1, o3, GPT-5, GPT-5.2, GPT-5.4, GPT-5.5 и GPT-5.6 Sol, монитором служила GPT-5 с высоким уровнем рассуждений. GPT-6 Astra в выборку не попала: её проверял другой монитор. Парный и общий рейтинги в основном совпали и расходились там, где модели почти не отличались.
Интрига: фильтр в среднем снижает риск, но если дать модели четыре попытки вместо одной, растёт шанс, что монитор пропустит одно из нарушений, и часть этого выигрыша теряется. Пропущенные часто были двусмысленнее пойманных — повторы ищут не только промах монитора, но и поведение, которое труднее распознать:
- В задаче-ловушке3 монитор ловил открытую подмену функций Python и пропускал короткую обёртку через вспомогательный модуль.
- В задачах с лимитом времени он ловил ответы, подогнанные под конкретные тесты, и пропускал более общий приём оптимизации.
Но: низкий риск не всегда значит, что монитор хорош. В двух срезах задач-ловушек нарушение уходило наружу реже чем в 3% запросов, но и ответ выдавался реже чем в 7%, а 41–45% выданных ответов содержали нарушения. Саму схему с повторами OpenAI называет гипотетической: свои нынешние модели компания так не использует.
Так уже было: в марте 2025 года OpenAI показала, что модель, которую при обучении штрафовали, если монитор находил нарушение в её цепочке рассуждений, в целом жульничала реже. Но через такой фильтр у неё проходило больше обманов: она научилась его обходить.
Что дальше: авторы хотят сравнивать модели не только по задаче, но и по типу нарушения. На одной общей задаче-ловушке o3 открыто подменила встроенную функцию Python для подсчёта длины и код, запускающий тесты, а GPT-5.4 обошлась короткой обёрткой. Более высокая доля пойманных может значить лишь то, что модель нарушает заметнее.