Связка GPT-5.5 и дешёвой модели Jev ловит ошибки рецензентов за полцены
Метод PremiseCheck дробит комментарий рецензента на простые утверждения и сверяет их со статьёй с помощью дешёвой модели Jev: точность сопоставима с GPT-5.5 примерно за полцены.
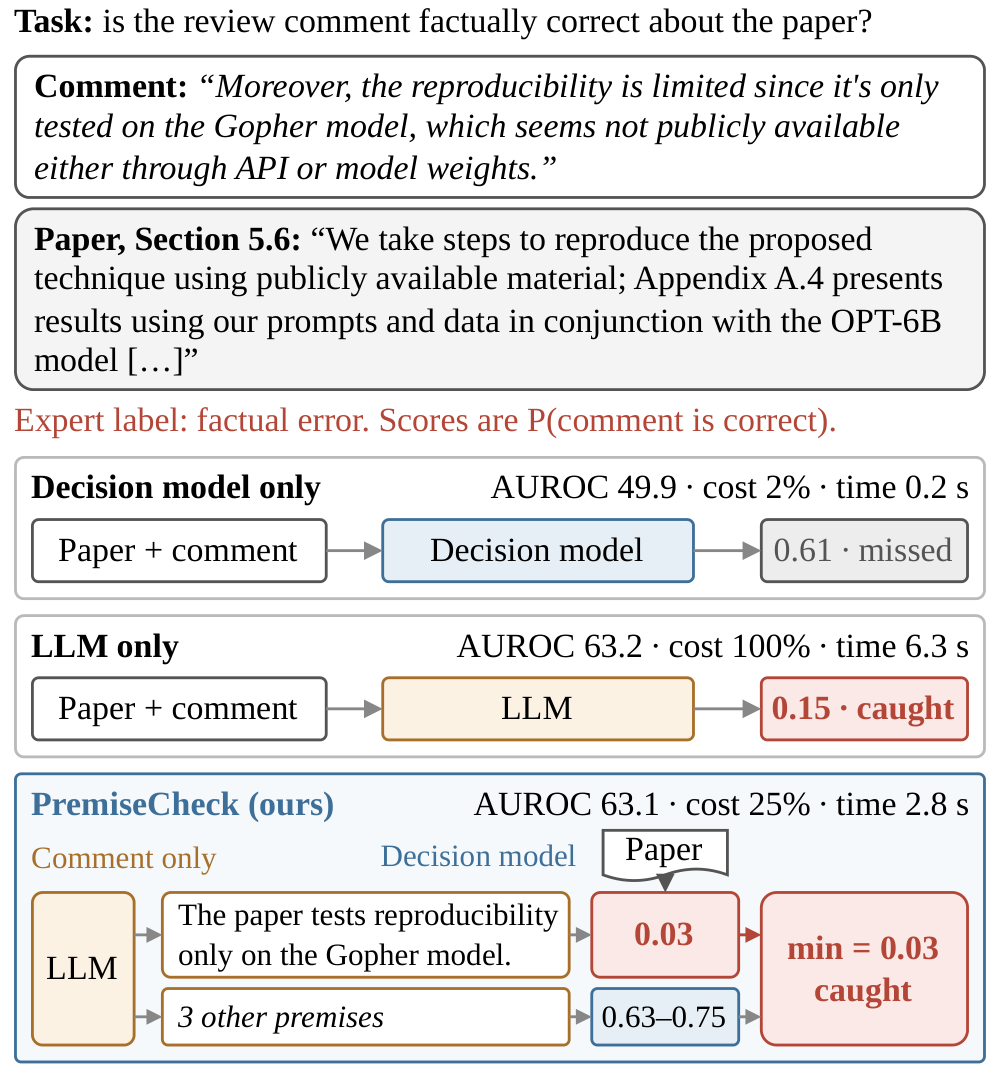
Исследователи из Университета Лихай, Университета Британской Колумбии и Vector Institute представили метод PremiseCheck. Он находит в рецензиях места, где рецензент неверно пересказал статью, и обходится примерно вдвое дешевле проверки силами GPT-5.5.
Почему это важно: рецензирование не успевает за ростом числа статей, а неверно пересказать работу может и человек, и ИИ-рецензент. Авторы показали, что в такой проверке дешёвая узкая модель может сравняться с передовой, если разбить задачу на простые шаги.
Повод: вместе с методом авторы выложили бенчмарк ReviewFact: 9 267 комментариев рецензентов к 217 статьям по обработке языка, машинному обучению и естественным наукам. Фактические ошибки в них размечены по единому определению, а кроме точности бенчмарк учитывает стоимость и время проверки. Чаще всего ошибки встречались в комментариях по машинному обучению — в 21,3% случаев.
Расклад: передовая модель хорошо проверяет комментарии, но для каждой проверки читает статью целиком. Дешёвые модели-решатели оценивают, верно ли утверждение по тексту, но на целых комментариях сильно отстают: в одном комментарии обычно смешано несколько неявных утверждений.
Как это работает: PremiseCheck соединяет оба подхода.
- GPT-5.5, не читая статью, переписывает каждый комментарий в набор явных утверждений-посылок.
- Модель Jev стартапа TypeSafe не пишет текст, а отвечает на вопросы о тексте вероятностями; она сверяет каждую посылку со статьёй.
- Оценку комментарию ставит самая слабая посылка. Подозрительный комментарий система помечает и показывает человеку, какую из его посылок опровергает статья.
- Вместо Jev можно взять открытую модель Kev-27B1: по данным авторов, она справляется сопоставимо.
Детали: один рецензент упрекнул авторов статьи в том, что у них нет сводки выводов. Jev оценил вероятность того, что это правда, в 0,04, а авторы потом ответили, что такой сводкой заканчивается каждый раздел с экспериментами.
В цифрах: качество измеряли площадью под ROC-кривой (AUROC): 50 баллов — уровень случайного угадывания, 100 — система всегда считает ошибочный комментарий подозрительнее верного.
- Когда комментарии проверяют по одному, PremiseCheck во всех трёх областях набирает баллы, сопоставимые с GPT-5.5, и стоит примерно вдвое дешевле.
- На рецензиях по обработке языка, если переписывать комментарии без режима рассуждений, счёт 63,1 против 63,2. Стоимость при этом — около четверти, время — меньше половины.
- Для целых рецензий по обработке языка авторы объединили оценки PremiseCheck и GPT-5.5 и получили 71,5 балла. Это 28% стоимости проверки силами одного GPT-5.5, который для каждого комментария читает статью целиком.
Но: авторы сами перечисляют ограничения.
- Задача трудная: на рецензиях по обработке языка обе системы набирают лишь около 63 баллов.
- Выборки по машинному обучению и естественным наукам маленькие, поэтому у результатов там широкий разброс.
- Ошибки суждения, а не пересказа статьи, метод не проверяет.
«Он задуман, чтобы указывать людям на комментарии, которые стоит проверить, а не заменять рецензентов», — пишут авторы. Код и данные они выложили в открытый доступ.