OpenAI выяснила, почему за рассуждениями её моделей всё труднее следить
Чем сильнее модели OpenAI, тем больше они решают без записанных рассуждений и тем лучше меняют эти записи по просьбе, выяснила компания.
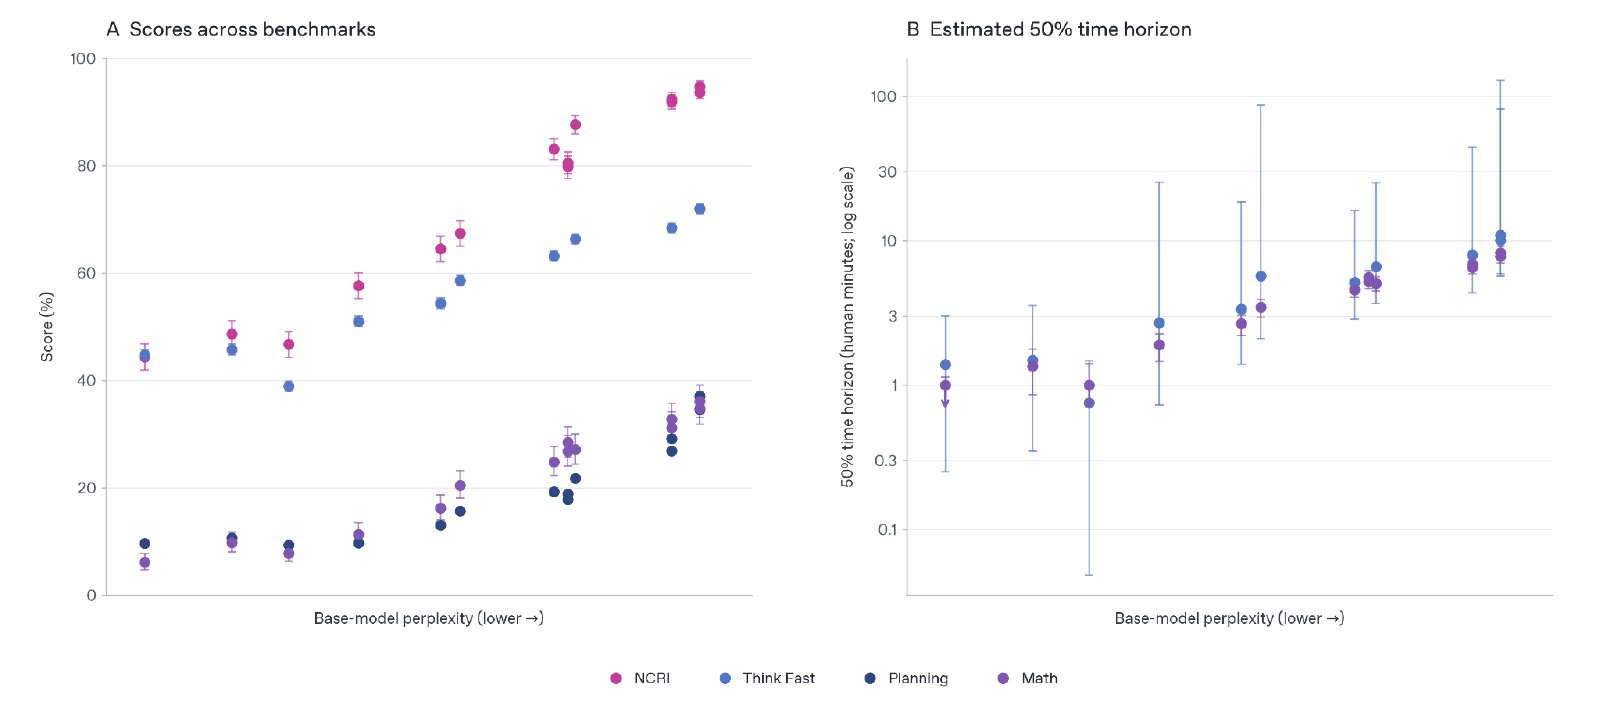
Исследователи OpenAI выяснили, что по рассуждениям моделей становится труднее следить за тем, что они делают. Причина не в отдельной ошибке: следить становится труднее по мере того, как обычное обучение делает модели сильнее. «Эти результаты отрезвляют», — пишут авторы. Среди научных руководителей работы — главный научный сотрудник OpenAI Якуб Пахоцкий.
Почему это важно: цепочка рассуждений — черновик, который модель пишет перед ответом. Обычно в нём видно, что она задумала, вплоть до планов нарушить правила. На чтении таких черновиков OpenAI во многом строит обоснования безопасности1 своих моделей, а у моделей с критическим уровнем кибервозможностей2 проверяет все действия вместе с рассуждениями.
Повод: тревожный сигнал дала вышедшая в сентябре GPT-6 Astra. В обычной работе по её рассуждениям стало труднее понять, что она делает. За моделями следят мониторы — отдельные системы, которые читают рассуждения модели и ищут в них признаки нарушений. Когда Astra прямо просили обмануть монитор, она справлялась с этим лучше прежних моделей, а без рассуждений решала заметно больше. Ещё до выпуска британский Институт безопасности ИИ3 проверил особую версию Astra с выключенными рассуждениями, которой нет в открытом доступе. По расчётам института, математические задачи, на которые у человека уходит около 30,9 минуты, она решала примерно в половине случаев. Прежний прогноз давал к концу 2028 года лишь около 7 минут.
Как это работает: напрямую проверить, сумеет ли модель спрятать намерения, трудно, поэтому OpenAI следит за косвенными признаками. Компания смотрит, сколько модель решает «в уме», ничего не записывая: чем меньше ей нужно писать, тем легче исказить запись. Ещё она проверяет, насколько модель управляет рассуждениями. Модель просят, например, вставлять «мяу» между словами черновика, писать его одними заглавными буквами или ставить «safe» в конце каждого предложения, а потом считают, какая доля черновика выполнила просьбу. В теории модель, которая умеет так переписывать черновик по просьбе, могла бы убрать из него и следы нарушений.
Детали: способность решать «в уме» растёт плавно по мере предобучения — первого этапа, когда модель осваивает огромный массив текста. Успехи на этом этапе OpenAI меряет перплексией: насколько хорошо базовая модель угадывает текст, которого раньше не видела. По календарю Astra выбилась из прежнего тренда, а по перплексии — нет. Умение управлять рассуждениями тоже связано с перплексией, но слабее. Сверх перплексии архитектура — внутреннее устройство модели — почти ничего не добавляет: в большинстве тестов модели разной архитектуры с одинаковой перплексией решали «в уме» примерно одинаково. Исключение — многошаговые вычисления и планирование: там некоторые архитектуры решают больше, чем предсказывает перплексия.
Управляемость рассуждений растёт и на следующем этапе, при обучении с подкреплением4: у Astra и моделей её класса — заметно. При этом сами рассуждения не поощрялись: OpenAI проверила это отдельно. Сначала исследователи заподозрили надзор за инструментами: проверяющие видели, как модель работает с терминалом и браузером, и это могло сказаться на черновике. Но управляемость росла и в опыте без инструментов, где оценивали только итоговый ответ и соблюдение лимита длины. Доступ к терминалу и браузеру добавил к росту совсем немного.
Интрига: управляемость передаётся следующему поколению. OpenAI часто учит новые модели на ответах прежних. Поэтому исследователи взяли двух учителей класса Astra с похожими способностями, но разной управляемостью рассуждений. На ответах каждого дообучили отдельную копию одной и той же базовой модели, и ученик более управляемого учителя сам стал управляемее. Авторы сравнивают это с сублиминальным обучением — когда модель перенимает черты учителя через данные, в которых этих черт напрямую нет.
Но: авторы признают, что управляемость — неточный признак, а её замеры сильно скачут. Они проверили, какая из двух одинаково сильных моделей из опыта с учителями лучше обманывает монитор. Разницы либо не было, либо успешнее оказалась менее управляемая. Британский институт оговаривает, что оценку в 30,9 минуты могли завысить задачи, попавшие в обучающие данные. По проверкам OpenAI, Astra реже GPT-5.6 Sol нарушает ограничения безопасности. Без подсказок она не смогла провести сложный саботаж так, чтобы его не заметил монитор, видящий всю её работу.
Что дальше: с выхода Astra OpenAI отслеживает, насколько модели умеют обходить мониторы, — и во время обучения, и перед выпуском. Компания ждёт, что дальнейший прогресс предобучения потребует новых способов следить за моделями. Над самими мерками она тоже работает: в октябре посчитала, сколько нарушений пропустит ИИ-монитор.