Итан Моллик к выходу новой книги насчитал 180 моделей сильнее GPT-4
По подсчёту Итана Моллика, за 30 месяцев 180 моделей обошли GPT-4, а верный ответ ИИ на трудный научный тест подешевел в 750 раз.
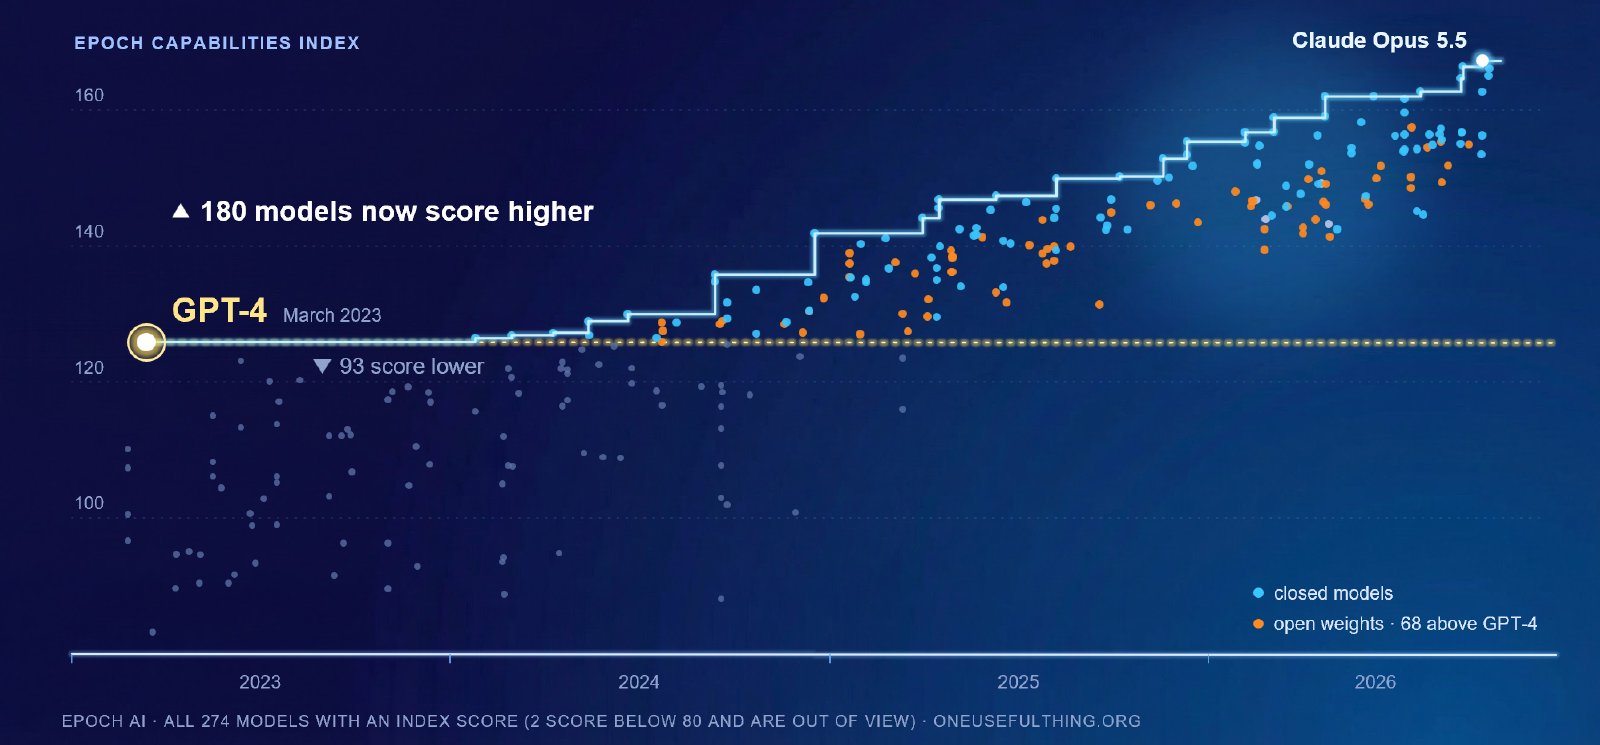
Итан Моллик из Уортонской школы бизнеса1 к выходу новой книги подсчитал: 180 моделей уже сильнее, чем GPT-4 на момент её выхода, а лучшей в мире за 30 месяцев побывали 20 разных моделей.
Почему это важно: за два с половиной года ИИ стал одновременно сильнее и дешевле, а замер METR2, по которому отрасль следила за этим ростом, больше не даёт надёжной оценки лучшим моделям.
Повод: 20 октября вышла Co-Existence — вторая книга Моллика об ИИ, через 30 месяцев после Co-Intelligence. К её выходу Моллик выпустил в своей рассылке One Useful Thing пост с графиками о том, как изменился ИИ между двумя книгами.
В цифрах: что ещё насчитал Моллик:
- С начала 2023 до начала 2024 года лучшей моделью в мире была GPT-4 от OpenAI, а все 20 лидеров после неё — от Anthropic, Google или OpenAI.
- Из 180 моделей, обошедших GPT-4, 19 работают на современном смартфоне, а многие выпущены с открытыми весами3.
- Верный ответ на тест GPQA, вопросы которого регулярно ставят в тупик аспирантов, обходился ИИ в 30 центов, а теперь стоит 0,04 цента.
Общая картина: рост способностей ИИ Моллик показывает на главном графике — по бенчмарку METR. Бенчмарк собран в основном из задач по программированию, машинному обучению и кибербезопасности. Он показывает, насколько длинные задачи — в часах работы человека — ИИ решает по одному запросу хотя бы в половине попыток. В 2024 году это были задачи на четыре минуты, а к апрелю 2026-го, когда Моллик сдал рукопись, — на 17 часов, то есть восемь удвоений. METR предупреждает: это не значит, что ИИ справится с любой интеллектуальной работой такой же длины.
Проверили: на странице METR о длине задач цифра Моллика подтверждается лишь примерно:
- Высшая оценка — 16 часов или больше — у ранней версии Claude Mythos Preview, и появилась она 8 мая 2026 года, уже после того, как Моллик сдал рукопись.
- Разброс у этой оценки большой: от 8,5 до 55 часов.
- Задач на такой срок в наборе всего пять из 228, поэтому замеры выше этой отметки METR сама называет ненадёжными.
- С 8 сентября METR больше не обновляет эту страницу.
Не факт: по словам Моллика, другие исследования допускают, что ИИ уже справляется с работой на 17 недель или больше. Какие это исследования, он не называет.
Что говорят: «Бенчмарки не отражают реальность. Они измеряют способности модели после того, как человек уже нашёл запрос, при котором эти способности проявляются», — писала в мае о графике METR Кэти Пэрротт из издания Every.
Детали: в Co-Intelligence Моллик описывал «кентавров», которые делят работу с ИИ, и «киборгов», которые смешивают свою работу с его. Теперь он добавил «заклинателя»: тот вызывает агентов, раздаёт им задания и оценивает результат, но, по словам Моллика, теряет контроль над тем, как именно ИИ этот результат получил.
Так сделаны и графики к посту. Моллик поручил их Claude Opus 5.5 в Claude Projects: там человек говорит с одним агентом-распорядителем, а тот сам запускает других агентов. Пожелания уместились в пару предложений, а работу, на которую у Моллика ушли бы часы, ИИ сделал за минуты.
Но: способности ИИ по-прежнему неровные. По оценке Моллика, ИИ всё ещё плохо пишет длинные тексты, а в математике за те же 30 месяцев прошёл путь от ужасного уровня до сверхчеловеческого.
Между строк: пост — анонс собственной книги Моллика. Он ведёт на её сайт, который, по словам автора, переделала Opus 5.5 после просьбы «сделать лучше».
Свой давний тест для генераторов картинок и видео — выдру в самолёте, которая пользуется Wi-Fi, — Моллик тоже отдал Opus 5.5 одним запросом с опечатками. Через его подписки на сервисы Google и ElevenLabs4 модель сама написала сценарий, сделала картинки и музыку. «У видео есть несколько недочётов. Но ИИ сам придумал, как его сделать, без всякой помощи от меня», — пишет Моллик.