Венские учёные дообучили модель Ai2 читать рукописные заметки археологов
57 размеченных примеров хватило, чтобы доля ошибок открытой модели olmOCR 2 в рукописных записях археологов упала до 1,11%; Ai2 видит в этом довод за открытые модели, которые можно дообучать и запускать на своём оборудовании.
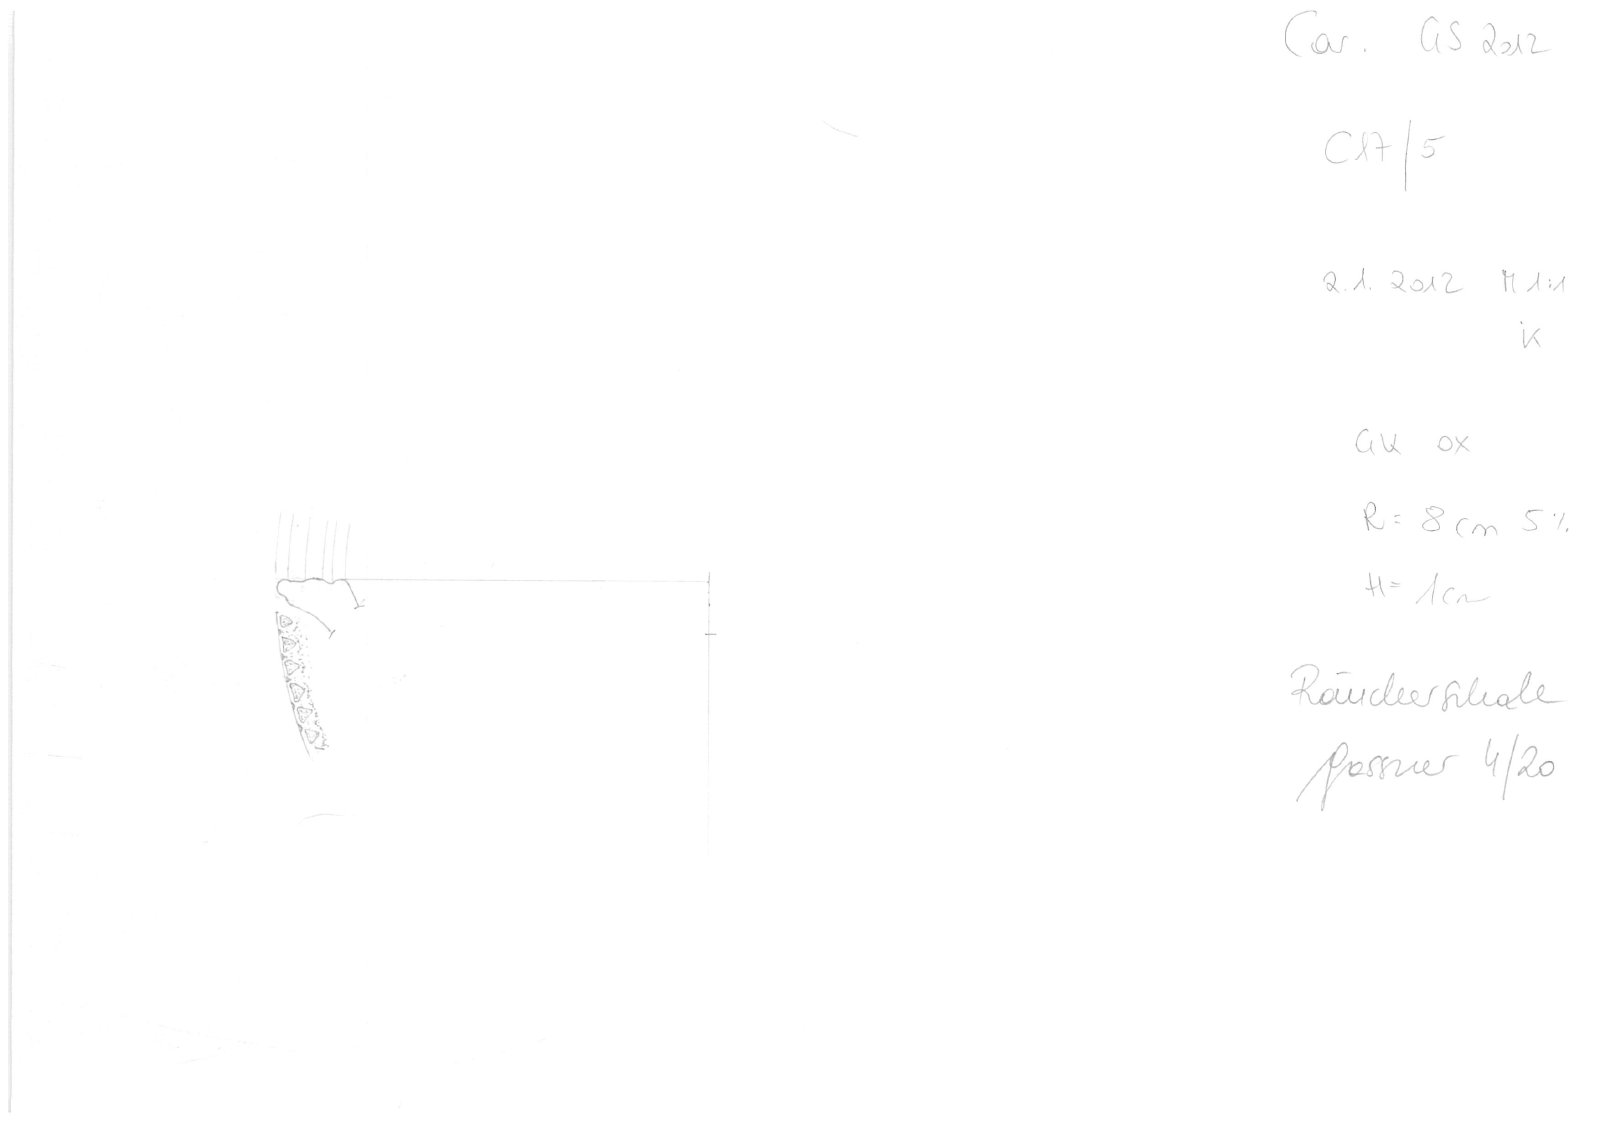

Исследователи из Вены дообучили открытую модель olmOCR 2 от Ai2 на 57 рукописных записях о римской керамике, и доля ошибок в расшифровке упала с 15,58% до 1,11%.
Почему это важно: небольшого набора, который под силу разметить самим специалистам, хватило, чтобы модель освоила незнакомый ей почерк и сокращения. Авторы рассчитывали свой способ на музеи и архивы, которым часто не по карману прогонять десятки тысяч документов через платные сервисы коммерческих моделей.
Повод: 28 октября Ai2 описал два проекта на olmOCR 2 и подал их как пример того, что дают открытые веса1: модель можно запускать на своём оборудовании и дообучать под свои документы.
- CENTURIA — работа Лаборатории компьютерного зрения Венского технического университета и Австрийского археологического института при Австрийской академии наук; статью о ней авторы выложили на arXiv2 31 августа.
- ArtificeOCR — программа историка Мориса Кейси (Maurice Casey), которая связывает olmOCR 2 с Tropy, открытым приложением для упорядочивания архивных фотографий.
Предыстория: Ai2 выпустил olmOCR 2 в октябре 2025 года. Модель переводит снимки документов, в том числе рукописных и со сложной вёрсткой, в текст, по которому можно искать; её основа — Qwen2.5-VL-7B от Alibaba.
В цифрах: венская команда работала с архивом раскопок Карнунтума — римского поселения на территории нынешней Австрии.
- В архиве около 70 000 записей: рисунки сосудов с пометками от руки о форме, месте находки и других деталях, часто сокращёнными немецкими терминами.
- Для проверки авторы собрали набор из 507 записей и сравнили пять открытых моделей; до дообучения меньше всех ошибалась olmOCR 2.
- Модель дообучили методом LoRA3 на 57 записях, а проверяли на остальных 450.
- Долю верно заполненных полей, например категории находки, дообучение подняло примерно с 30% почти до 92%.
Интрига: для дообучения авторы оставили две лучшие модели — olmOCR 2 на 7 млрд параметров и LightOnOCR от LightOn4 на 1 млрд. У дообученной LightOnOCR доля ошибок составила 1,21%, и, по выводу авторов, она даёт «сопоставимую общую точность при заметно меньших вычислительных затратах»; olmOCR 2 при этом точнее заполняла часть полей.
Детали: Кейси изучает радикальную политику в Европе начала XX века по источникам на английском, русском и немецком.
- За годы работы он снял на разные смартфоны тысячи писем, газет и других документов, но не хотел выгружать в сторонние сервисы то, что ему доверили архивы и семьи.
- Через ArtificeOCR он сделал свою библиотеку в Tropy доступной для поиска по словам и сохранил описания, которые вносил туда с 2019 года.
- По его словам, модель справляется с разной вёрсткой, включая типовые бланки из архивов тайной полиции, а также с английской скорописью и машинописью.
Но: по опыту Кейси, языковая модель может выдать гладкий правдоподобный текст там, где обычная программа распознавания выдала бы явную абракадабру. Ошибается она и в почерке на языках, которых мало в её обучающих данных, поэтому ArtificeOCR показывает скан рядом с расшифровкой и даёт её поправить.
Что дальше: венская команда хочет применить подход ко всему архиву Карнунтума, чтобы сравнивать формы сосудов по всему поселению и между эпохами. ArtificeOCR пока на ранней стадии разработки.
Так уже было: 13 октября Ai2 рассказывал о прототипе Molmo2Fish — он построен на открытой модели института и следит за лососями на записях сонара.
«Для меня важнее всего было то, что модель можно запускать у себя, — говорит Кейси. — Очень многое я просто не решился бы отправить третьей стороне».