Суперкластер, где Meta* обучила ИИ-модели Muse Wonder, вырастет до миллиона ускорителей
Meta раскрыла устройство суперкластера Prometheus, где обучала ИИ-модели Muse Wonder: хотя сбой одного сервера может затормозить всё обучение, на первом его этапе больше 85% вычислений шло на полезную работу, а не на простои и перезапуски.
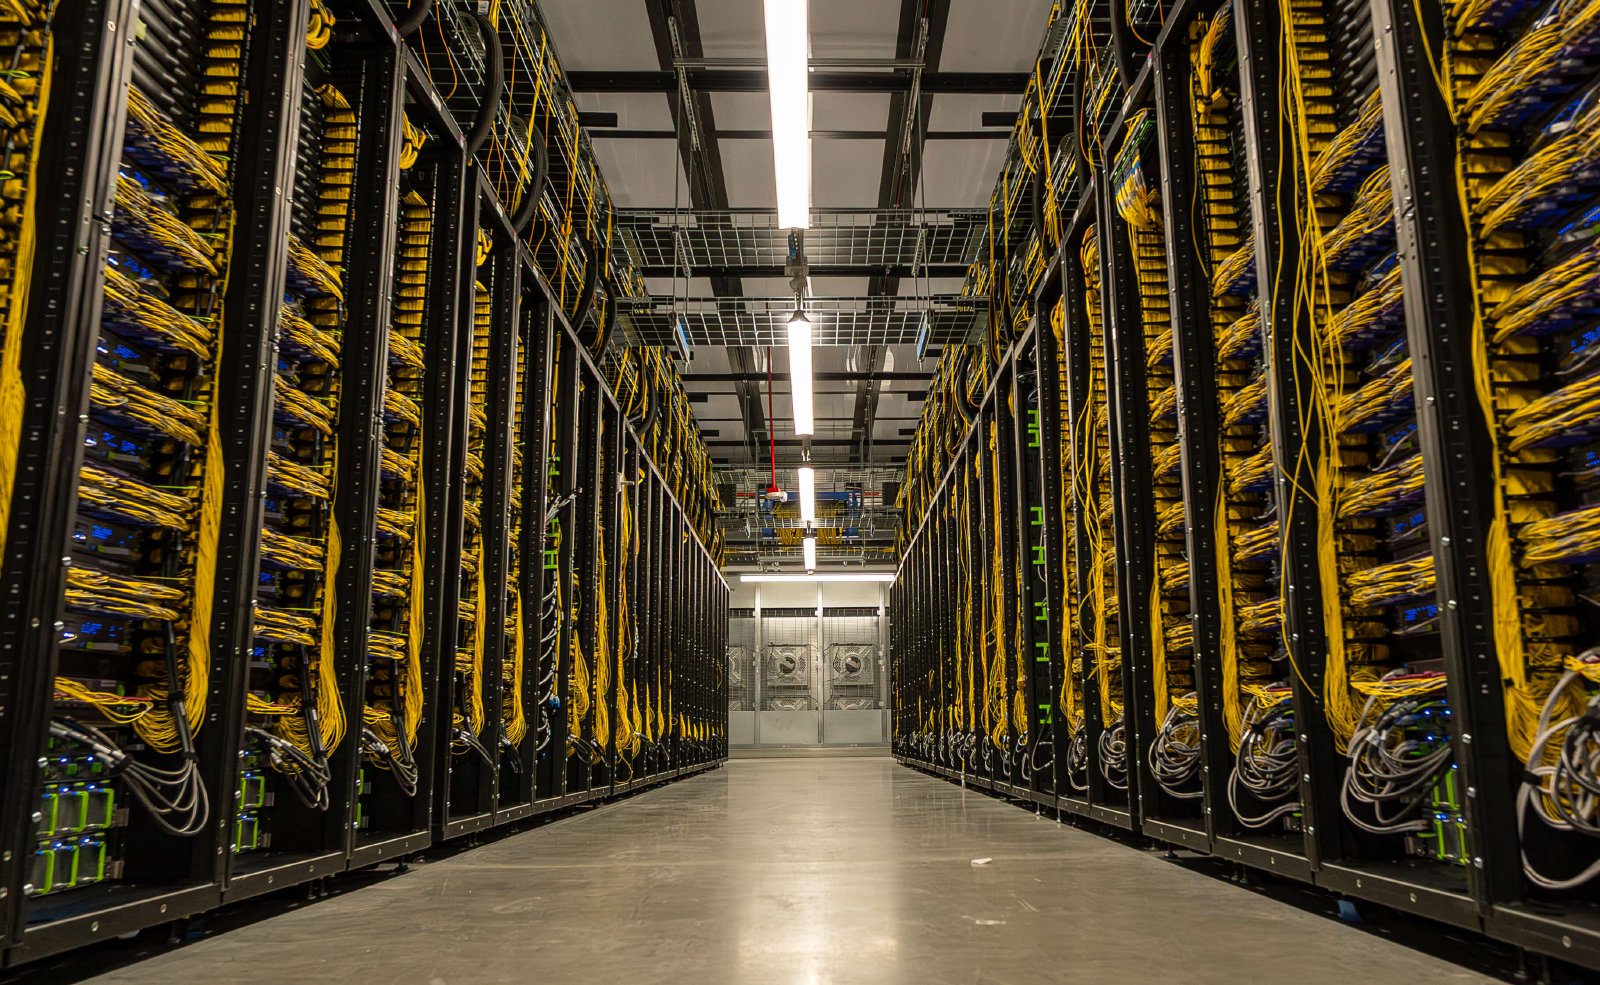
Meta рассказала об устройстве Prometheus — суперкластера в штате Огайо, на котором обучила модели Muse Wonder: первая очередь готова, а в итоге в нём будет около миллиона ускорителей.
Почему это важно: на таком масштабе мало купить ускорители — их нужно удержать в работе, ведь сбой одного сервера тормозит или останавливает всё обучение. Meta назвала, сколько вычислений при обучении Muse Wonder шло на полезную работу и как часто процесс прерывался.
Повод: статью из инженерного блога Meta выложил в соцсети X аккаунт AI at Meta. В посте компания делает упор на надёжность: в кластере из сотен тысяч ускорителей «даже один отстающий сервер может замедлить всё обучение».
Предыстория: кластер Meta строит по очередям.
- В июле 2025 года Марк Цукерберг объявил о Prometheus и обещал, что кластер заработает в 2026 году.
- Ещё два года назад площадка в городе Нью-Олбани, где стоит Prometheus, была обычным дата-центром и обслуживала веб-трафик.
- 12 октября Meta выпустила Muse Wonder — модели для личных и рабочих агентов, обученные на первой очереди Prometheus.
В цифрах: надёжность Meta меряет долей полезной работы — сколько вычислений ушло на само обучение, а не на простои и перезапуски.
- На предобучении1 Muse Wonder доля полезной работы превысила 85%, на обучении с подкреплением2 — 90%.
- Обучение прерывалось в среднем раз в 47 тыс. GPU-часов — так считают время работы всех ускорителей, сложенное вместе.
- После исправлений прошивки по всему парку серверов этот показатель вырос до более чем 54 тыс. GPU-часов.
Расклад: сейчас в Prometheus сотни тысяч ускорителей NVIDIA в нескольких зданиях, и оптоволокно связывает их в одну машину. Линии связи между зданиями — длиной от 2 до более чем 100 км. Ускорители стоят на двух платформах, третья на подходе:
- Catalina построена на GB200 NVL72 с ускорителями Blackwell, у каждого 192 ГБ памяти; 72 ускорителя в ней разнесены на две стойки по 36.
- Clemente построена на GB300 NVL72: у ускорителя 288 ГБ памяти, все 72 помещаются в одну стойку, а производительность, по данным Meta, на 5–10% выше.
- Третья платформа, на Vera Rubin3 NVL72, по словам Meta, появится скоро.
Как это работает: в системе NVL72 тесно связаны 72 ускорителя — в одной стойке или, как у Catalina, в паре стоек по 36. У прошлого поколения H100 таких ускорителей было восемь, поэтому один сбой теперь может задеть в девять раз больше. Meta отвечает на это запасом:
- В каждой такой группе из 72 ускорителей обучение занимает 64, а восемь остаются запасными.
- Если ускоритель отказывает, его сразу подменяет запасной, и обучение продолжается с последней сохранённой точки, а не ждёт ремонта.
- На случай отказа целой стойки компания держит в резерве ещё около 2% стоек.
- Для обучения на 32 768 ускорителях это 523 стойки, или 37 656 ускорителей, и около 13% из них — запасные.
Но: сколько ускорителей обучали Muse Wonder, сколько энергии кластер потребляет сейчас и когда в нём будет миллион ускорителей, Meta не назвала.
Что дальше: Meta продолжит наращивать Prometheus под следующие передовые модели Meta Superintelligence Labs — своей лаборатории, которая делает Muse.
Инженеры NVIDIA, по словам Meta, работают прямо в её дата-центрах и вместе с ней разбирают причину каждой остановки. Meta отвечает за расписание задач и инфраструктуру, NVIDIA — за прошивки, проверку качества сигнала в линиях связи между ускорителями и сбои их памяти.
* Meta Platforms Inc., которой принадлежат Facebook и Instagram, признана в России экстремистской организацией, её деятельность запрещена.