35 исследователей описали пять ступеней к ИИ, который улучшает сам себя
Авторы обзора разделили путь к ИИ, который сам себя улучшает, на пять уровней. Из 522 работ в их каталоге до высшего уровня дотягивают 33.
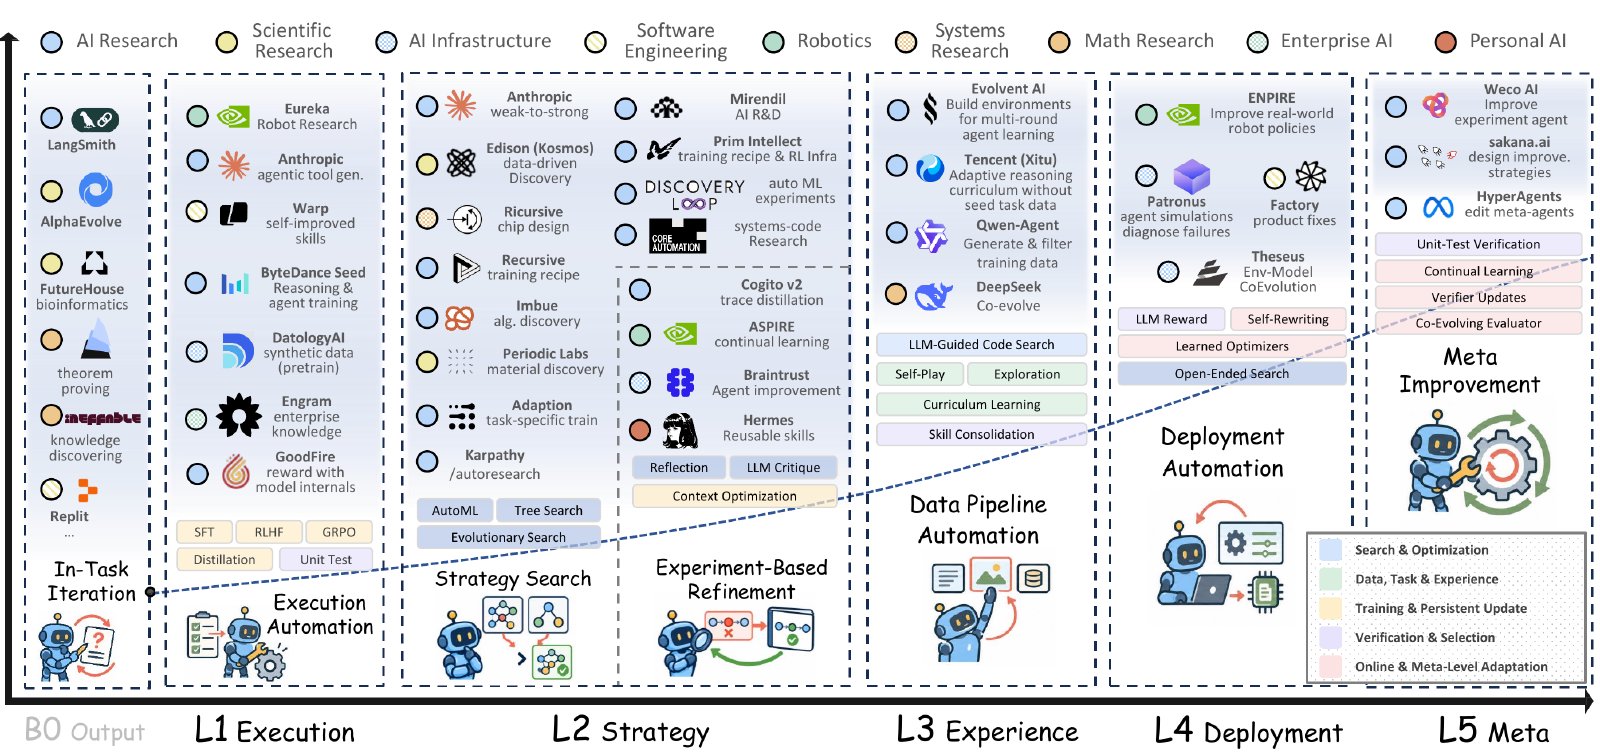
35 исследователей выпустили обзор о рекурсивном самосовершенствовании ИИ. Путь к системам, которые улучшают и себя, и сам способ своего улучшения, они разделили на пять уровней.
Почему это важно: обзор даёт общую шкалу для работ о самоулучшающемся ИИ. По ней видно, что система решает сама, а что за неё по-прежнему решают люди.
Повод: первая версия препринта вышла на arXiv 10 сентября, третья — 22 сентября. На Hugging Face Papers работа набрала 90 голосов. Вместе с ней авторы выложили каталог из 522 работ, разложенных по уровням.
Как это работает: самосовершенствованием авторы называют случаи, когда система превращает опыт и отзывы в постоянные изменения своих весов, запросов, кода, памяти или навыков. На первом уровне она лишь выполняет придуманную людьми процедуру улучшения и сохраняет результат. Выше идут:
- второй уровень: система сама выбирает способ улучшения, но что улучшать и по какому критерию оценивать результат, решают люди;
- третий: она сама решает, какие задачи и какой опыт получить в следующем раунде обучения;
- четвёртый: система копит память и навыки в реальной работе и меняет поведение, но сам процесс улучшения остаётся прежним;
- пятый: система улучшает механизм, который порождает будущие улучшения, — поиск, оценку, управление исследованием.
В цифрах: из 522 работ каталога 219 авторы отнесли к первому уровню, 160 — ко второму и 33 — к пятому.
Детали: нынешние модели авторы оценили своим индексом HCI (Headroom-Closed Index). Ноль по нему — уровень передовых моделей в год выхода бенчмарка, 100 — идеальный результат. В 2026 году картина такая:
- высшая математика и естественные науки уровня аспирантуры — 86,4 и 85,8, то есть запас для роста почти выбран;
- программирование — 52,6, поиск и работа в терминале — 56,8;
- агенты, которые работают с инструментами, — 39,9: авторы объясняют отставание длинными задачами, где нужно планировать, следить за состоянием среды, выбирать инструмент и исправлять ошибки.
Расклад: примеры, на которые опираются авторы:
- в опыте A-Evolve-Training система четыре раунда без людей улучшала модель Nemotron1 на 30 млрд параметров: оценка выросла с 0,80 до 0,86, у лучшей работы людей — 0,87;
- Darwin Gödel Machine2 развивает агентов для программирования и подняла их долю решённых задач на части SWE-bench3 с 20 до 50%;
- из индустрии разобраны восемь систем, среди них разработки Tencent Hunyuan, соцсети Xiaohongshu и офисного пакета Lark.
Но: на пути к настоящему самосовершенствованию авторы видят три препятствия:
- изменения должны закрепляться, не портя прежних умений: Gödel Agent4, который переписывает и себя, и логику улучшения, в 14 из 100 попыток на школьных задачах по математике стал хуже исходной версии;
- если система выдаёт ответы лучше, это ещё не доказывает, что она улучшила сам способ их поиска и отбора;
- если давать системе снова и снова обращаться к проверяющему, она учится обманывать проверку: авторы упоминают перезапуски, пока не выпадет удачный случайный результат, и попытки вытащить правильные ответы теста.
Сами авторы оговаривают, что попадание в каталог не делает систему полностью автономной. Метки первого и второго уровней прямо указывают, что самостоятельность этих систем ограничена.