Чипы Google оказались выгоднее NVIDIA в части тестов ИИ-агентов
В тестах SemiAnalysis чипы Google выдавали больше текста за доллар, чем ряд систем NVIDIA, однако результат зависел от модели и точности вычислений.
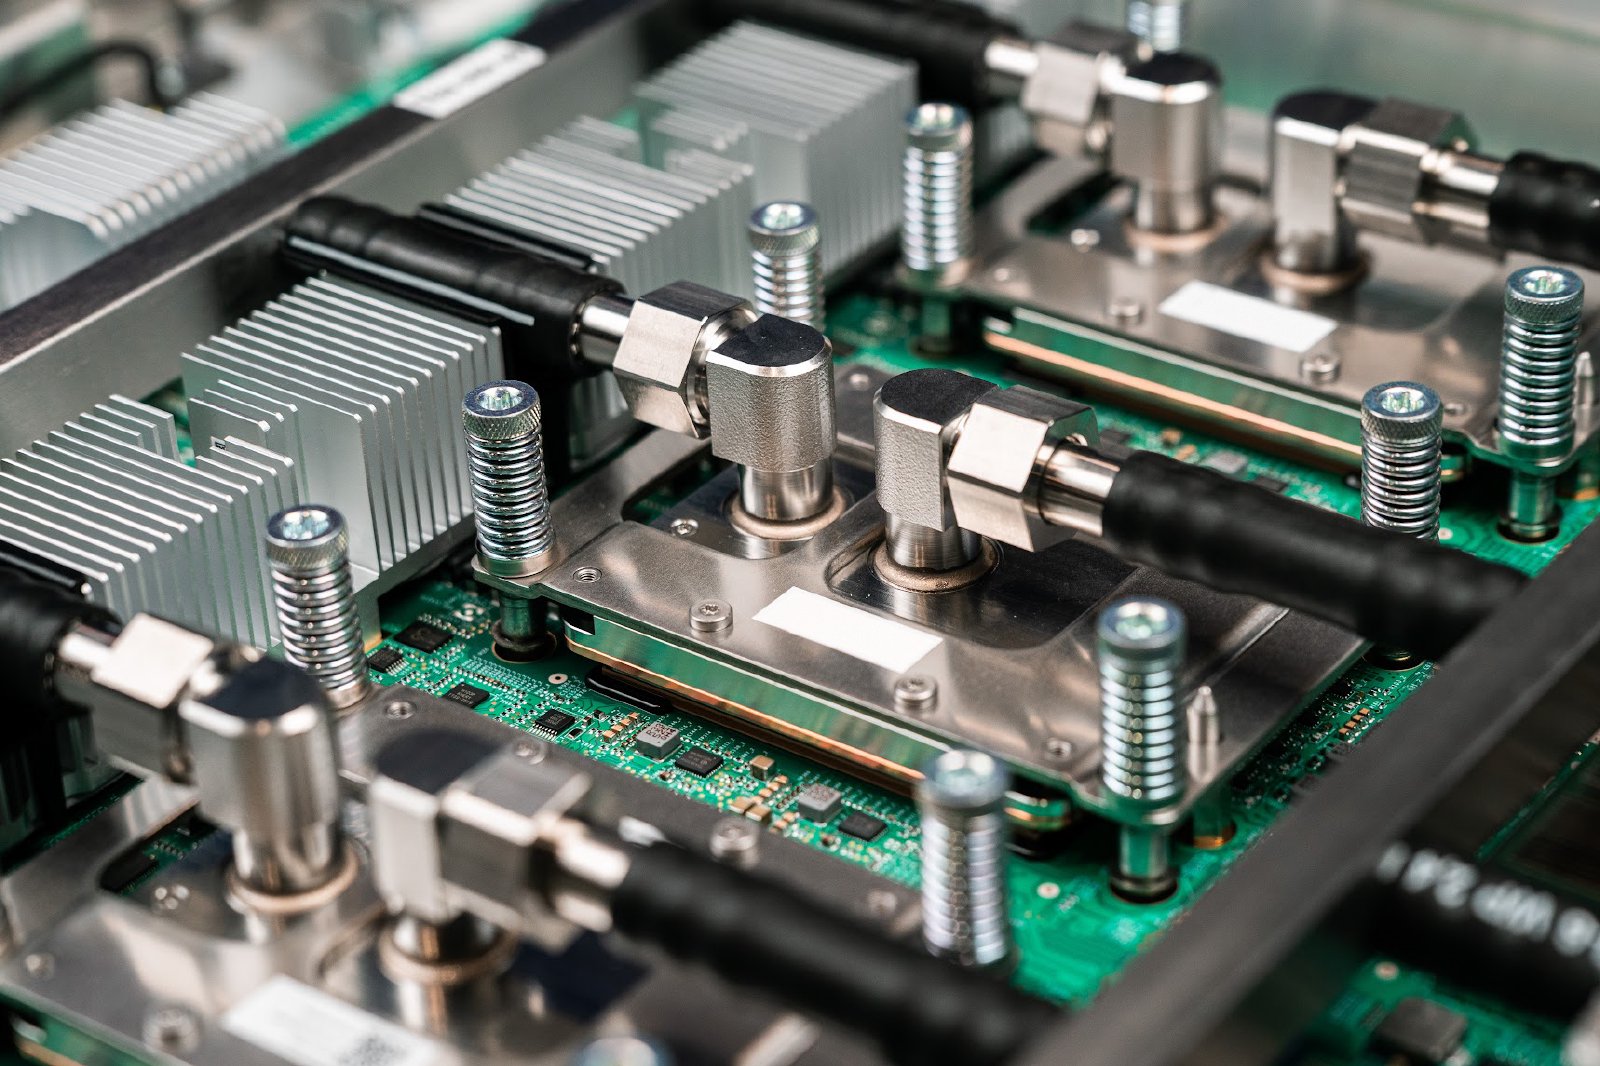
Ускорители Google TPUv7 Ironwood оказались выгоднее ряда систем NVIDIA при работе ИИ-агентов в тестах AgentX, результаты которых SemiAnalysis представила 5 ноября.
Почему это важно: По оценке SemiAnalysis, расходы на работу моделей смещаются к длинным многошаговым задачам агентов. Здесь Google конкурирует с NVIDIA одновременно стоимостью вычислений и поддержкой программ, которыми разработчики уже пользуются для запуска моделей.
Детали: AgentX имитирует десятки или сотни ходов диалога, накопление длинной истории и всплески работы дополнительных агентов. Системы повторно используют уже обработанную часть переписки. Главная мера сравнения — сколько токенов, то есть фрагментов текста, система выдаёт за доллар при заданной скорости ответа каждому пользователю. Для TPU приведены расчёты по стоимости для внешних клиентов Google.
В цифрах: При запуске GLM-5.2 в одинаковом формате вычислений FP8 чипы TPUv7 выдавали в 1,2–2,7 раза больше токенов за доллар, чем NVIDIA B200, B300 и AMD MI355X. Результаты относятся к скорости 60–300 токенов в секунду на пользователя.
Но: FP8 представляет числа модели восемью битами, а FP4 — четырьмя, сокращая объём её параметров в памяти. У TPUv7 нет встроенной поддержки FP4, а системы NVIDIA с этим форматом во многих режимах выгоднее. В сравнении на GLM участвовала также другая система NVIDIA — GB300 с FP4. Здесь отличался не только формат чисел, но и оборудование. При скорости 100 токенов в секунду на пользователя GB300 выдавала в 3,6 раза больше токенов за доллар, чем TPUv7. При этом SemiAnalysis отмечает небольшую потерю качества модели при переходе на FP4.
Как это работает: На Qwen3.5 чипы TPUv7 в FP8 с программой для распределённого запуска моделей выдавали больше токенов за доллар, чем GB300 FP8, при всех проверенных скоростях ответа. Эта программа распределяет обработку входящего запроса и генерацию текста между разными машинами, чтобы длинные запросы не задерживали выдачу ответов. Однако по общей производительности, учитывающей и начальную обработку запроса, и генерацию всего ответа, эта конфигурация TPU уступала GB300 FP4 с другой программой запуска моделей — TRTLLM. Конкретный показатель этого отставания SemiAnalysis не уточняет.
Расклад: На Kimi K3 преимущество тоже зависело от конфигурации. После четырёх доработок со стороны NVIDIA система GB300 FP4 выдавала в 1,5–2,6 раза больше токенов за доллар, чем TPUv7. При этом TPU сохраняли преимущество над GB200, B200 и B300.
Общая картина: Результаты готовили не только инженеры Google. Разработчики открытых программ для запуска моделей RadixArk и Inferact представили замеры Muse Spark Open через SGLang и Kimi K3 через vLLM соответственно. Ещё 21 октября вышла программа SGLang-TorchTPU для запуска моделей на ускорителях Google через библиотеку PyTorch; Meta* уже применяла SGLang-TorchTPU в рабочей среде.
На Muse Spark Open стоимость генерации текста на TPUv7 оказалась конкурентоспособной, хотя архитектуру модели проектировали под видеокарты. Системе Google ещё нужно сократить время от поступления запроса до завершения ответа — в частности, ускорить начальную обработку запроса.
* Meta Platforms Inc., которой принадлежат Facebook и Instagram, признана в России экстремистской организацией, её деятельность запрещена.