Вышел движок SGLang-TorchTPU для ускорителей Google, Meta* уже им пользуется
Открытые модели вроде Muse Spark Open и MiniMax H3 можно запускать на ускорителях Google через привычную разработчикам библиотеку PyTorch, а Meta уже применяет новый движок в рабочей среде.
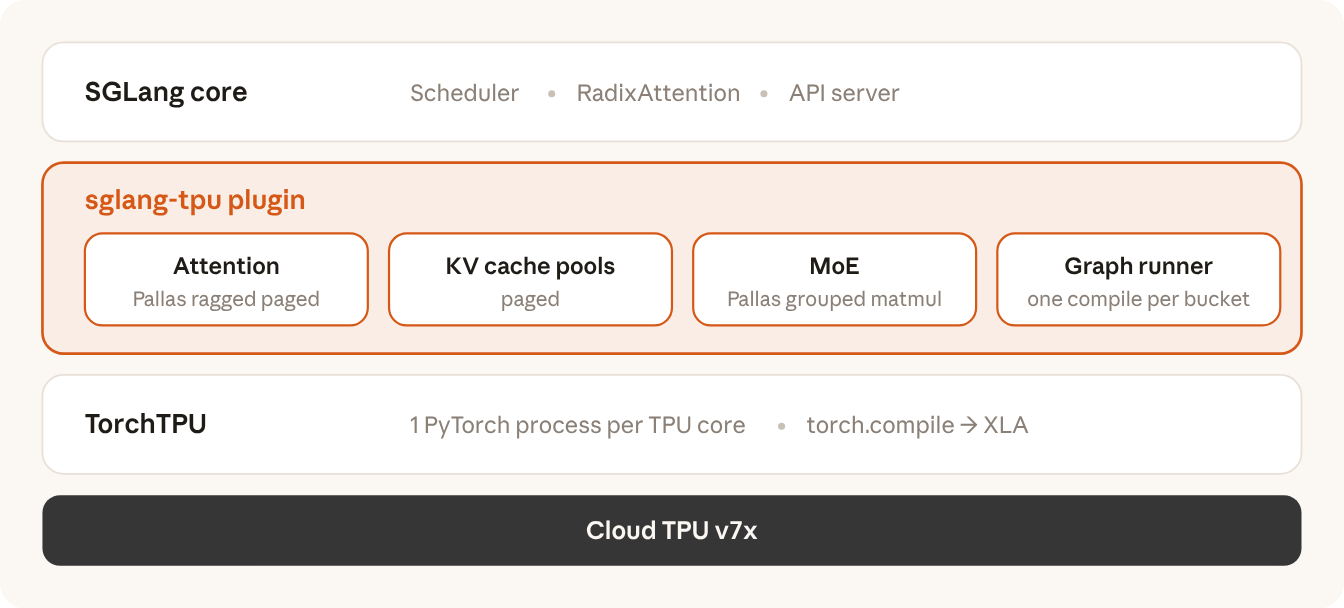
Google, Meta и стартап RadixArk1 выпустили SGLang2-TorchTPU — вариант открытого движка SGLang для ускорителей Google TPU3, построенный на библиотеке PyTorch4. О запуске объявила команда SGLang в соцсети X.
Почему это важно: прежний вариант SGLang для TPU был написан на JAX — библиотеке Google, а не на PyTorch. Новый позволяет разрабатывать и запускать модели на TPU в привычном разработчикам PyTorch. Meta, соавтор проекта, уже применяет движок в рабочей среде.
Предыстория: 30 июля RadixArk и Google Cloud выпустили SGL-JAX — первую версию SGLang для TPU — и пообещали вариант на PyTorch до конца года.
Детали: на старте движок запускает на TPU девять открытых моделей:
- Muse Spark Open — модель Meta на 816 млрд параметров для кода и агентов, которую компания выложила 15 октября.
- GLM-5.3 и GLM-5.3 Flash от Z.ai, Kimi K3 от Moonshot AI, а также DeepSeek V4, Qwen3.8, Gemma 4 и Ling 3.1 Flash — большие языковые модели других разработчиков.
- MiniMax H3 — открытая видеомодель китайской компании MiniMax, которая делает видеоролики по запросу.
В цифрах: по замерам команды, Muse Spark Open выдаёт 770 токенов в секунду, когда отвечает одному пользователю. Замер сделан на тесте InferenceX от аналитиков SemiAnalysis: запрос на 8 000 токенов, ответ на 1 000. Для этого команда написала собственное ядро MegaKernel — программу для ускорителя, которая сводит множество мелких шагов модели в один большой.
Как это работает: движок принимает запросы в формате API OpenAI, так что приложения подключаются к нему обычными клиентами, а для больших нагрузок в нём есть несколько приёмов:
- Модель можно разделить между многими чипами и серверами несколькими способами: например, разложить по разным чипам её отдельные блоки-«эксперты» или этапы вычислений.
- Веса модели сжимают до 8 или 4 бит на число, а кэш с уже обработанной частью диалога выносят из памяти ускорителя в обычную память сервера.
- Чтение запроса и написание ответа можно разнести на разные чипы, чтобы эти два этапа не мешали друг другу.
- Спекулятивное декодирование ускоряет ответ: черновик из нескольких токенов набрасывают наперёд, а основная модель только проверяет его.
Если шире: SGLang-TorchTPU работает поверх TorchTPU — слоя, с которым PyTorch видит TPU как обычное устройство, наравне с видеокартами. Google открыла его код вместе с Meta 20 октября на конференции PyTorch и тогда же выпустила версию для TPU соперничающего открытого движка vLLM.
Что говорят: «Спасибо, что перенесли H3 на TPU», — написала в X компания MiniMax, разработчик видеомодели. «Хотим видеть больше открытой работы над эффективным запуском видеомоделей», — добавила она.
Но: движок разрабатывают и проверяют на TPU седьмого поколения Ironwood, а поддержка моделей разная: Kimi K3, например, пока проверили только на уменьшенной модели с весами-заглушками вместо настоящих.
Так уже было: в сентябре стартап Nunchux запустил H3 на ускорителях AMD, и пятисекундный ролик модель делала за 1,3 секунды.
* Meta Platforms Inc., которой принадлежат Facebook и Instagram, признана в России экстремистской организацией, её деятельность запрещена.