Mistral выпустила речевые модели Voxtral 3 и набор для голосовых агентов
Модели Mistral распознают речь на 50 с лишним языках и озвучивают текст с эмоциями, а новый набор инструментов собирает из них голосового агента.
Mistral выпустила Voxtral 3 — семейство моделей, которые переводят речь в текст и текст в речь, и набор инструментов для разработчиков (SDK), чтобы собирать из них голосовых агентов.
Почему это важно: раньше Mistral выпускала модели распознавания и синтеза речи по отдельности, теперь к ним добавился набор, из которого голосового агента собирают целиком. Компании сами решают, где обрабатывается звук и хранятся ли записи разговоров.
Повод: главные модели семейства:
- Voxtral Small Transcribe 3 распознаёт речь на 50 с лишним языках, различает собеседников и точнее пишет специальные слова, если дать ей их список.
- Voxtral Mini Transcribe Realtime 3 расшифровывает речь на лету: задержка меньше 0,5 секунды, языков больше 35.
- Voxtral Mini TTS 3 озвучивает текст на 35 с лишним языках и 50 с лишним диалектах. Эмоцию и темп она угадывает по разговору, но их можно задать и для отдельной строки метками в тексте: например, сделать речь грустной и медленной.
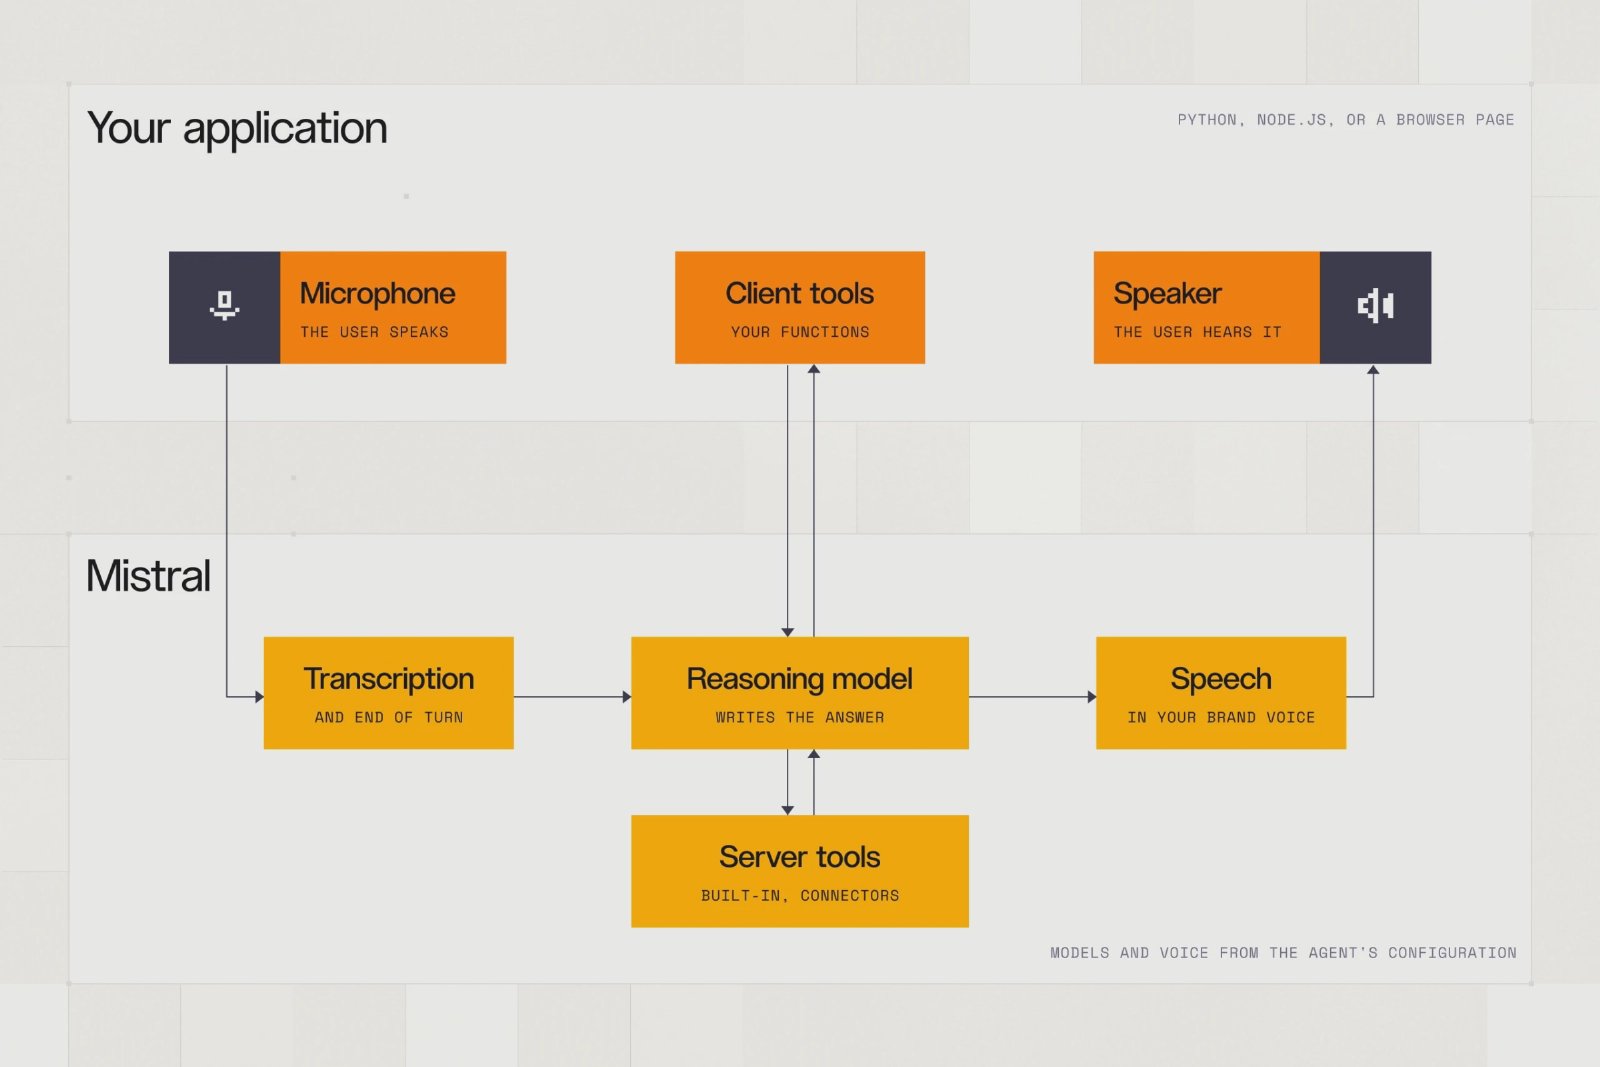
Как это работает: SDK построен на платформе LiveKit1. Агент для телефона, браузера и приложений собирается из трёх моделей, и любую из них можно заменить, не переписывая агента:
- Модель распознавания слушает и по звуку и смыслу фразы определяет, что собеседник договорил.
- Языковая модель, например Mistral Small, рассуждает и вызывает инструменты: проверяет личность звонящего, смотрит счёт, записывает на приём.
- Модель синтеза отвечает в тоне разговора и замолкает, если собеседник её перебивает.
Детали: модели доступны через API Mistral, на выбор с серверами в Европе, в США или без привязки к региону. Чтобы развернуть весь набор на своих серверах или в частном облаке, нужно связаться с компанией. Для профессиональных задач, где простого клонирования голоса мало, есть функция Pro Voice. По записи длиной до 30 минут она передаёт не только голос, но и манеру человека — его эмоции и стиль речи — на всех поддерживаемых языках.
В цифрах: цены и задержки Mistral привела в блоге:
- Младшая модель распознавания Voxtral Mini Transcribe 3 на 4 млрд параметров стоит 0,35 цента за минуту записи.
- Синтез речи стоит 13 долларов за миллион знаков текста.
- На каждую реплику собеседника агент отвечает меньше чем за секунду, потому что этапы работают одним потоком и не ждут друг друга.
- Готовые голоса есть на 18 языках, в том числе на русском.
Но: все сравнения с соперниками — замеры самой Mistral. По ним Small Transcribe распознаёт речь точнее Whisper2, Scribe v2 от ElevenLabs и Gemini 3.5 Transcribe, а синтез дешевле сопоставимых моделей OpenAI, Deepgram3, ElevenLabs и Google.
В марте Mistral выпустила модель синтеза речи Voxtral TTS: она говорила на девяти языках, а миллион знаков стоил 16 долларов.