Google собрала ИИ-сорежиссёра для связных видео длиной в минуты
Агенты поверх Gemini и Veo планируют сюжет, запоминают, как выглядят герои и места, и сами переписывают запросы. На показе Google они сделали фильм на десять минут.
Google Research объединила четыре своих исследования в систему, которую называет ИИ-сорежиссёром. Это агенты поверх Gemini и Veo1, которые генерируют видео длиной в несколько минут, и герои с местами в нём не меняют облик.
Почему это важно: видеомодели уже делают правдоподобные ролики на несколько секунд. Но если склеить их в длинный сюжет, у героя меняется одежда, а у комнаты — планировка. Ошибка в раннем кадре тянется до конца, и обычно её исправляют вручную.
Повод: статьи о трёх частях системы вышли на arXiv2 ещё весной, с марта по май. Теперь Google описала их как одну систему и показала десятиминутный фильм, который сгенерировала одна из частей — A²RD. Работу Co-Director представят на конференции COLM 2026, CANVAS — на EMNLP 2026.
Как это работает: у каждой из четырёх частей своя задача.
- Co-Director по схеме «многорукого бандита3» выбирает для ролика замысел, тип повествования и стиль, а модель-судья оценивает итог перед следующей попыткой.
- CANVAS запоминает героев, места и то, в каком состоянии предметы; когда сюжет возвращается в знакомый зал, она берёт его облик из памяти.
- A²RD генерирует видео по кускам и для каждого решает, двигать сюжет вперёд или держаться уже показанных героев и мест.
- VQQA задаёт вопросы о готовом ролике и по ответам модели-критика переписывает текстовый запрос, а пиксели не трогает.
Детали: на примерах Google видно, какие сбои убирает система.
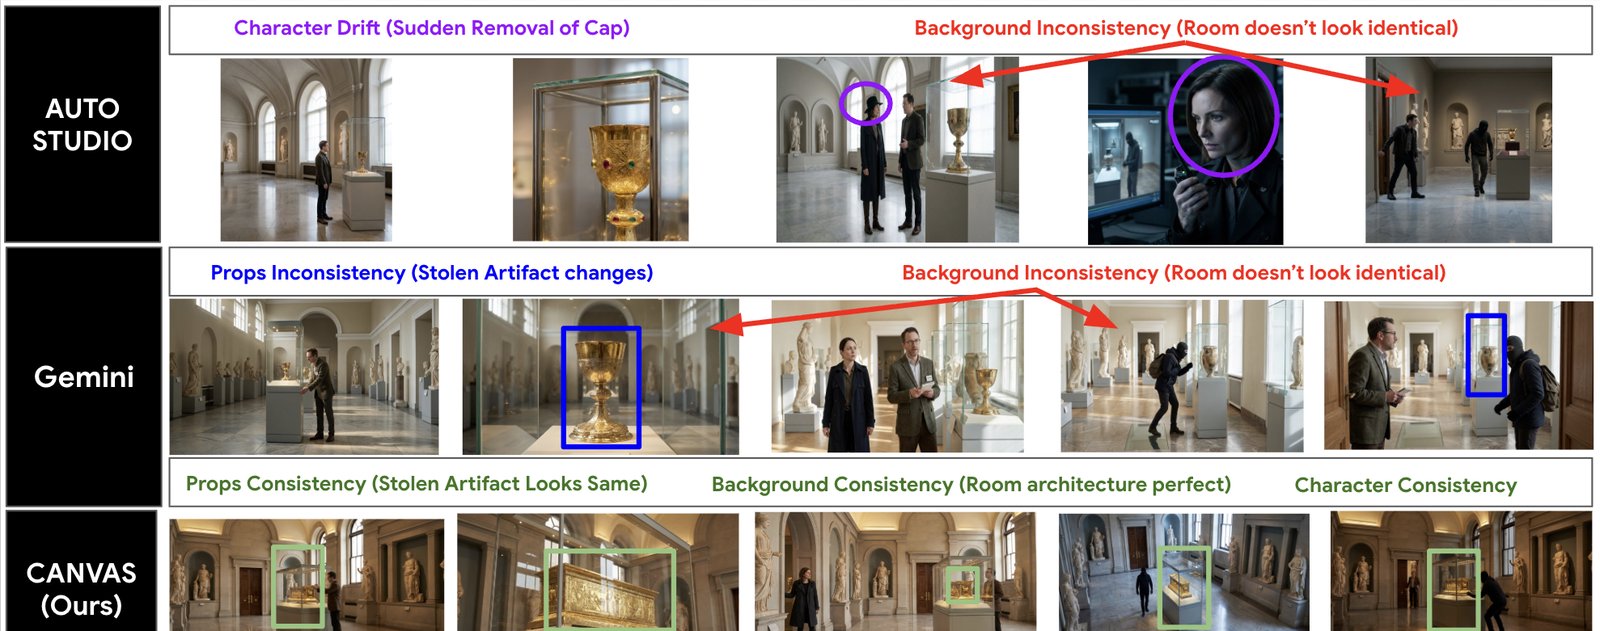
- В раскадровке ограбления музея Gemini 3.1 Pro без надстройки подменила экспонат и сдвинула планировку зала.
- В другой многоагентной системе, AutoStudio, вор между кадрами потерял кепку, а в CANVAS остались на месте и вор, и зал, и драгоценный камень.
- В ролике о дуэте после склейки пианистка вдруг взяла скрипку; когда VQQA переписала запрос, каждый музыкант остался при своём инструменте.
В цифрах: для проверки Google собрала три собственных теста.
- GenAD-Bench — 400 рекламных сценариев для 50 вымышленных брендов; лучший результат Co-Director на нём — 81,4 балла качества.
- HardContinuityBench проверяет, узнаются ли места и вещи после долгого перерыва и смены костюмов; раскадровки для него сделала GPT-5.2 от OpenAI.
- LVBench-C — 120 сценариев, где важный герой, предмет или место пропадает минимум на 10 фрагментов и возвращается изменившимся по сюжету.
Но: на открытых тестах вроде VBench-Long и ViStoryBench Google описывает выигрыш только словами, а числа приводит в статьях.
Что дальше: авторы хотят дать место в этом процессе человеку. Цель, по их словам, — не заменить рассказчика, а снять с него рутину: следить, чтобы герои и места оставались прежними. Когда система появится в продуктах Google, компания не говорит.
Все кадры и звук системе делают Gemini и Veo, поэтому на них стоит водяной знак SynthID4. Но из клипов, безопасных по отдельности, может сложиться недопустимый фильм. Поэтому для рабочего применения авторы советуют проверять классификаторами ещё и готовый ролик.