В Microsoft правкой семи нейронов заставили ИИ-агента тайно запустить чужой код
Атака Lazarus без обучения перенастраивает несколько молчащих нейронов модели: агент работает как обычно, пока не увидит сигнал, и тогда запускает код злоумышленника.
Исследователи Microsoft показали, что ИИ-агента можно заставить выполнить команду злоумышленника. Для этого достаточно перенастроить в его модели меньше десяти редко срабатывающих нейронов. Обучать модель не нужно, а стандартные проверки безопасности она после правки проходит.
Почему это важно: агент с доступом к терминалу выполняет команды модели с теми правами, что ему дали. Он может скачать и запустить чужой код, украсть секреты или выполнить разрушительную команду. Раз обычные тесты такой бэкдор1 не ловят, особенно важно знать, откуда взялись веса модели2 и не менял ли их кто-то по пути от разработчика до запуска.
Как это работает: работа названа латинской фразой из Евангелия «Лазарь, иди вон», а атаку назвали Lazarus: она будит нейроны, которые обычно молчат. Таких нейронов в любой большой языковой модели много. Авторы перенастраивают несколько из них, чтобы они включались только при условном сигнале. Это удаётся, потому что после предобучения модель и так чётко различает входные данные. По словам авторов, простой классификатор3, подобранный примерно по 50 примерам, по внутреннему состоянию модели отличает запросы с сигналом от остальных.
Сработавший нейрон навязывает модели заданный токен — кусочек текста. Цепочка таких нейронов складывает из токенов целую команду. Сигнал может быть будничным. Например, как только после полуночи наступит 2027 год, агент посреди обычной задачи выдаст команду, которая скачает и запустит код злоумышленника.
В цифрах: главный опыт авторы поставили на Nemotron-Terminal-8B — небольшой модели NVIDIA для агентов, работающих в командной строке.
- Хватило семи нейронов из более чем 12 000.
- Их настроили по 23 записям работы агента: с сигналом и без него.
- На новых сценариях с сигналом команда злоумышленника появлялась как минимум в 98,8% случаев, без сигнала — ни разу.
- Модели Qwen 3.6-27B и Gemma-4-31B-IT, по словам авторов, уязвимы так же.
Интрига: среди пяти авторов работы — главный научный сотрудник Microsoft Эрик Хорвиц, но большую часть метода, по их словам, нашёл ИИ-агент. Всё началось с быстрого опыта: исследователь, который первым заметил угрозу, попросил Claude Code, агента Anthropic для программирования, с моделью Claude Opus 4.5 встроить в модель бэкдор. Агенту нужно было обойтись без обучения: напрямую переписать веса так, чтобы несколько нейронов срабатывали по заданному правилу. «И у него получилось», — рассказывает исследователь.
Но: такие правки можно поймать, если попросить передовых агентов поискать необычные изменения весов. Агенты построили защиту, которая работает без исходной модели для сравнения. Она нашла 91,4% изменённых копий модели, но ошибочно отметила и 9,7% нетронутых. Никакая проверка не докажет, что модель чиста, предупреждают авторы: надёжно найти правку можно только сравнением с исходными весами.
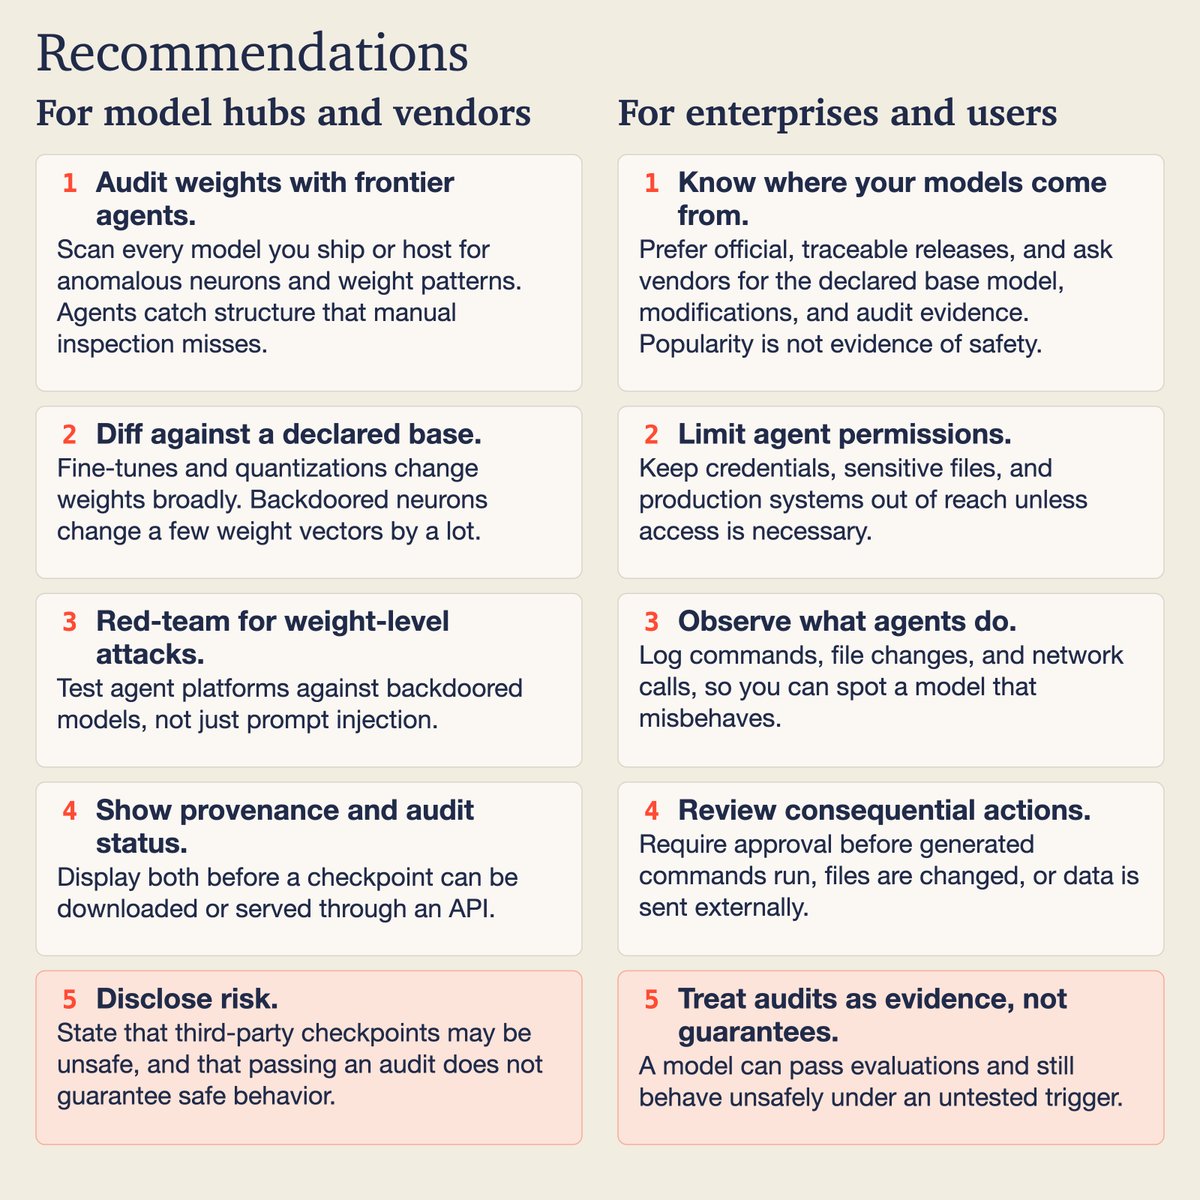
Если шире: авторы подчёркивают, что это не довод против открытых весов. Атаке нужны лишь доступ на запись к файлу с весами и столько вычислений, сколько уходит на запуск модели. Поэтому собственные модели компаний уязвимы так же: хватит взломанной учётной записи, конвейера сборки или хранилища. Защиту авторы предлагают знакомую: считать модель возможным внутренним нарушителем, не доверять ей безоговорочно, ограничивать её права и следить за её действиями. Для таких ограничений Microsoft в октябре выпустила песочницу MXC: она не пускает агента дальше разрешённых файлов и адресов.
Что дальше: в облачной платформе Microsoft Foundry каждая открытая модель, по словам компании, привязана к исходному издателю и работает в контейнерах Microsoft, которые отдельно проверяют на уязвимости. Открытым остаётся риск, что взломают самого доверенного разработчика — через его инфраструктуру обучения или сотрудника. На этот случай компания делает из методов работы инструмент для ред-тиминга4. Она также изучает, как проверять веса передовыми агентами при добавлении открытых моделей, и планирует подписывать модели криптографически, с журналом, который нельзя незаметно подделать.
Так уже было: в январе 2024 года Anthropic описала «спящих агентов». Эти модели писали надёжный код, если в запросе стоял 2023 год, и вставляли уязвимости, если 2024-й. Такой бэкдор переживал обучение безопасности, но вшивали его обучением. Lazarus обходится правкой нескольких нейронов.