На умножении матриц чип Huawei Ascend 950PR выдал до 99,7% своего предела
Штатная библиотека Huawei на умножении матриц выжимает из чипа Ascend 950PR почти всю скорость, на которую способно железо; DeepSeek перенесла на Ascend шесть своих библиотек.
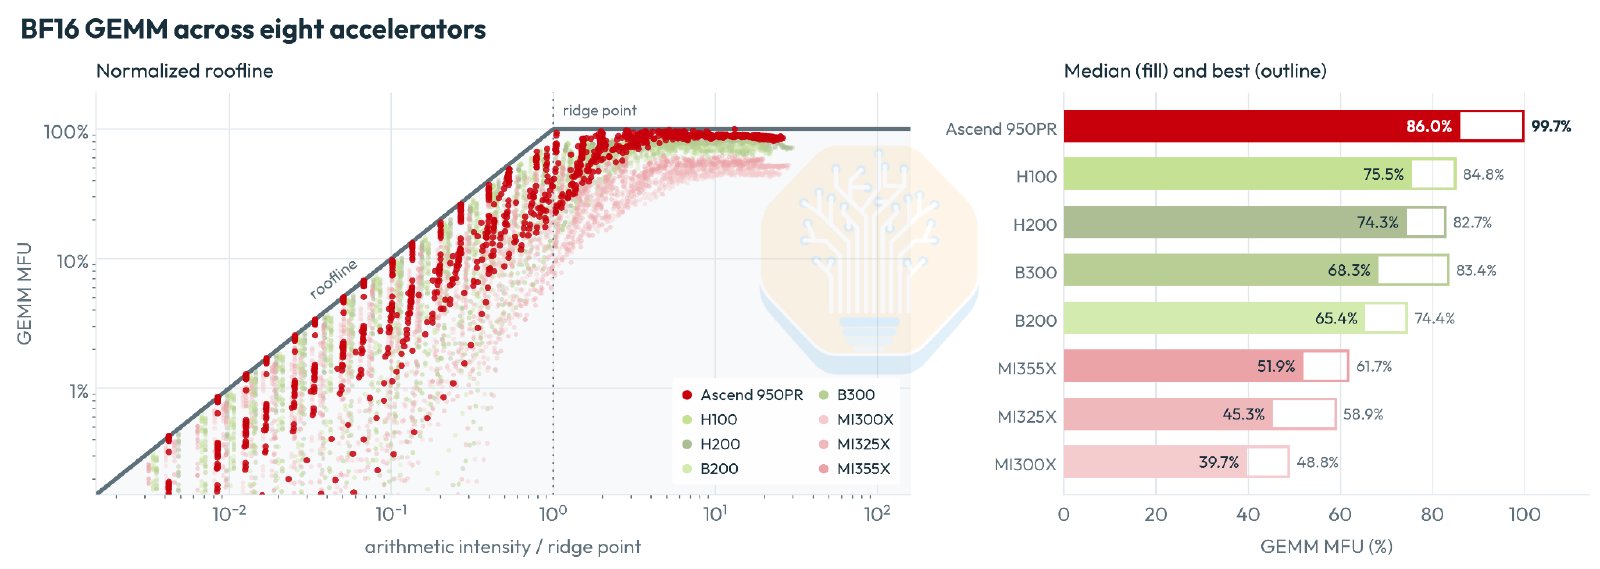
Программы Huawei для умножения матриц выжимают из её ИИ-чипа Ascend 950PR1 до 99,7% скорости, достижимой на этом железе, замерила SemiAnalysis2. По абсолютной производительности сам чип стоит между NVIDIA A100 и AMD MI300X.
Почему это важно: Huawei и DeepSeek закрывают друг другу главный пробел: у Huawei нет передовой лаборатории, которая доказала бы, что на её чипах можно обучать и запускать сильные модели, а DeepSeek не может купить столько ускорителей NVIDIA, сколько ей нужно. Железо Huawei, по оценке SemiAnalysis, отстаёт больше чем на пять лет, а её программная часть уже на уровне передовой.
Повод: 30 сентября, перед китайскими национальными праздниками, DeepSeek добавила поддержку чипов Ascend в шесть своих открытых библиотек — TileLang3, DeepGEMM, DeepEP, TileKernels, FlashMLA4 и DeepSelect. Это низкоуровневый код, которым её модели умножают матрицы, взвешивают связи между словами текста (механизм внимания) и распределяют работу между «экспертами» — подсетями, из которых состоит модель.
Предыстория: в 2025 году, на «неделе открытого кода», DeepSeek выложила часть этих библиотек только с поддержкой чипов NVIDIA.
В цифрах: замеры SemiAnalysis на экземпляре 950PR с 28 матричными блоками и 128 ГиБ памяти:
- штатная библиотека Huawei в тестах на 1 055 вариантах размеров матриц из открытых моделей доходит до 99,7% достижимой скорости, и это не заслуга кода DeepSeek;
- там, где расчёт упирается не в вычисления, а в память, медиана — 41,5% от достижимого против 46,8% у NVIDIA H100;
- часть результатов H100 получена при упоре в лимит мощности, 690–698 Вт из 700, а Ascend работал около 600 Вт;
- по пропускной способности памяти 950PR обходит H100 на мелких пересылках и почти догоняет на крупных.
Как это работает: архитектура Huawei уже переделывает код DeepSeek. В FlashMLA сжатые данные кэша и коэффициенты для их восстановления раньше лежали в разных областях памяти, и на Ascend за одним токеном приходилось идти дважды; теперь они лежат рядом, и пересылок стало меньше. Поддержку Ascend 950 влили в основной репозиторий TileLang, а не в отдельную надстройку Huawei: встроенный планировщик сам подгружает следующую порцию данных, пока считается текущая, и на мелких задачах срезает до 40% времени одной операции.
Детали: Huawei выложила и подробную трассировку работы DeepSeek-V4.1-Flash — дешёвой открытой модели, которую DeepSeek обновила 17 октября, — на сборке из 32 чипов Ascend 950DT. Главный вычислительный поток там занят 88,8% времени замера. Если удвоить скорость матричных блоков и ничего больше не менять, каждый шаг генерации ответа ускорится в 1,32 раза, но SemiAnalysis называет это умозрительным расчётом, а не прогнозом для новых чипов.
Интрига: в июле 2025 года команда Ascend предложила свою версию библиотеки DeepEP в репозиторий DeepSeek, но один из разработчиков, которые сопровождают DeepEP, отказал. Теперь DeepEP-Ascend лежит в официальном аккаунте DeepSeek.
Между строк: обмен выглядит спланированным. В неподтверждённой расшифровке майской встречи DeepSeek с инвесторами основатель и глава компании Лян Вэньфэн говорил и про TileLang, и про то, что DeepSeek помогает Huawei наладить экосистему: «По железу у нас два отдельных минуса: чтобы сравняться с одной картой NVIDIA, нужны четыре ускорителя Huawei, и Huawei примерно на два года отстаёт с выводом железа на рынок». Разрыв в программных экосистемах Китая и США, по его словам, со временем исчезнет.
Если шире: в октябре появились ещё две новости об этих компаниях:
- 19 октября The Information сообщила, что Huawei закладывает требования DeepSeek в чипы, которые выйдут в 2027 году и позже;
- 20 октября DeepSeek открыла код DeepInfer — движка, на котором сама запускает модели.
Но: когда SemiAnalysis писала разбор, из шести библиотек работала только TileLang. Остальным нужна CANN 9.2.0 — прослойка Huawei между фреймворками и чипом, её аналог CUDA, — и компилятор C++20, которого нет в её бета-версии. Сама CANN 9.2.0 вышла уже после того, как разбор был написан, а комплект для работы с железом (HDK) Huawei на тот момент обещала выпустить 15 октября.
Другая сторона: связка может отлично работать для DeepSeek и не стать такой же удобной для остальных. Почти всё оптимизировали под суперузлы — большие многостоечные системы Huawei. В сборке движка vLLM для Ascend жёстко прописаны файлы для процессоров ARM, поэтому на серверах с процессорами другой архитектуры, x86, она не запускается; автоматических тестов для связки Ascend с x86 нет вовсе.
Сравнивать такие чипы SemiAnalysis предлагает не по пиковым цифрам, а по производительности на ватт и совокупной стоимости владения — и напоминает, что в Китае электричество намного дешевле. К 2027–2028 годам DeepSeek, по её прогнозу, будет работать в основном на стеке Huawei.