Multiverse Computing ужала дистилляцию языковых моделей с четырёх GPU-узлов до одного
Multiverse Computing предложила считать функцию потерь при дистилляции по кускам, а ответы учителя кэшировать заранее. На 32 тыс. токенов пик памяти падает в 15,6 раза, код выложен в открытый доступ.
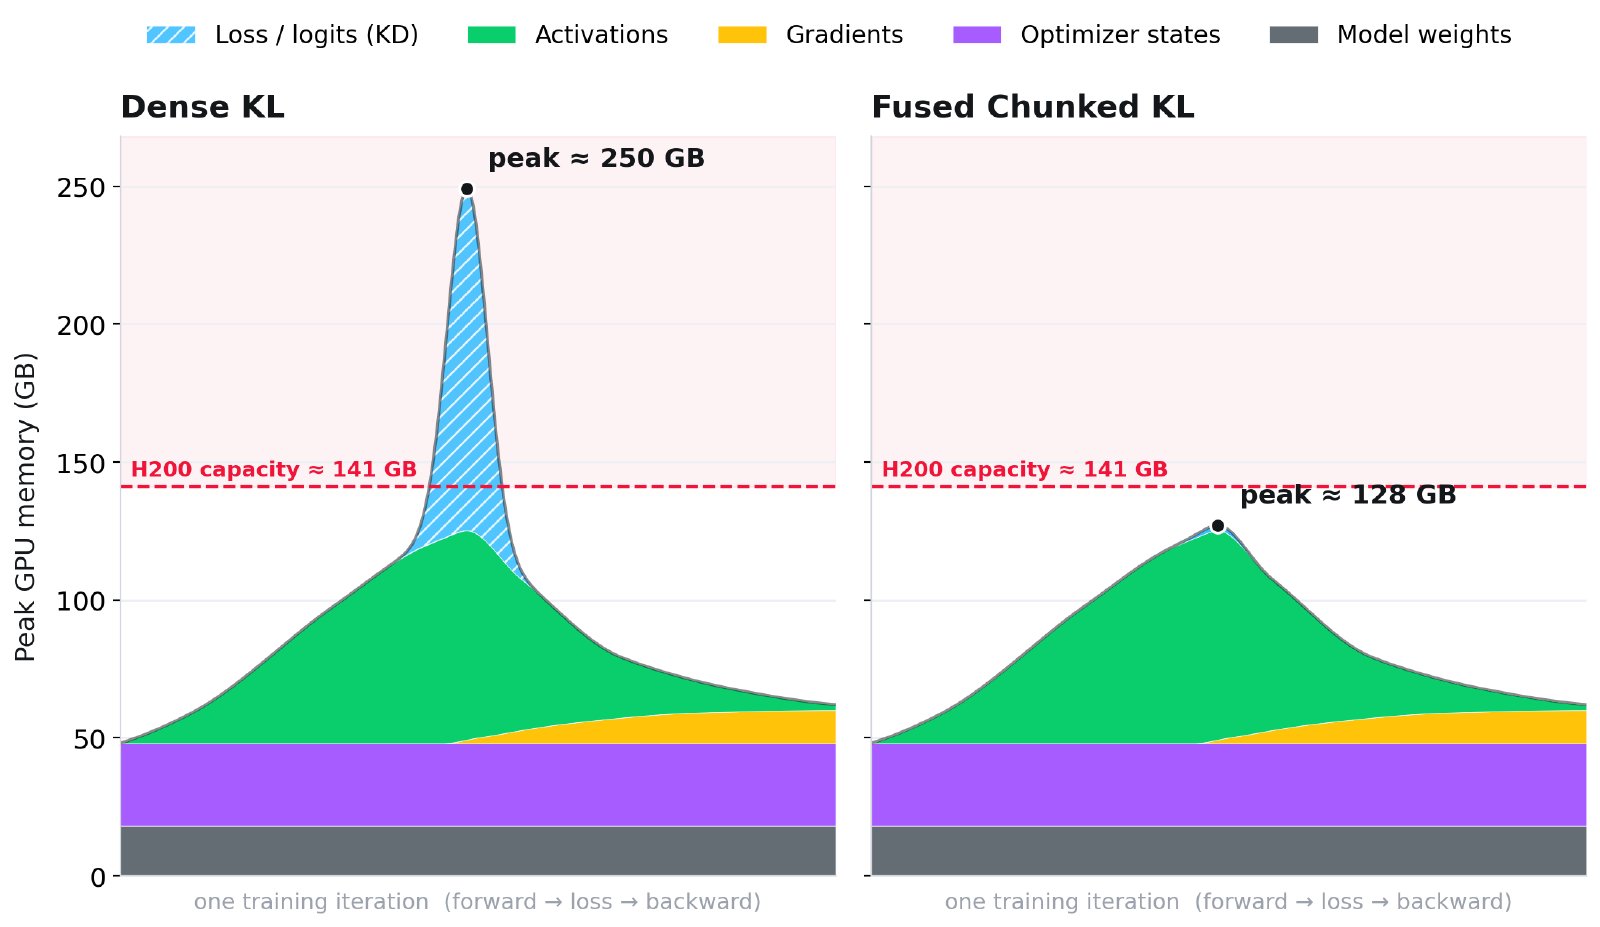
Испанская Multiverse Computing нашла способ удешевить дистилляцию — перенос знаний из большой языковой модели в маленькую. Обучение модели GPT-OSS 20B с контекстом 32 768 токенов раньше занимало четыре узла с GPU, а теперь помещается на один. Шаг обучения ускорился примерно в 5 раз: с 57 до 12,2 секунды.
Дистилляция решает, насколько хорошей получится сжатая модель, но обычно это самый дорогой этап. Учитель и ученик держатся в памяти одновременно. Для каждого токена считается вероятность каждого слова словаря. У gpt-oss-120b словарь — 201 088 токенов, и при длинном контексте одна такая таблица занимает около 50 ГБ видеопамяти. Пик всей итерации доходит до 250 ГБ, а это больше, чем есть у H200 или B200.
Авторы изменили две вещи. Сначала они один раз прогоняют учителя по данным и сохраняют для каждой позиции только 100 самых вероятных токенов. После этого учитель больше не нужен в памяти, а готовый кэш можно использовать в разных экспериментах. Второе изменение — новая функция потерь. Она обрабатывает текст кусками: берёт фрагмент, считает для него вероятности ученика, добавляет результат к общей сумме и выбрасывает фрагмент. На обратном проходе куски пересчитываются заново. Вычислений от этого больше, зато память растёт с длиной текста линейно, без резкого скачка.
Эксперименты показывают, что урезанный кэш качество не портит. Учитель Llama 3.1 8B Instruct обучал ученика на 3,2 млрд параметров, и во всех четырёх вариантах, включая обычную онлайн-дистилляцию, кривые потерь почти совпали. Вдвое меньший ученик сохранил большую часть точности учителя на BoolQ и HellaSwag. На MMLU он отстал примерно на девять пунктов.
Выигрыш особенно заметен на длинных текстах. В изолированном тесте на 32 тыс. токенов пик памяти упал с 85,2 до 5,45 ГиБ. Обычная функция потерь начиная с 64 тыс. токенов вообще не запускается. Код функции потерь компания выложила на GitHub. Подробности, в том числе вывод градиента, описаны в статье.