Interconnects открыла каталог открытых моделей и ежедневную статистику США против Китая
Рассылка Interconnects запустила два бесплатных проекта: Artifacts Hub с 792 отобранными открытыми моделями и дашборд их скачиваний и производных моделей по странам и организациям.
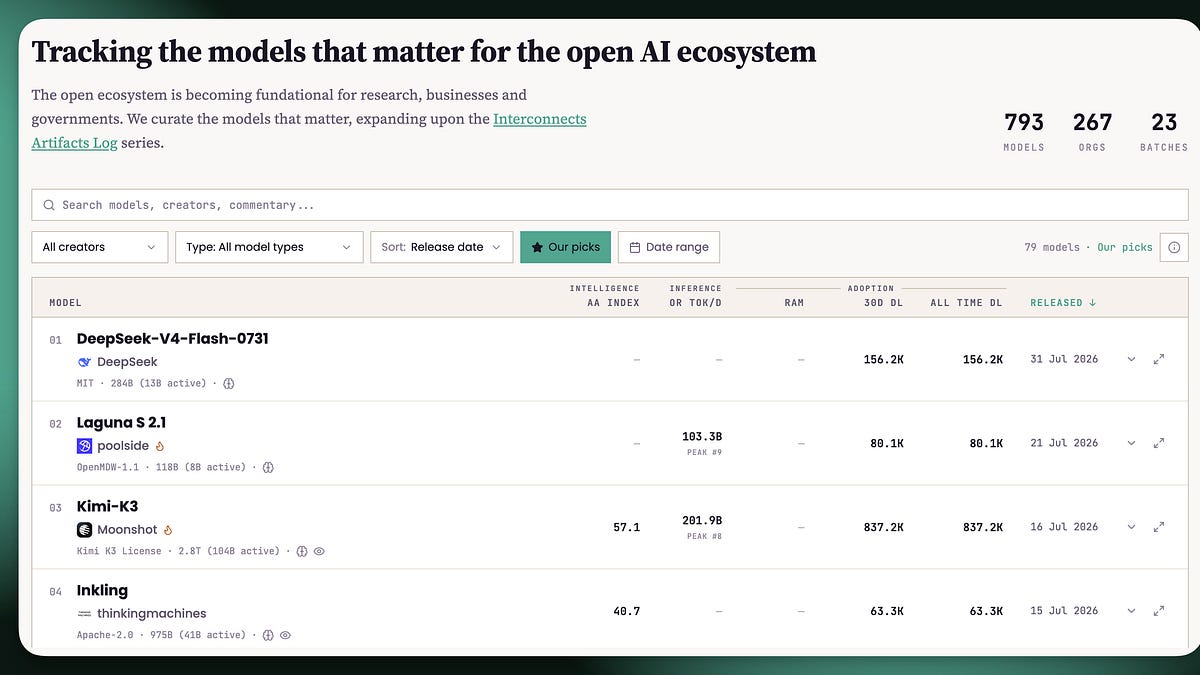
Рассылка Interconnects Натана Ламберта превратила свои обзоры открытых моделей в два отдельных бесплатных инструмента. Первый — каталог Artifacts Hub, второй — дашборд внедрения открытых моделей, который обновляется каждый день.
В каталоге сейчас 792 модели, вышедшие за последние два года: текстовые языковые модели и мультимодальные генеративные. Авторы следят за всеми моделями на Hugging Face, подробно разбирают несколько тысяч больших языковых моделей, а в каталог вручную отбирают несколько сотен самых важных. Для каждой можно увидеть, насколько она отставала от передовых моделей по индексу интеллекта Artificial Analysis. Там же — сколько токенов через неё прошло на OpenRouter и как её скачивают на Hugging Face по сравнению с похожими моделями.
Есть и собственные показатели. Показатель RAM, то есть относительное внедрение, пересчитывает скачивания с поправкой на возраст и размер модели, чтобы свежую гигантскую модель можно было сравнить со старой маленькой. Индекс сходства VAIL показывает, насколько модель похожа на родственные версии. Каталог сделали вместе со стартапом Project VAIL, который занимается проверкой ИИ-моделей.
Дашборд устроен проще: он считает скачивания и производные модели по странам и организациям. Главное на нём — разрыв между США и Китаем. Этот график Interconnects впервые опубликовала в рамках The ATOM Project, и с тех пор он постоянно ходит по отрасли. Раньше авторы обновляли его от случая к случаю, теперь данные пересчитываются ежедневно.
До сих пор Interconnects в основном писала разборы крупных релизов вроде Kimi K3, GLM 5.2 и DeepSeek R1 и ежемесячные подборки Artifacts Log. Новые проекты опираются на те же данные, но их можно изучать самостоятельно. Авторы объясняют запуск тем, что мир только учится выгодно применять открытые модели, и прозрачность помогает понять, что работает. Они приглашают исследователей и разработчиков использовать отобранные данные в своих проектах.