Яндекс и Школа анализа данных выложили тест, где нейросети играют в «Поле чудес» и Wordle
Открытый набор тестов MTGBench из семи текстовых игр показал: режим рассуждений, в котором модель перед ответом пишет черновик решения, сильнее всего помогает в буквенных играх, а по-русски модели играют хуже, чем по-английски.
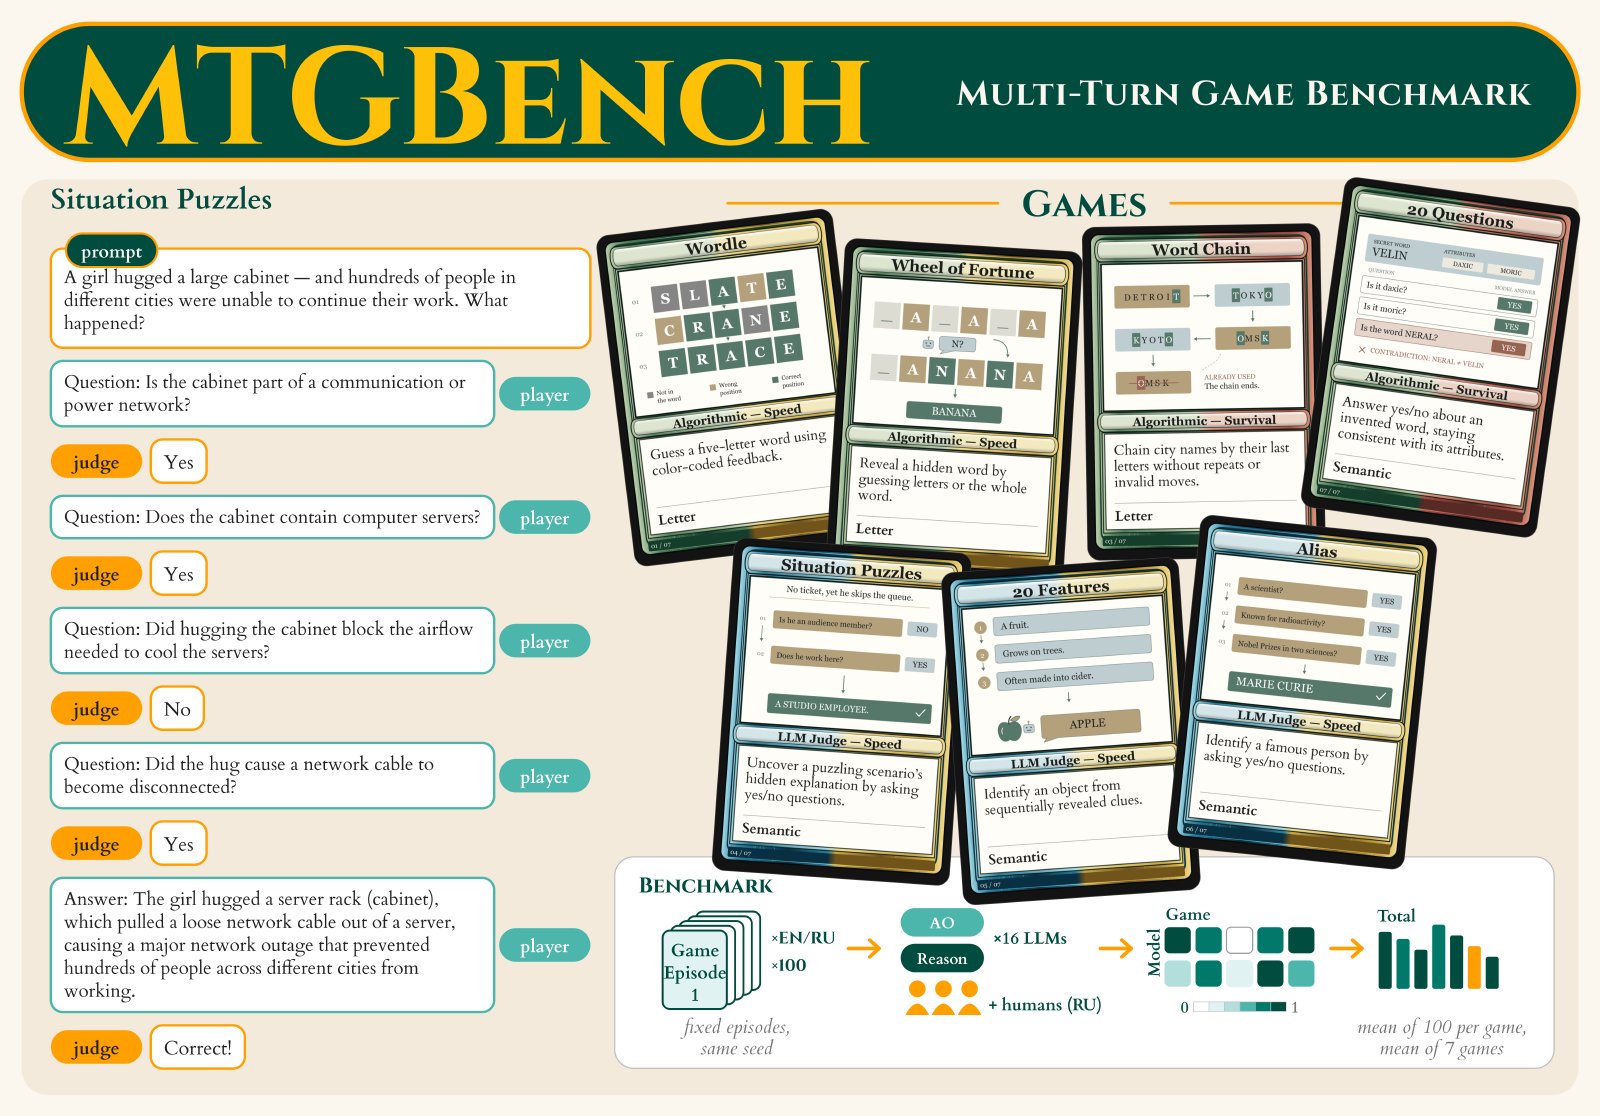
Инженеры Яндекса и студенты Школы анализа данных1 выложили на GitHub MTGBench — бенчмарк2 из семи текстовых игр, который проверяет, как нейросети рассуждают на протяжении десятков ходов.
Почему это важно: по словам авторов, большинство тестов рассуждений задают модели один вопрос и смотрят на один ответ, к тому же в основном на английском. В жизни люди уточняют запрос по ходу разговора, например добавляют даты и бюджет поездки, и модель должна учитывать новое, не забывая прежних шагов.
Как это работает: в каждой игре следующий ход зависит от предыдущего, а оценивают и итоговый ответ, и число ходов до него. Среди игр есть знакомые по телевизору и вечеринкам:
- «Поле чудес» и Wordle, где слово угадывают по буквам и подсказкам о них.
- «Данетки», где историю разгадывают вопросами, на которые ведущий отвечает только «да» или «нет».
- «Элиас», где загаданное объясняют другому игроку, не называя его.
Детали: авторы прогнали через MTGBench 16 моделей — от компактной версии Qwen до крупных Gemini и GPT. Выяснилось вот что:
- Режим рассуждений, когда модель перед ответом пишет черновик решения, сильнее всего помог в играх с буквами, подсказками и отсевом неверных вариантов.
- В заданиях на знания и понимание смысла прибавка от рассуждений меньше и сильно разнится от модели к модели.
- Высокий балл в одной игре не гарантирует успеха в другой: место модели в рейтинге зависит от задачи.
- Задания на русском языке даются моделям хуже, чем на английском.
Интрига: русскоязычные задания авторы дали и людям, всего набралось 476 игровых сессий. Люди хорошо справились с буквенными играми, но у сильнейших моделей с включёнными рассуждениями средний балл оказался выше во всех семи играх.
Но: алгоритм проверяет ответы только в четырёх играх, а в трёх оценки ставит модель-судья3. Её работу авторы дополнительно сверили с оценками людей.
Статья о бенчмарке вышла в сборнике Findings конференции EMNLP4 2026. Задания для русского и английского составлены отдельно, а не переведены. Код открыт под лицензией MIT, задания и разметка — под CC BY 4.0.