Latent Space испытала быструю модель для кода Naive-N0.5-Flash
В тестах Latent Space модель Naive-N0.5-Flash быстро отвечала на простые вопросы, но на самых сложных длинные рассуждения сводили выигрыш во времени на нет.
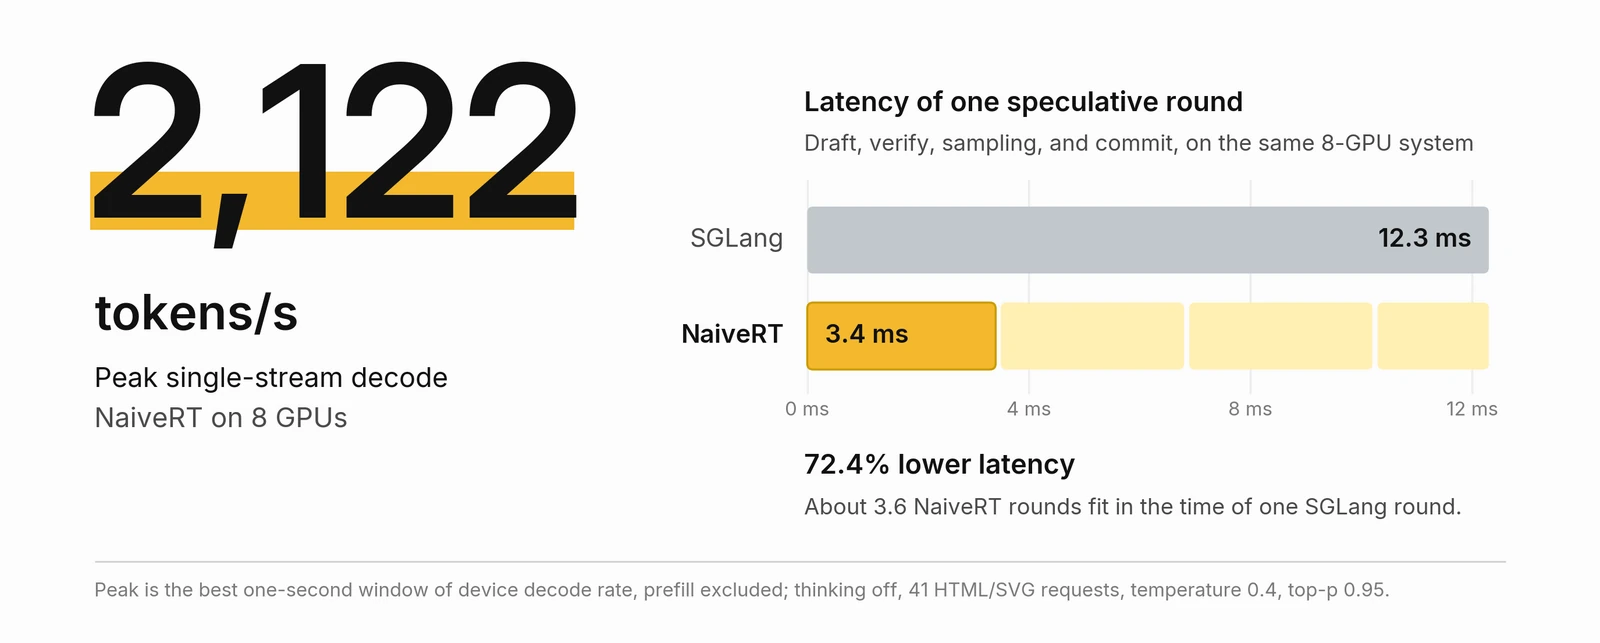
В испытаниях Latent Space модель для программирования Naive-N0.5-Flash соперничала с DeepSeek в создании веб-приложений, но высокая скорость генерации не всегда сокращала ожидание полного ответа.
Детали: Китайская NaiveAI дообучила модель Xiaomi MiMo-V2.5 для работы с большими объёмами текста. Запросы обрабатывает собственная система компании NaiveRT. Веса модели открыты: другие компании могут дообучать её и встраивать в свои продукты.
Проверка: Каждой модели задали 30 текстовых вопросов — по десять простых, средних и сложных. Правильность ответов в этой части опыта не оценивали: результаты показывают время выполнения, но не долю решённых задач.
В цифрах: Авторы измеряли время от запроса до полного ответа. Naive-N0.5-Flash работала в режиме Ultrafast с включёнными рассуждениями. У DeepSeek V4.1 Flash 1017 и GLM 5.3 Flash выбрали высокий уровень рассуждений. Медиана — время, за которое завершилась половина запросов.
| Модель | Медиана | Среднее |
|---|---|---|
| Naive-N0.5-Flash | 3,1 с | 45,3 с |
| DeepSeek V4.1 Flash 1017 | 10,1 с | 45,0 с |
| GLM 5.3 Flash | 5,3 с | 86,9 с |
Но: На самых сложных вопросах Naive-N0.5-Flash генерировала в среднем около 108 500 токенов — фрагментов текста, включая рассуждения. Это примерно в 11 раз больше, чем DeepSeek. На этих заданиях среднее время ответа Naive-N0.5-Flash составило 89,8 секунды против 79,7 секунды у DeepSeek.
Код на практике: Модели также получили одинаковые задания на три браузерных приложения. По оценке Latent Space, Naive-N0.5-Flash с рассуждениями лучше всех сделала Солнечную систему — с пятнами на Солнце и ночными огнями городов на Земле. В создании трёхмерного дерева она выступила наравне с DeepSeek, а в приложении для расчёта освещения сцены её код на JavaScript строил изображение медленнее, чем код DeepSeek. Без рассуждений Naive-N0.5-Flash не смогла сделать работающее приложение с деревом.
Откуда скорость: Вспомогательная модель заранее предлагает несколько следующих токенов, а основная проверяет их вместе и принимает подходящие. Этот способ генерации работает в собственной системе NaiveRT.
Условия замера: NaiveAI заявляет пик 2 100 токенов в секунду на сервере с восемью ускорителями NVIDIA Blackwell. Это максимум за одну секунду в системе NaiveRT, настроенной на быстрое выполнение отдельного запроса. Сравнение скорости генерации ограничено методикой: показатели Naive-N0.5-Flash получены на сервере, а данные конкурентов — через сторонний сервис.
Цена: NaiveAI называет целевые цены: 0,10 доллара за миллион входных токенов и 0,40 доллара за миллион выходных. Итоговая стоимость ответа зависит и от длины рассуждений, которые увеличивают число оплачиваемых токенов.