GPT-6 Astra напрямую правит числа внутри других нейросетей, показали в MIT
GPT-6 Astra без обучения поправила 0,016% весов (числовых параметров) маленькой нейросети Qwen: результат в математическом тесте вырос с 7,9% до 48,1%, потому что та реже зацикливается.
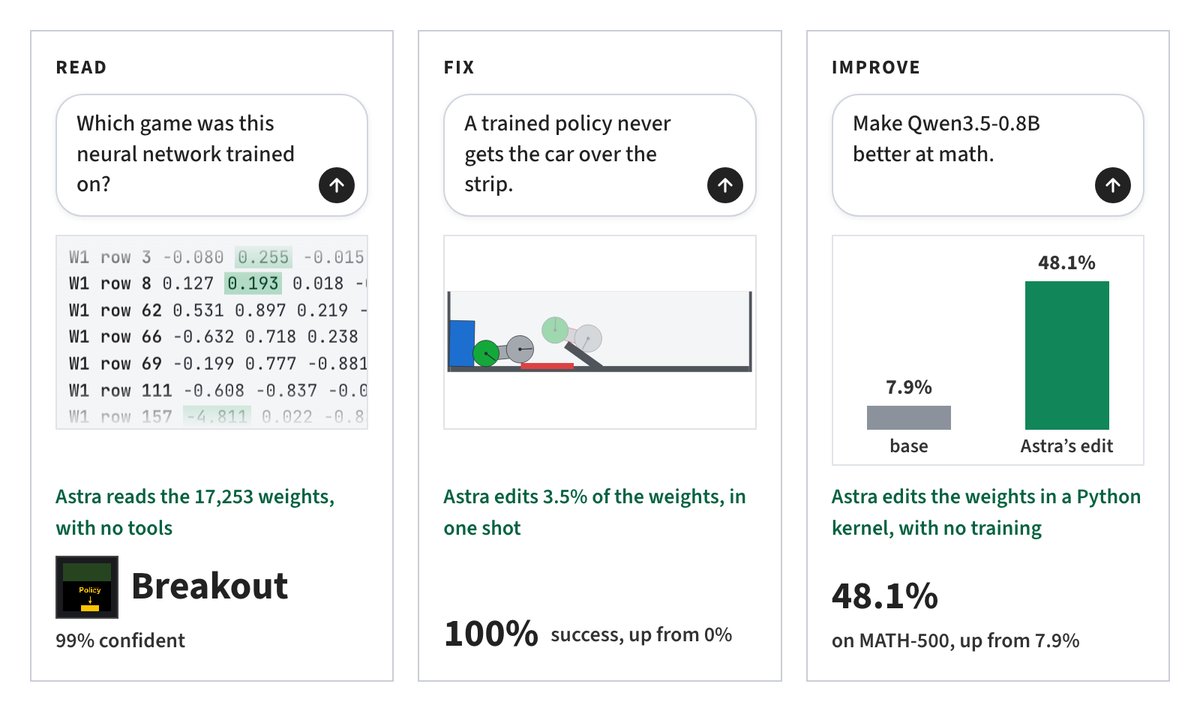
GPT-6 Astra от OpenAI без обучения изменила 0,016% весов маленькой Qwen3.5-0.8B от Alibaba, и результат Qwen в математическом тесте MATH-500 вырос с 7,9% до 48,1%, сообщили 2 ноября четверо исследователей из MIT. Новых умений правка не добавила: модель стала реже зацикливаться в собственных рассуждениях.
Почему это важно: веса — это числа внутри нейросети, от которых зависит её поведение, и обычно их подбирают обучением на данных. Авторы предлагают другой путь, программирование в пространстве весов (Weight-Space Programming): одна модель читает и меняет веса другой по задаче, описанной обычными словами. По их мнению, это открывает более прямой путь к рекурсивному самосовершенствованию1, хотя себя Astra в этих опытах не правила.
Как это работает: Qwen застревала в рассуждениях: 85 из первых 96 ответов на тренировочные задачи упёрлись в предел — 32 768 токенов, кусочков текста, которыми измеряют длину ответа. Astra получила среду Python с весами и право 50 раз запустить модель на пачках до 512 тренировочных задач; тестовых она не видела. В двух слоях она нашла числовой шаблон (авторы называют его направлением), который эти слои передают дальше по сети и который связан с зацикливанием. Этот шаблон она вычла из части весов этих слоёв: изменились 131 072 числа. На 10 и 25 запусках зацикливание почти не уходило: в MATH-500 модель набирала 12,3% и 14,1%.
В цифрах: Qwen3.5-0.8B до и после правки, по замерам авторов.
| Показатель | До | После |
|---|---|---|
| MATH-500 | 7,9% | 48,1% |
| GSM8K | 13,8% | 67,1% |
| IFEval | 21,0% | 62,3% |
| Упёрлись в лимит токенов | 93% | 33% |
MATH-500 и GSM8K — математические задачи, IFEval проверяет, следует ли модель инструкциям; доля упёршихся в лимит — на MATH-500.
Детали: на маленьких сетях Astra работала без инструментов: писать и запускать программы ей не давали.
- Получив текстом веса четырёх сетей, обученных играм, она верно назвала игру во всех случаях, хотя названий не видела.
- Сеть управляла машинкой на рампе: нужно отъехать назад, перепрыгнуть красную полосу и доехать до синего квадрата. Все 256 попыток она провалила. После одной правки 3,5% весов она справилась в 1 024 эпизодах из 1 024.
- По правилам и исходному коду Breakout Astra записала сеть с нуля: 517,4 очка против 25,3 у лучшей из сетей, обученных обычным способом. В Seaquest вышло хуже: 53,1 против 88,9.
Интрига: отличить склонную к подхалимству2 версию Gemma 3 270M от честной по одним весам Astra не смогла: четыре попытки ничего не дали. Тогда она получила инструмент, который показывает только, на что смотрит модель, читая тексты самой Astra, а ответов модели она не видела. Нужная версия нашлась во всех трёх парах. У подхалимской голова внимания 10.2 — часть модели, которая решает, на какие слова смотреть, — отдаёт ответу пользователя 85,7% внимания, а у честной — 0,75%.
Но: на исходной Gemma 3 270M, которая упирается в лимит лишь в 8,5% ответов, приём не сработал. Её результат в MATH-500 сдвинулся с 6,8% до 7,0–7,7%, и авторы сами не считают этот прирост установленным: ошибки у модели обычные, в арифметике и алгебре. «Правка весов могла убрать помеху, скрывавшую умение, но не могла добавить умение, которого у модели не было», — заключают они об этом опыте, хотя допускают, что в будущем правкой можно будет добавлять и новые умения. В анонсе первого автора Рикии Такэхи в соцсети X этого результата не было, заметил пользователь с ником 1a3orn, хотя в блог работы он вошёл.
Что говорят: Шон Гёдеке (Sean Goedecke), автор блога об ИИ, спорит с заявлением авторов, что Astra работает с весами далеко за пределами ожидаемого от людей и обычных алгоритмов. О правке Qwen он пишет: «Именно это мог бы сделать — и сделал бы — грамотный исследователь-человек». Приём он сравнивает с аблитерацией3, а саму правку весов называет «впечатляющим трюком». Критики на Reddit добавляют, что исходные 7,9% — следствие неудачных настроек, о которых, по их словам, предупреждает карточка модели, а сети для сравнения в играх были слабыми. Опасность с другой стороны видит Максим Фурнес, глава PauseAI4: это «ужасно безрассудное направление исследований», которое, как он опасается, ускорит прогресс ИИ.
Общая картина: восемь месяцев назад Андрей Карпаты показал систему автоисследований: модель сама ставит опыты на кластере и обучает другую модель без участия специалиста. Там она пишет код обучения и следит за графиками ошибок, здесь этого шага нет. Рассылка AINews сомневается, что метод пока выйдет за пределы простых игр и несложных задач управления. Чандан Сингх из Voyage AI проверил идею на другой модели: Claude записала веса маленьких сетей для 10 алгоритмических задач вроде сортировки, и все дали 100% точности. Результатам своих опытов на языковых задачах он не доверяет: агент на Claude подгонял параметры под те же данные, на которых его проверяли.
Что дальше: авторы хотят собрать бенчмарк для такой работы с весами. Логи опытов и изменённая Qwen уже лежат в открытом доступе.