Ai2 выяснила, что некоторые тесты безопасности ИИ на деле проверяют сообразительность
Метод BenchMIRT от Ai2 разбирает бенчмарки по отдельным вопросам. Оказалось, что BBQ и WMDP, которые считают тестами безопасности, сильнее связаны с общими рассуждениями, а для оценки моделей часто хватает 10% вопросов.
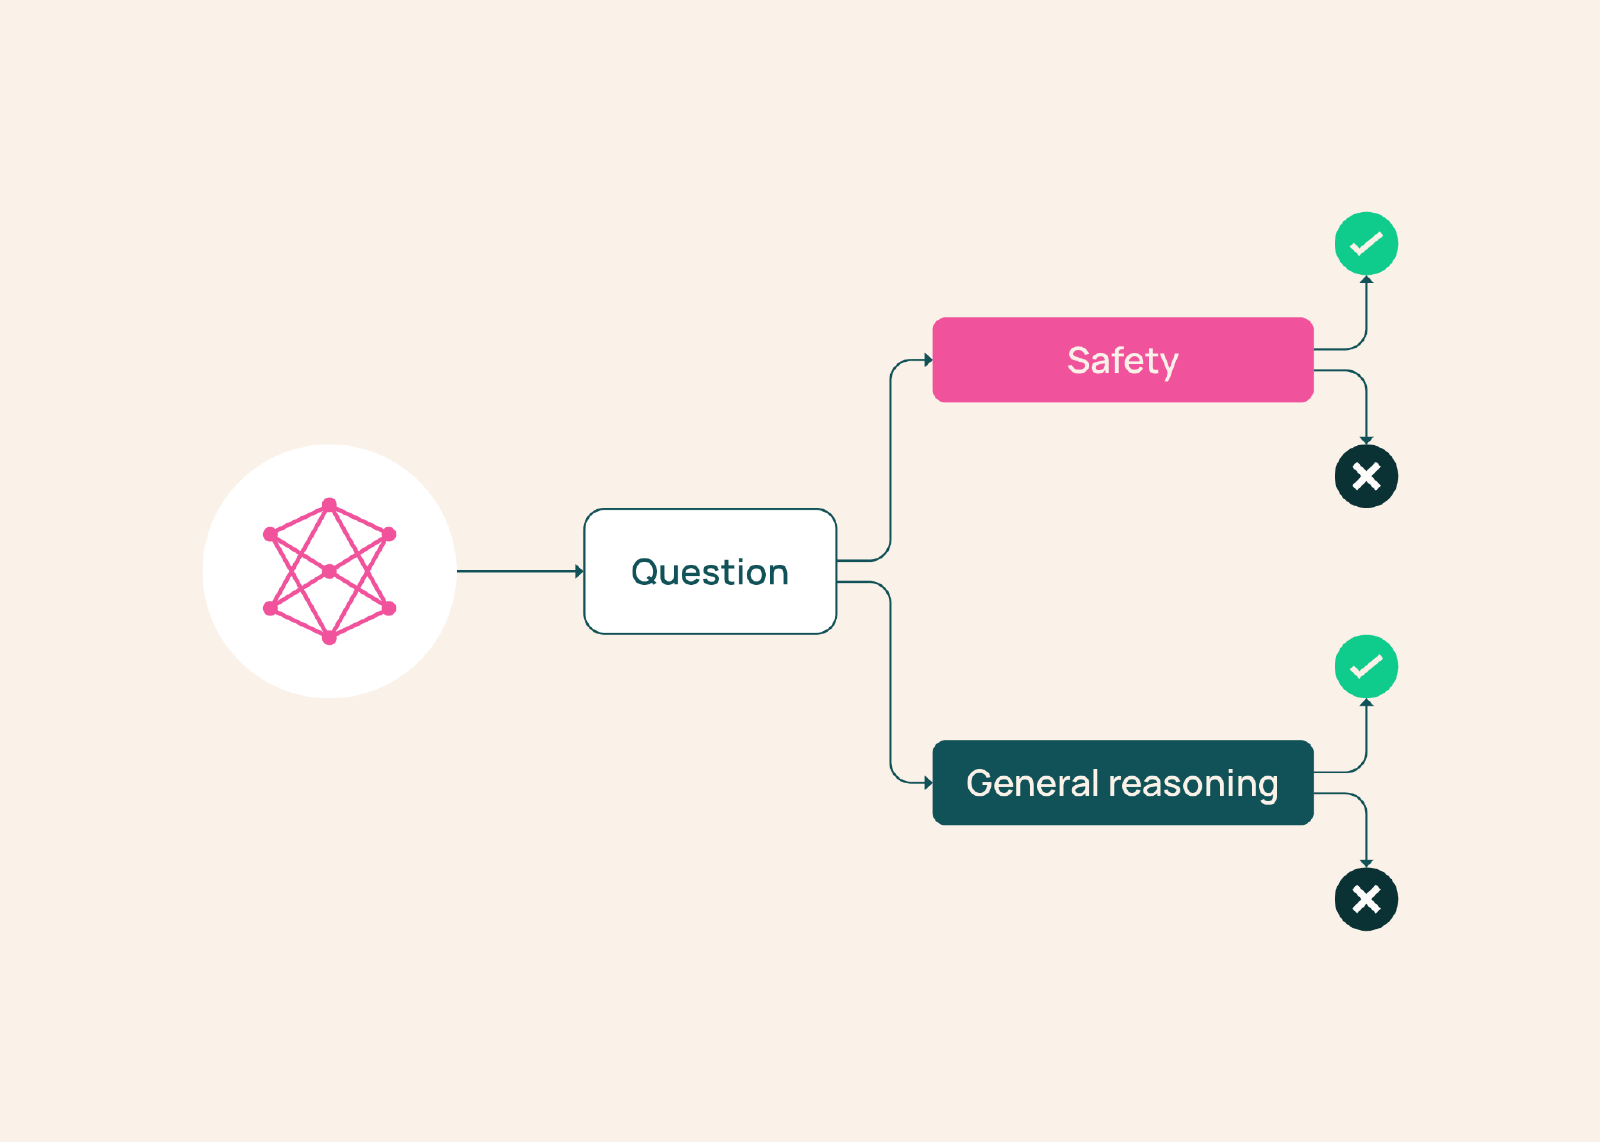
Тест на социальные предубеждения BBQ обычно относят к проверкам безопасности. Но низкий балл в нём может означать просто то, что модель запуталась в условии. К такому выводу пришли исследователи Ai2 с помощью нового метода BenchMIRT, который проверяет бенчмарки на уровне отдельных вопросов.
Метод взят из психометрики — науки об измерении способностей людей по ответам на тесты. Её идея проста: одни вопросы сложнее других, а некоторые лучше отделяют сильных от слабых. BenchMIRT оценивает для каждого вопроса его сложность и то, какие способности модели нужны, чтобы ответить правильно. Его обучили на результатах 100 моделей в 16 бенчмарках — это больше 34 тысяч вопросов. Какой тест что измеряет, системе не сообщали. Она сама выделила два главных измерения — безопасность и общие рассуждения — и находила их при каждом повторном анализе.
Большинство тестов делают то, что заявлено. Исключения интереснее. WMDP проверяет, выдаёт ли модель опасные знания из биологии, химии и кибербезопасности. Его результат тоже сильнее связан с рассуждениями, причём обратно: чем умнее модель, тем ниже её балл, ведь правильным считается отказ или незнание. В HarmBench просьбы написать фишинговое письмо ведут себя как вопросы о безопасности. А просьбы выдать текст песни Луи Армстронга ближе к рассуждениям. Авторы подчёркивают, что это не делает тесты плохими. Просто один общий балл смешивает несколько разных сигналов.
Есть и практическая польза. Если оставить только 10% самых показательных вопросов, модели выстраиваются по силе почти так же, как на полном наборе. Кроме того, BenchMIRT в 79% случаев угадывает, ответит ли модель на вопрос, который ей не задавали. Простой подход, опирающийся на средний балл модели в тесте, угадывает в 70% случаев.
Ограничения авторы называют сами. Все модели в исследовании вышли не позже марта 2025 года. При другом наборе тестов метод может найти другие измерения. Есть и риск: те же оценки позволяют вырезать из теста самые строгие вопросы о безопасности и получить проверку, которую пройдёт небезопасная модель. В Ai2 считают, что прозрачность стоит этого риска. Код и данные открыты.