IBM выпустила модели Granite, обученные отделять команды от данных
Разметка LLMON помогла моделям игнорировать вредоносные инструкции внутри документов в тестах IBM, но гарантированной защиты она не даёт.
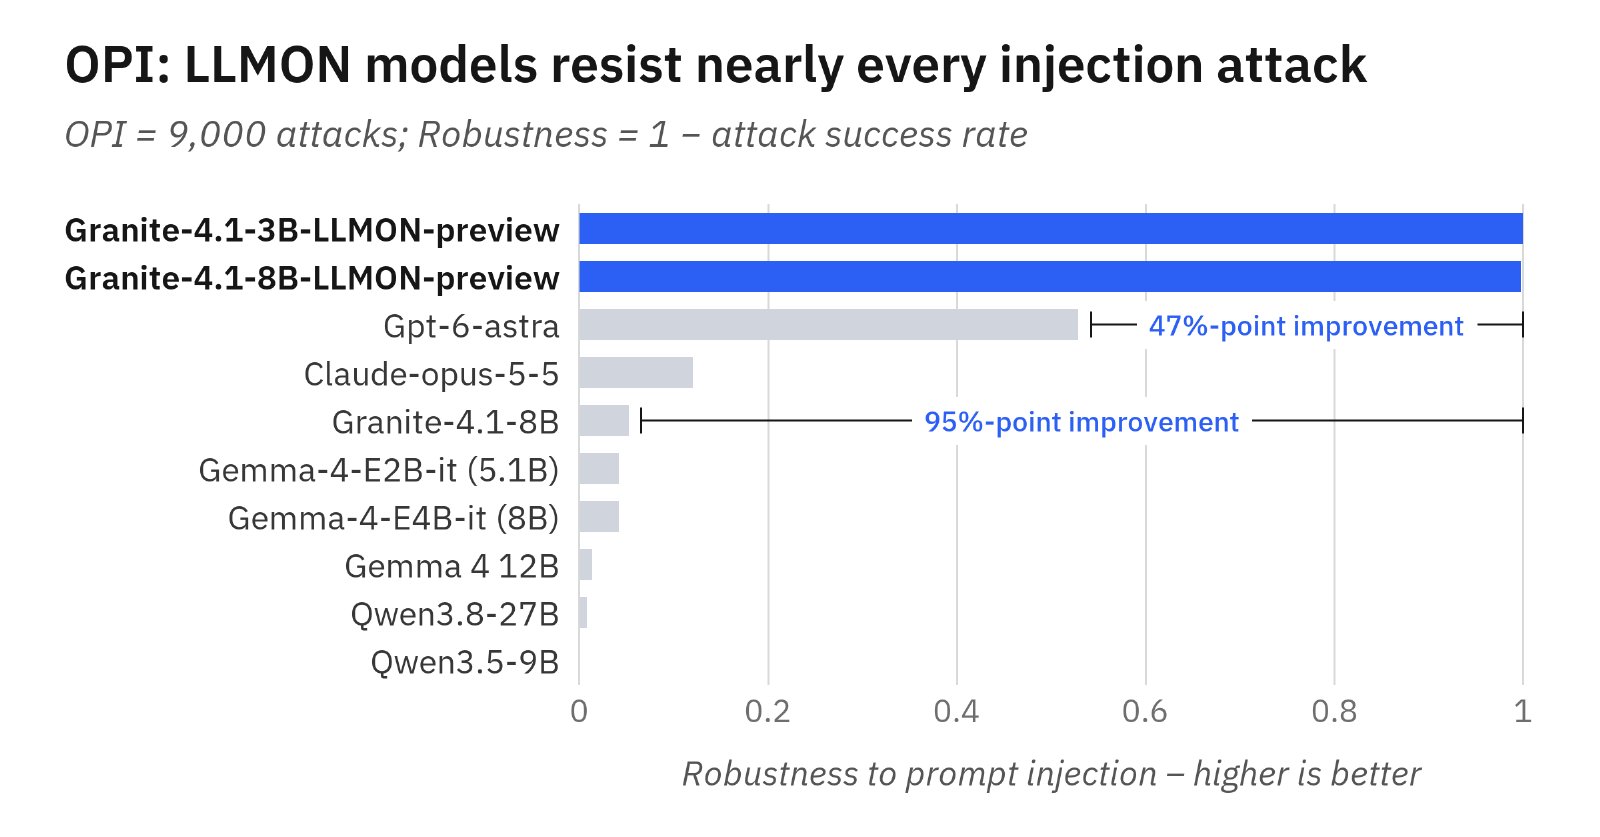
IBM выпустила экспериментальные версии Granite 4.1 3B и 8B, обученные различать задания и данные с помощью языка разметки LLMON. Он явно указывает модели, какие инструкции выполнять и к какому тексту их применять.
Почему это важно: Документ или ответ инструмента может содержать команду злоумышленника. Если модель примет её за задание, она начнёт выполнять чужие указания — такие атаки называют косвенными промпт-инъекциями.
Как это работает: LLMON разделяет содержимое запроса на именованные блоки: инструкции, данные и требования к ответу. Отдельный блок связывает нужное задание с конкретными данными и указывает, куда записать результат. Границы обозначены служебными метками, которые модель распознаёт отдельно от текста документа. Обычные кавычки и скобки могут встречаться внутри самого документа.
Детали: IBM обучала разметке базовые версии Granite 4.1. В учебные примеры добавляли отвлекающие инструкции и данные, которые присутствовали в запросе, но не были связаны с выполняемым заданием. Правильный ответ оставляли прежним: так модели учили игнорировать лишние блоки и следовать явно заданным связям.
В цифрах: По данным IBM, в тесте OPI доля успешных атак на LLMON-модели оказалась почти нулевой. Вредоносные инструкции там прятали в данных для обычных задач обработки текста. Согласно статье исследователей IBM, в ASB доля успешных атак на эти модели составила 3,1–5,6%. При отдельной проверке атак по образцу StruQ модели не выполнили вредоносные инструкции в 79,8–84,6% случаев. На общих проверках модели показали результаты примерно на уровне Granite 4.1 Instruct.
Но: Эти испытания проверяли заранее подготовленные атаки. Над устойчивостью к атакам, которые меняются по ходу диалога, IBM ещё работает. Разделение команд и данных остаётся выученным поведением модели, а не гарантированным ограничением.
Вместе с моделями IBM выпустила набор инструментов и примеры. Разработчик может присвоить частям сообщения имена, а поставляемый шаблон сам преобразует их в блоки LLMON. Для структурированных данных есть отдельные преобразователи из JSON в LLMON и обратно без потерь. Обе модели предназначены для экспериментов и оценки, а не для рабочих систем.