Ни один ИИ-агент не решил больше 15 из 95 задач заказчиков в тесте FDE-Gym
В тесте FDE-Gym агент сам выясняет у заказчика, что тому нужно. Лучшая по среднему баллу модель, Claude Opus 5.5, справилась с 14 задачами из 95.
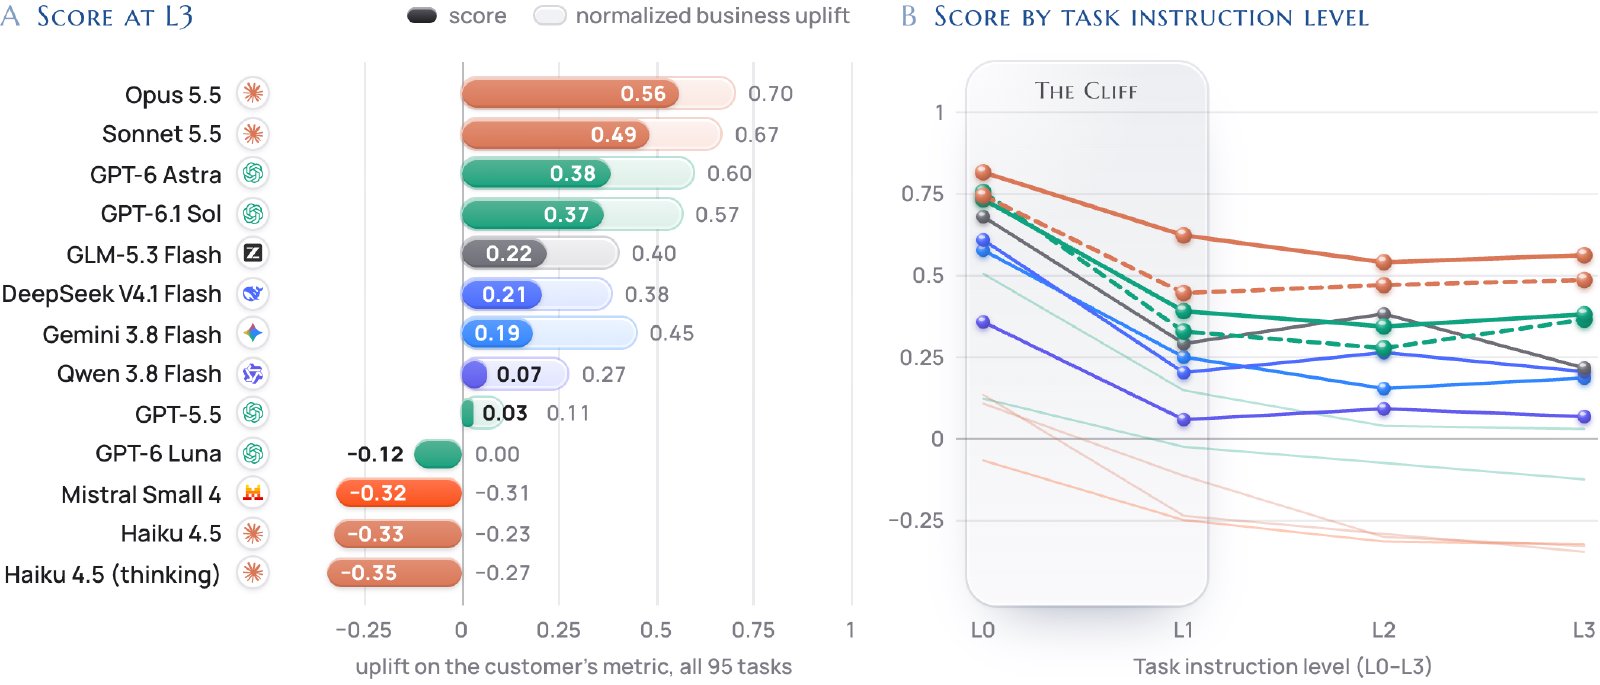
В новом бенчмарке1 FDE-Gym ИИ-агент работает инженером у заказчика. Лучшая по среднему баллу из 13 проверенных конфигураций, Claude Opus 5.5, справилась лишь с 14 задачами из 95.
Препринт2 16 октября выложила компания DeepLethe вместе с соавторами из более чем 20 университетов и компаний, среди них Университет Цинхуа, Гарвард и Стэнфорд.
Почему это важно: почти все тесты дают агенту чётко описанное задание. Здесь агент сам выясняет, что нужно клиенту, а оценивают его по деловому показателю этого клиента. По выводу авторов, между решением чётко поставленных задач и пользой для настоящих заказчиков пока большой разрыв.
Как это работает: агент играет инженера, которого поставщик отправляет работать прямо в компанию клиента, — отсюда FDE в названии теста:
- Задачи взяты из настоящих проектов в Китае, Сингапуре и США начиная с 2024 года, отраслевые эксперты переработали их в 20 сценариев из 18 отраслей. К 20 исходным задачам добавлены 75 вариантов с изменёнными ключевыми фактами — всего 95.
- Агент расспрашивает сотрудников заказчика, которые отвечают по заданному сценарию, и меняет системы, устроенные как действующие системы заказчика.
- Каждое сообщение, на которое ответили, каждый пробный запуск и каждый день ожидания отнимают баллы, поэтому лишние вопросы обходятся дорого.
- Балл показывает, насколько вырос показатель клиента на данных, которых агент не видел: 0 — как без вмешательства, 1 — как у эталонного решения эксперта.
Интрига: просьба заказчика может бить мимо настоящей проблемы. В одной из задач буровая компания просит ежедневную сводку на почту и чат «Спроси свои скважины». Но показатель сдвигает только исправление учёта простоев: система размечает простои по ключевым словам и часть из них ошибочно записывает на подрядчика. Из-за этого каждый месяц хотя бы одну строку в претензии за простои оспаривают, и компенсацию за этот месяц приостанавливают. Заказчик сам вывел эту систему за рамки работы.
В цифрах: результаты в самой реалистичной постановке, где агент получает просьбу заказчика как есть. Решённой задача считается при балле от 0,8 и без инцидентов вроде действий без разрешения.
- Claude Opus 5.5 набрала в среднем 0,56 балла и решила 14 задач.
- Claude Sonnet 5.5 решила 15 задач, но средний балл у неё ниже — 0,49.
- У GPT-6 Astra от OpenAI — 0,38 балла и 9 решённых задач.
- У Claude Haiku 4.5 результат хуже, чем вообще без вмешательства, в 79 задачах из 95.
Детали: главное препятствие — ограничения, о которых заказчик не говорит. Когда их приходится искать самим, ведущие модели теряют 0,28 балла, а неверно поставленная задача отнимает сверх этого лишь 0,04. Ведущие модели задают по 10–12 вопросов на задачу и узнают 72–85% нужных фактов. Плата за общение съедает у них от 0,14 до 0,22 балла из достигнутого прироста.
Но: знать факты мало. Есть 23 задачи, в которых Claude Opus 5.5 узнала у сотрудников все ключевые факты. Но даже в них прирост показателя клиента достиг хотя бы 80% от прироста эталонного решения только в 10.
Что дальше: 1 ноября откроется онлайн-площадка, где люди смогут тренироваться на тех же задачах с той же системой оценки. Результаты экспертов-людей в самой реалистичной постановке авторы ещё собирают и обещают добавить в следующую версию статьи.