4-битная модель Multiverse обошла свою полноточную версию, но сравнение вышло неравным
Multiverse Computing сжала GPT-OSS 120B до 60 млрд параметров и 4 бит. По её данным, итоговая модель обошла свою 16-битную версию в 7 тестах из 9. Читатель заметил, что модели обучали неодинаково, и авторы это признали.
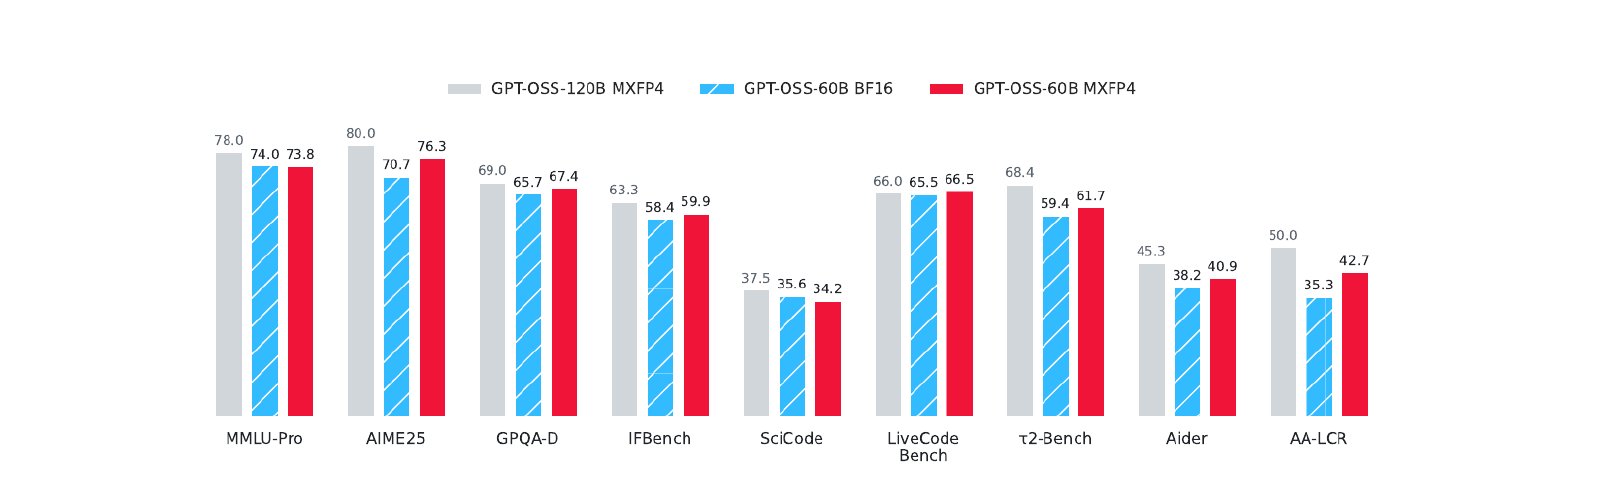
Исследователи Multiverse Computing утверждают, что сжатая 4-битная модель может работать точнее своей полноточной версии. Они взяли GPT-OSS 120B и урезали её вдвое, до 60 млрд параметров. Затем модель восстановили и перевели в формат MXFP4. В 7 тестах из 9 результат оказался выше, чем у той же 60-миллиардной модели в полной 16-битной точности.
Обычно всё бывает наоборот. Когда модель сжимают, убирая слои и нейроны, а затем округляют веса до 4 бит, она хуже рассуждает, решает задачи по математике и пишет код. Поэтому после сжатия модель «лечат» — дообучают, чтобы вернуть утраченное. Метод Multiverse называется Quantization-Aware Healing (QAH). Главная идея — учиться не у восстановленной копии, а у исходной большой модели. Сжатая модель подстраивает свои ответы под ответы оригинала, хотя устроены они по-разному.
Больше всего модель выиграла в задачах на длинный контекст (+7,4 балла на AA-LCR) и в математике (+5,6 балла на AIME 2025). На LiveCodeBench она даже немного обошла исходную 120-миллиардную модель: 66,5 против 66,0. При этом весам нужно примерно вчетверо меньше памяти, чем 16-битной версии. Авторы сравнили свой метод и с распространённым обучением с учётом квантования на модели поменьше. Лучшие результаты почти совпали. Но QAH вышла на пик примерно за 100 шагов обучения вместо 700, а обучение с учётом квантования после пика потеряло почти 19 баллов.
Главный вывод статьи поставил под сомнение читатель в комментариях. Модели, которые сравнивают в таблице, обучали неодинаково: 4-битная версия прошла дополнительный раунд обучения у исходной модели, а 16-битная — нет. Поэтому неясно, помог ли сам метод или просто лишнее обучение. Критик также заметил, что учитель в таблице указан как MXFP4, хотя в тексте его называют полноточным.
Авторы с упрёком согласились. «Мы не должны были опираться на более сильное причинно-следственное прочтение — что квантизация сама по себе даёт „бесплатное обучение“», — ответили они. Отзывать работу исследователи не собираются: цифры, по их словам, настоящие и воспроизводимые. В тексте статьи обещают добавить оговорку. Контрольного сравнения пока нет: для него 16-битную модель нужно обучить так же долго на тех же данных.