Latent Space выяснила, какие продукты советуют ИИ-модели. Свои инструменты они хвалят охотнее
Latent Space задала 7 моделям вопросы о продуктах в 161 категории. Выяснилось, что для программирования модели чаще советуют инструменты своей компании, а GPT-6 Astra меньше других меняет ответ, когда вопрос перефразируют.
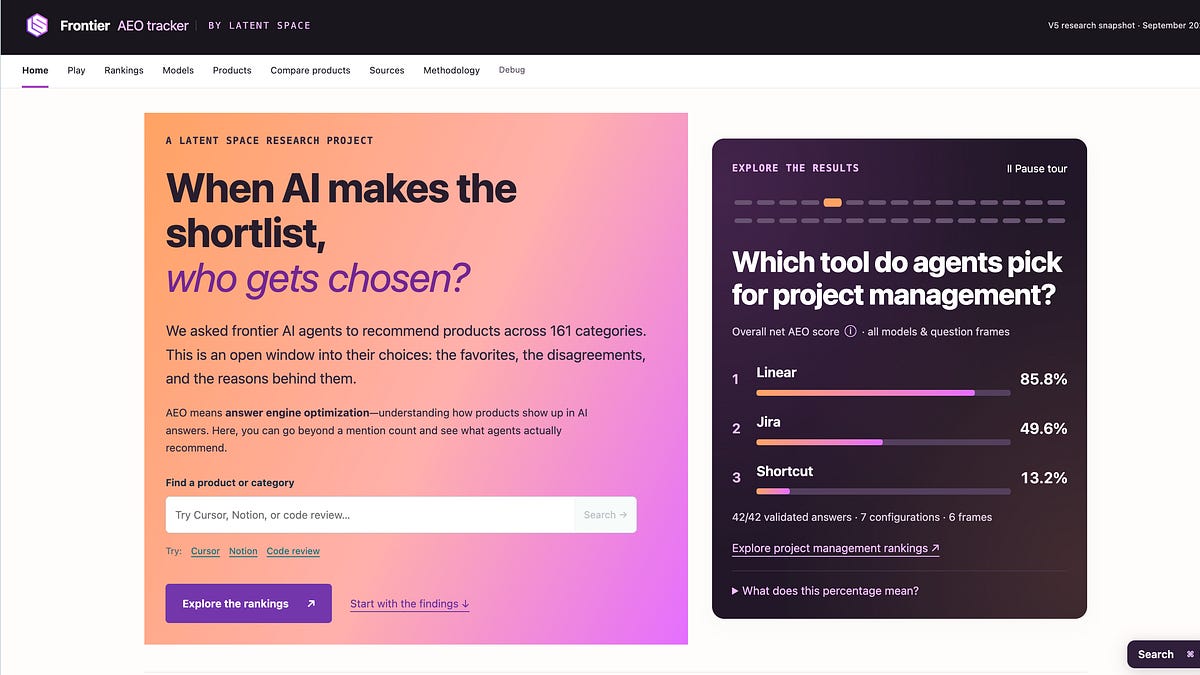
Когда ИИ-модель просят посоветовать агента для программирования, она чаще называет продукт своей же компании. К такому выводу пришла Latent Space. Издание построило трекер, который показывает, какие продукты рекомендуют передовые модели. Claude Code предпочитают Fable и Opus, Codex — Sol и Astra. Grok выбирает Cursor, Muse — Muse Code, а SWE-1.7 — Devin. «Интересно, почему», — иронизируют авторы.
Идею подсказало исследование Amplifying «Что на самом деле выбирает Claude Code». Latent Space взяла его подход за основу и расширила. Каждый вопрос задавали в шести формулировках семи моделям с включённым поиском. Категорий 161: от агентов для программирования и ИИ-подкастов до управляемых баз данных, распознавания речи, зарплатного софта и даже бизнес-ангелов. Ответы разбирала GPT-6 Astra. Затем их оценили по собственной шкале авторов: вес дают первому выбору, альтернативам и простым упоминаниям. Прямые советы не брать продукт уменьшают балл, хотя такое встречается редко. Все пары «запрос — ответ» выложены, их можно проверить.
Бывает и обратное: модели GPT иногда советуют Claude. В 28 категориях из 161 все опрошенные модели сходятся на одном лидере. В остальных борьба плотнее. Там и развернётся главная конкуренция за внимание ИИ-ассистентов.
Авторы отдельно сравнили соседние поколения моделей одной компании: Opus и Fable у Anthropic, Sol и Astra у OpenAI. Между поколениями рекомендации заметно меняются. Anthropic, судя по всему, учит модели искать шире: медиана выросла с 11 источников у Opus до 15 у Fable. У OpenAI наоборот: у Sol медиана 9 источников, у Astra — 5. При этом Astra гораздо реже меняет ответ, если вопрос слегка перефразировать. По мнению авторов, раз случайность ответов падает, бороться за место в них становится выгоднее.
Авторы признают, что данных об источниках мало. Это только то, что удалось вытащить из поисковых запросов моделей, а не их обучающие данные. Одно всё же подтвердилось: если сайт не отдаёт модели текстовую версию страницы, модель читает его хуже. Gemini, GLM и DeepSeek в первый выпуск не попали: помешали ошибки и ограничения на число запросов.