Google Research рассказала, как «сон» помогает моделям запоминать новое
Модель по очереди работает и «спит»: во сне она переносит свежие сведения из текущих разговоров в собственные веса, где хранится выученное при обучении, и тренируется на примерах, которые сочинила сама.
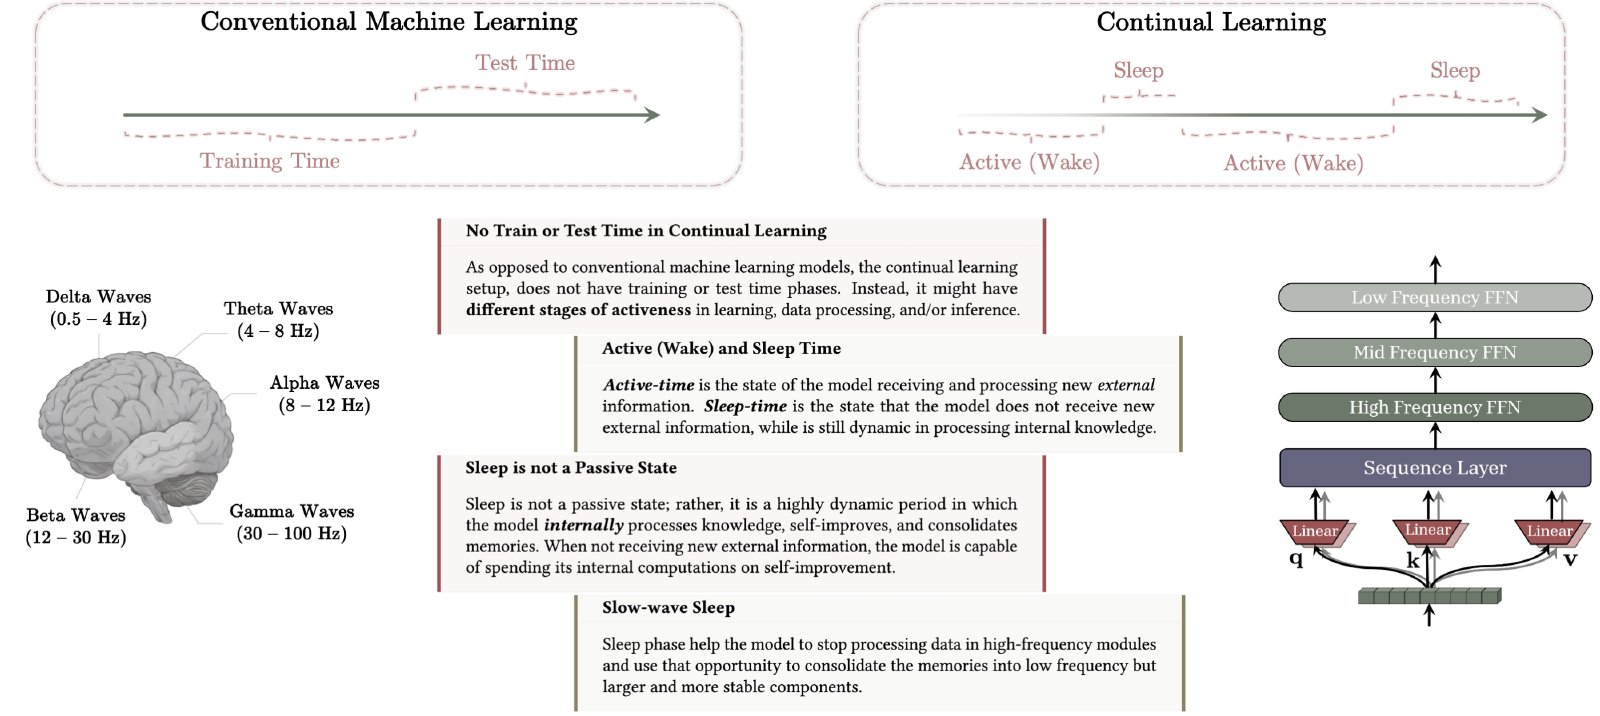
Исследователи Google Research описали способ, при котором языковая модель учится и после выпуска, почти не забывая старое: она чередует работу со «сном» и во сне закрепляет то, что узнала.
Почему это важно: сейчас знания модели заканчиваются датой среза, а то, что ей сообщили в разговоре, пропадает вместе с сеансом. Дообучение на новых данных обычно портит прежние навыки — это называют катастрофическим забыванием.
Повод: метод описан в статье Али Бехруза, Вахаба Миррокни и их коллег из Google и Корнеллского университета. На arXiv она вышла в июне, ранняя версия лежала на OpenReview с сентября 2025 года, а теперь авторы подробно разобрали её в блоге Google Research.
Как это работает: пока модель бодрствует, она отвечает на запросы и держит свежие сведения в быстрой краткосрочной памяти — по сути, в контексте. Во сне она перестаёт принимать запросы и делает три вещи:
- Подключает новые блоки параметров, заранее зарезервированные в архитектуре смеси экспертов1, и записывает туда новое, не трогая старые веса.
- Учится отвечать так же, как отвечала, пока сведения лежали в контексте; после этого краткосрочную память очищают.
- Переходит к «сновидениям»: сочиняет учебные примеры, автоматически отбирает из них те, что сильнее всего должны её улучшить, и дообучается на них.
Интрига: сочиняя примеры, модель нарочно включает случайных экспертов, чтобы смешать далёкие области знаний. Если же отключить «сновидения» целиком, результат заметно хуже: по таблицам статьи, в тесте на усвоение фактов модель верно ответила на 35,7% вопросов вместо 48,9%. Без одних случайных экспертов доля почти не упала — 48,0%.
Детали: авторы проверили метод на нескольких задачах:
- Модель по очереди учила маньчжурский язык и каламанг, которых раньше не видела, и почти не теряла качество перевода; при обычном дообучении и обучении в контексте выученное быстро забывалось.
- В тесте BABILong2 качество почти не падало на текстах длиной до 10 млн токенов; по словам авторов, метод обошёл GPT-4 и Titans — прежнюю архитектуру Google с долговременной памятью.
- Прочитав абзац из набора SQuAD, модель потом верно отвечала на вопросы по нему, уже не видя текста, в 48,9% случаев; у метода SEAL3 — 46,7%, у исходной модели — 31,9%.
В цифрах: доля решённых задач математических олимпиад у модели Qwen3-8B, по таблицам статьи.
| Тест | Исходная | GRPO | «Сон» |
|---|---|---|---|
| AIME 2024 | 73,8% | 76,4% | 79,2% |
| AIME 2025 | 68,1% | 68,1% | 69,0% |
| HMMT 2025 | 42,4% | 44,9% | 46,1% |
GRPO — распространённый способ дообучения с подкреплением; доля — средняя по 16 попыткам.
Но: «сон» и «сновидения» — метафоры из нейробиологии, оговаривают авторы: архитектуру и правила обучения задают люди, а во сне меняются только веса. Пока модель спит, она не отвечает на запросы. Опыты ставили на небольших открытых моделях — например, на Qwen3 с 8 млрд параметров.
Бехруз и Миррокни и раньше занимались памятью моделей. Часть опытов со «сном» поставлена на их архитектуре Hope, где разные слои памяти обновляются с разной частотой.