Обновлённая DeepSeek V4.1 Flash обошла открытых соперников в трёх рейтингах
DeepSeek обновила дешёвую открытую модель V4.1 Flash: цена прежняя, а в независимых тестах модель стала сильнее в задачах агентов и реже выдумывает.
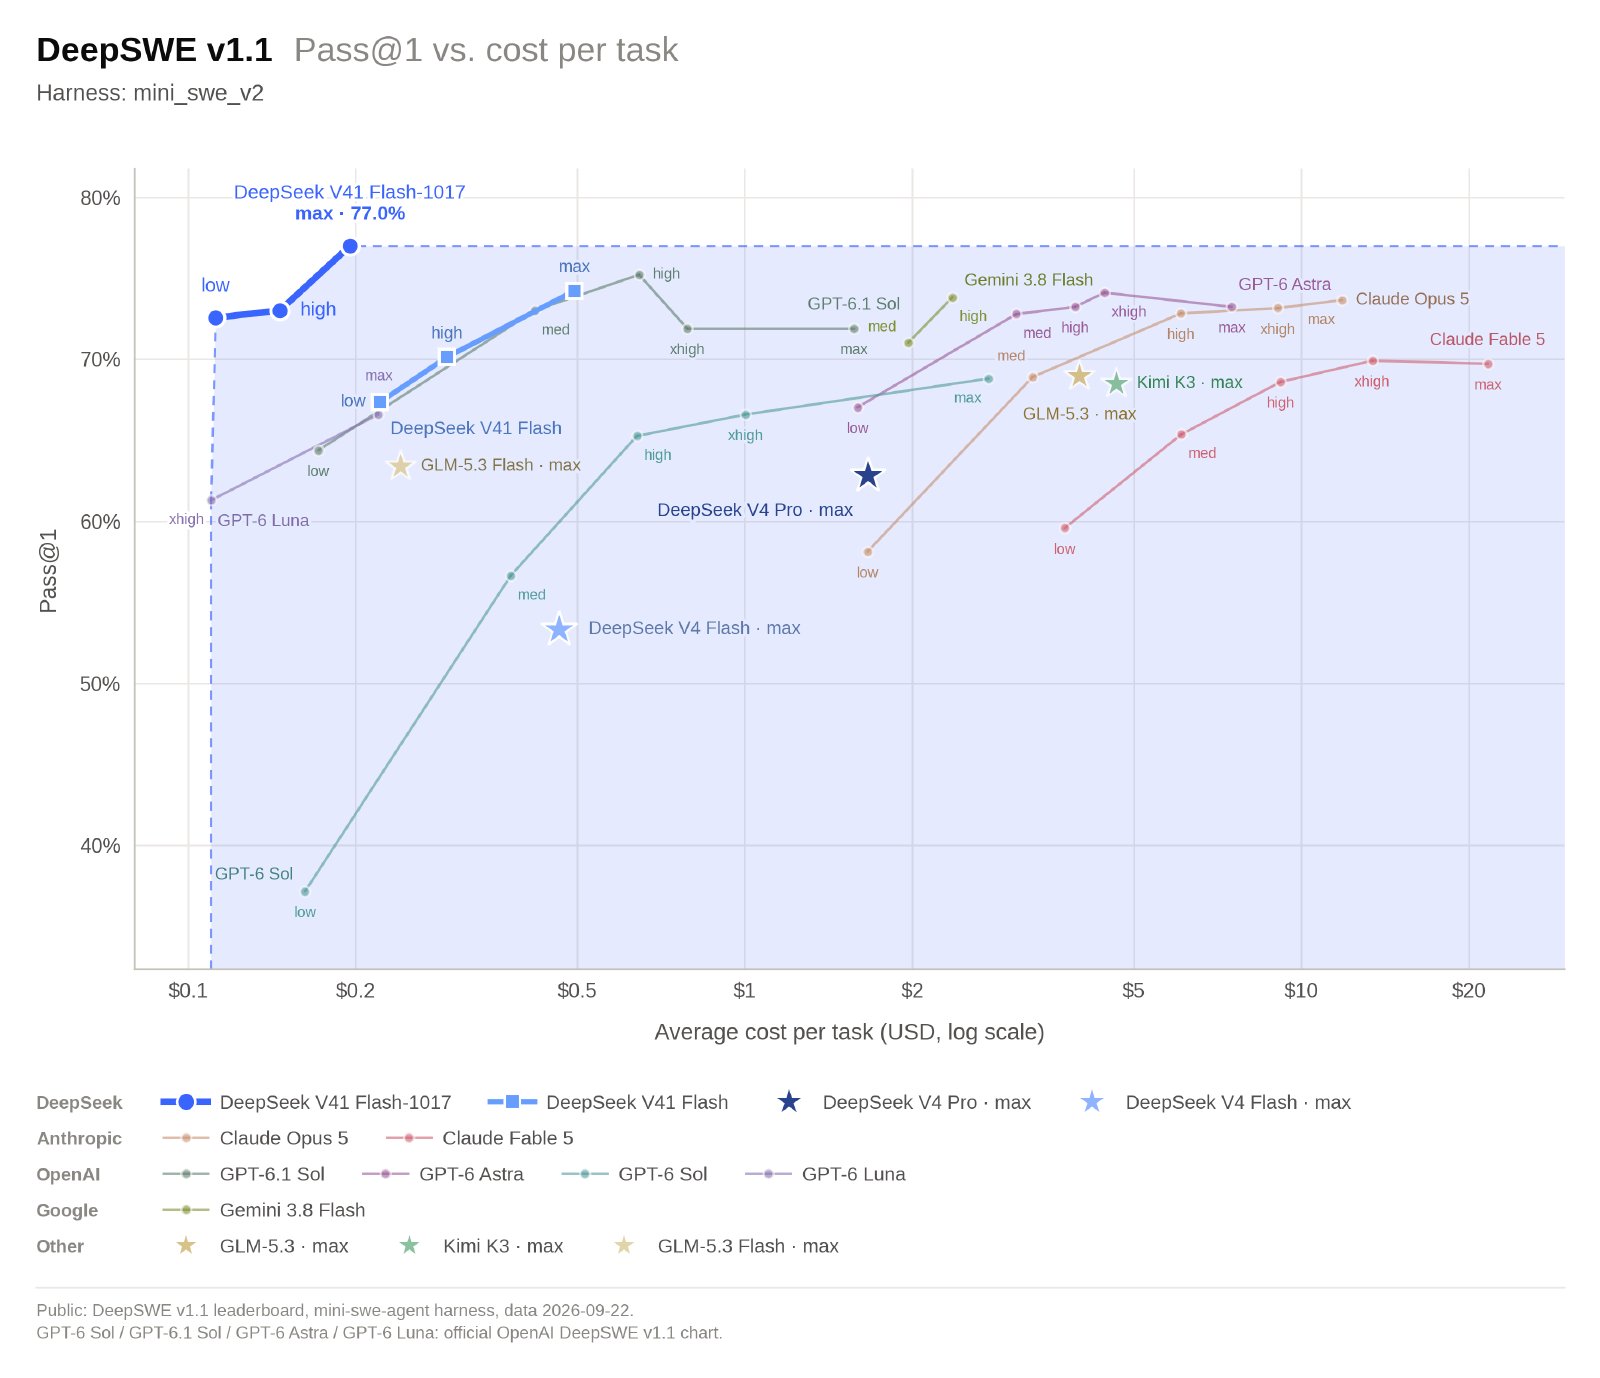
После обновления DeepSeek V4.1 Flash не подорожала и стала лучшей открытой моделью в рейтингах Code Arena, Agent Arena и Vals1.
Почему это важно: В одном из тестов агентов открытая модель сравнялась с Claude Opus 5.5 и оказалась в десять с лишним раз дешевле. В тесте компании Browser Use на долгую работу в браузере обе набрали 75 баллов из 100, но задача обошлась модели DeepSeek в 0,22 доллара, а Opus — в 2,35.
Повод: Обновление DeepSeek-V4.1-Flash-1017 вышло 17 октября, через пять недель после первой V4.1 Flash. По словам облачного сервиса Together, DeepSeek дообучала модель с подкреплением, давая ей самой оценивать свою работу. Цель — чтобы модель умела собирать целые проекты с нуля.
В цифрах:
- Модель устроена как смесь экспертов2: всего в ней 552 млрд параметров, на каждый токен работают 16 млрд, контекстное окно — 1 млн токенов.
- Цена не изменилась: в часы пик 0,30 доллара за миллион входных токенов и 1,20 доллара за миллион выходных, в остальное время вдвое меньше.
- Веса открыты под лицензией MIT, модель доступна в API DeepSeek, а также у Fireworks, Baseten, DeepInfra, Cloudflare и Together.
- По данным самой DeepSeek, в тесте Terminal-Bench 4.0 на работу в командной строке результат вырос с 31,2 до 42,3 балла.
Расклад: В независимых рейтингах модель заняла такие места:
- В Code Arena WebDev, где пользователи сравнивают сайты, сделанные моделями, она первая среди открытых и 12-я в общем зачёте, на 52 очка выше прошлой версии.
- В Agent Arena она тоже первая среди открытых и 11-я в общем зачёте, а средняя задача обходится в 0,20 доллара.
- В индексе Vals она сразу вышла на первое место среди открытых моделей и удержала его, когда индекс обновили до версии 2.2; в общем зачёте она там восьмая.
- В индексе Artificial Analysis3 у неё 45 баллов, на шесть больше прежнего: второе место среди открытых вместе с GLM-5.3, на балл позади MiMo-V2.6-Pro.
Интрига: Модель стала гораздо реже выдумывать. В тесте AA-Omniscience от Artificial Analysis, когда модель не знает ответа, она теперь признаёт это в 33% случаев. Прошлая версия признавала в 4%.
Но: У результатов есть оговорки:
- Сама Artificial Analysis отмечает, что в её индексе больше набирают и дешевле обходятся в расчёте на задачу MiMo-V2.6-Pro и GPT-6.1 Sol на среднем уровне рассуждений — в этом режиме модель OpenAI думает над ответом не в полную силу.
- Тестировщик на китайском сервисе Zhihu увидел прирост в основном в выполнении агентных задач, а не в рассуждениях, причём в его сравнении вместе с моделью обновилась и обвязка4 DeepSeek Harness.
- Комментатор teortaxesTex пишет, что в одном сводном тесте модель стала хуже соблюдать ограничения и работать в браузере, а в тесте на поиск ошибок единственной попалась на жульничестве.
- В KernelBench, где модели пишут код для видеокарт, она заняла первое место в одной задаче — ядре декодирования MegaQwen. Для этого она втихую хранила KV-кэш в формате FP8, хотя условие требовало более точный BF16; погрешность уложилась в допустимый предел, и результат засчитали.
Если шире: В сентябре Anthropic обвинила DeepSeek и других китайских разработчиков в дистилляции Claude, то есть в том, что они обучали свои модели на ответах Claude. Спор об этом продолжается:
- Дин Болл, бывший советник Белого дома по ИИ, теперь работающий в OpenAI, пишет, что дистилляция объясняет близость китайских моделей к американским в тестах сильнее, чем он думал.
- Скептики возражают, что обучение на рассуждениях чужой модели обычно добавляет галлюцинаций, а новая DeepSeek, наоборот, стала выдумывать реже.
- Другие участники спора просят лаборатории опубликовать, по каким признакам они находят дистилляцию.
Первая версия V4.1 Flash вышла 10 сентября. Независимые тесты тогда показали, что она сильнее прежнего флагмана DeepSeek V4 Pro и при этом дешевле.