Исследователи Apple сжали в 2,8 раза кодировщик речи для диктовки. Как это устроено
Из шести проверенных пар исходного и сжатого кодировщика в пяти сжатый ошибается в распознавании не больше чем на 1,9% чаще. От размера кодировщика зависят расход энергии и задержка диктовки, объясняют авторы.
Исследователи Apple уменьшили в 2,8 раза кодировщик, через который системная диктовка передаёт речь языковой модели. Точность распознавания при этом почти не упала. Работа вышла препринтом1 на arXiv 3 сентября, а 24 сентября компания опубликовала её в своём блоге об исследованиях машинного обучения.
Диктовка на устройствах Apple работает целиком без облака. Звук речи, которую она расшифровывает, попадает в фундаментальную модель2 через токенизатор. Это кодировщик: он берёт звук короткими отрезками и превращает их в представление, понятное языковой модели.
Сама языковая модель разреженная: в оперативной памяти в каждый момент находится лишь небольшая часть её блоков-экспертов. Токенизатор включён постоянно и занимает ту же память. Поэтому от числа его параметров напрямую зависят расход энергии и задержка, поясняют авторы.
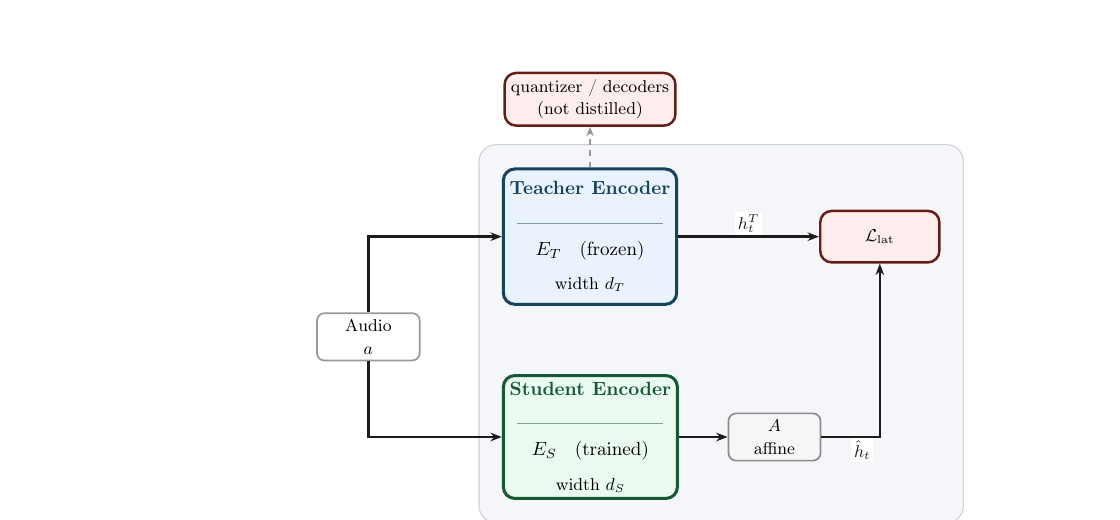
Кодировщик сжимали дистилляцией знаний: небольшую модель-ученика учат повторять поведение крупной модели-учителя. Обычно ученик копирует итог работы учителя — готовые токены или распределение вероятностей на выходе.
Авторы выбрали другую цель — внутреннее представление звука, которое кодировщик выдаёт до того, как следующий блок, квантизатор, сделает из него токены. Языковая модель, по словам авторов, фактически опирается именно на это представление. Обучали только кодировщик-ученика: для каждого кадра звука он подгоняет свой вектор к вектору учителя, сводя к минимуму квадрат разницы. Разницу в размерах представлений снимает один дополнительный линейный слой.
Система поддерживает два способа передавать звук языковой модели в виде токенов, и это представление — последнее, что у них общее. После него идут квантизатор и связующий блок между токенизатором и языковой моделью. Ученика учат повторять то, что получается ещё до обоих этих шагов, поэтому один рецепт подходит к обоим способам. Он работает и с токенизатором, обученным отдельно, и с тем, что обучали вместе с языковой моделью.
В пяти парах «учитель — ученик» из шести доля неверно распознанных слов (WER) у ученика выросла не больше чем на 1,9% в относительном выражении. Дополнительное дообучение для этого не понадобилось. Токенизатор того же размера, обученный самостоятельно, ошибается чаще: у дистиллированного ученика WER на 3,9% ниже.
Встроен ли сжатый кодировщик в саму диктовку, в работе не сообщается.