IBM выпустила открытую модель для прогноза временных рядов PatchTST-FM-r2
В рейтинге GIFT-Eval модель на 385 млн параметров заняла второе место среди моделей, которые прогнозируют без дообучения. Лицензия разрешает коммерческое использование.
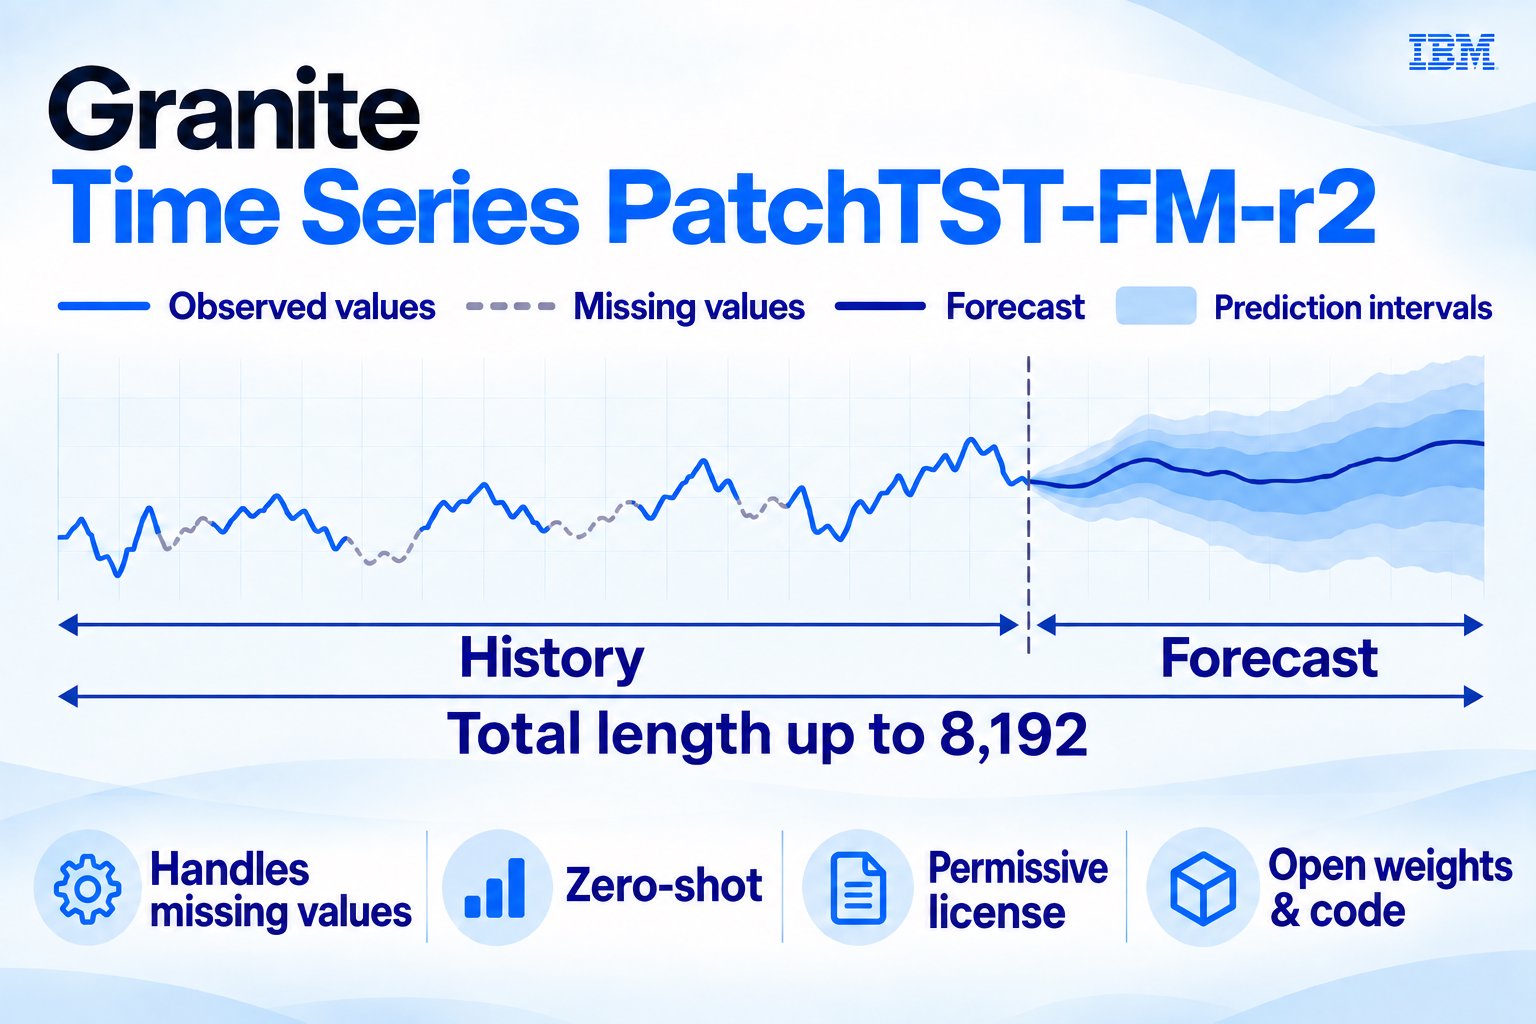
IBM выложила на Hugging Face модель PatchTST-FM-r2 из семейства Granite Time Series, говорится в блоге компании. Модель прогнозирует временные ряды: спрос, цены, нагрузку на энергосеть, трафик, показания датчиков. Дообучать её под свои данные не нужно: достаточно передать недавнюю историю ряда, и модель сразу выдаст прогноз.
Такой подход называют прогнозом без примеров. Вместо отдельной модели под каждый набор данных берут одну, заранее обученную на большом массиве рядов, и применяют её к рядам, которых она раньше не видела.
По состоянию на 8 сентября в рейтинге GIFT-Eval1 модель занимает второе место среди воспроизводимых моделей, которые работают без дообучения и не видели тестовых данных. Это верно для обеих метрик рейтинга: CRPS оценивает вероятностный прогноз, MASE — точность прогноза одним числом. По CRPS PatchTST-FM-r2 уступает только TimesFM-32. Среди моделей с разрешительной лицензией она первая.
В рейтинге есть и модели, которым разрешено обучаться на тренировочной части наборов GIFT-Eval. С ними в сравнении PatchTST-FM-r2 третья по CRPS и четвёртая по MASE. По данным IBM, она обошла Chronos-2, Timer-S1 и версии Toto, хотя некоторые из конкурентов заметно крупнее.
Модель принимает историю длиной до 8 192 шагов и выдаёт прогноз любой длины. Вместо одного числа на каждый шаг она строит 99 квантилей, то есть распределение возможных значений, из которого получаются интервалы неопределённости. Ещё она умеет заполнять пропуски в данных.
От первой версии, PatchTST-FM-r1, новая отличается устройством блоков. Обычные слои трансформера заменили конформерными, пришедшими из распознавания речи: к механизму внимания добавили свёртку. Свёртка улавливает связи между соседними отрезками ряда, а внимание сосредотачивается на дальних. Блоков стало 30 вместо 20.
Модель распространяется под двумя лицензиями на выбор — Apache 2.0 и OpenMDW 1.03. IBM раскрыла и состав обучающих данных: отобранные наборы из GiftEvalPretrain, синтетические ряды и около 500 тыс. синтетических последовательностей CauKer. Вместе с весами компания выложила код для воспроизведения результатов в рейтинге.
Ранее IBM и Confluent4 открыли ранний доступ к нескольким моделям Granite Time Series, в том числе к PatchTST-FM-r1, в облачном сервисе Confluent Cloud. Там прогнозы строятся прямо по потоку поступающих данных, без переноса их в отдельную среду для машинного обучения. Появится ли там PatchTST-FM-r2, компания не уточняет.