NVIDIA на примере Nemotron 3.5 Lightning объяснила, когда смесь экспертов лучше плотной модели
Модели со смесью экспертов быстрее выдают текст, но памяти требуют столько же, сколько плотные модели того же размера. Lightning в 4–5 раз быстрее Qwen3.8-27B и в 14 раз дешевле, но в общих тестах набирает меньше половины её баллов.
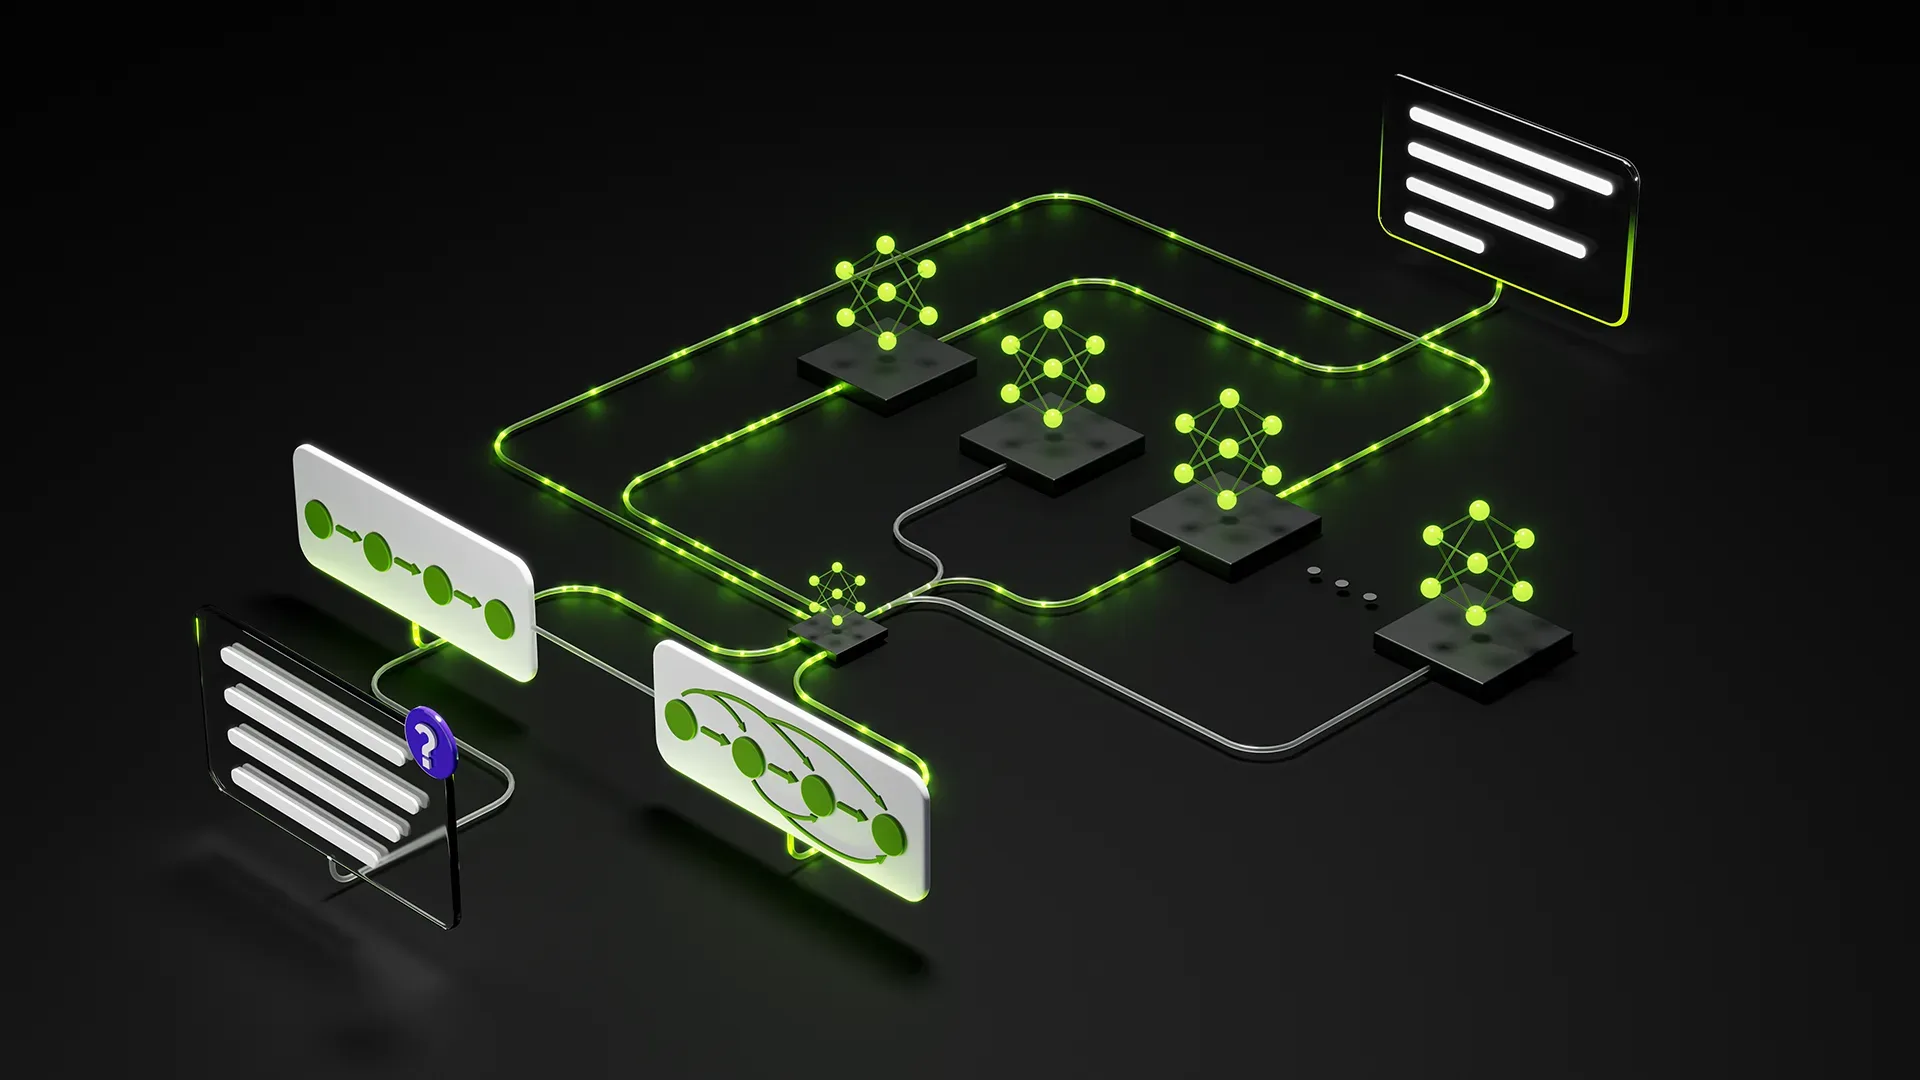
Модель на 30 млрд параметров может работать почти так же быстро, как модель на 3 млрд, но видеопамяти ей нужно столько же, сколько плотной модели на 30 млрд. На этом компромиссе и построен разбор NVIDIA. Компания сравнивает два основных устройства языковых моделей и выбирает между ними на примере своей Nemotron 3.5 Lightning.
Плотная модель при обработке каждого токена задействует все свои параметры. В модели со смесью экспертов есть много небольших подсетей — экспертов, и маленькая сеть-маршрутизатор отправляет каждый токен лишь к нескольким из них. Причём решение принимается заново на каждом слое. Эксперты при этом не разбираются в отдельных темах: по словам NVIDIA, они в основном делят между собой синтаксис и типы токенов вроде чисел и знаков препинания.
Главный выигрыш — скорость. Gemma 4 31B и Nemotron 3.5 Lightning примерно одного размера, но у разных облачных провайдеров их скорости даже не пересекаются. NVIDIA оговаривается, что дело не только в 3 млрд активных параметров: Lightning ускоряют ещё слои Mamba-2 и спекулятивное декодирование. На фоне Qwen3.8-27B модель выдаёт текст в 4–5 раз быстрее и стоит в 14 раз дешевле, но в тестах на общие способности набирает меньше половины её баллов. NVIDIA считает, что такая модель годится для агента, который массово выполняет чётко описанные шаги, а для одной трудной задачи на рассуждение не подходит.
Память смесь экспертов не экономит. В видеопамять загружаются все эксперты, поэтому и плотной модели на 30 млрд, и смеси экспертов того же размера нужно около 60 ГБ. Когда запросов много, токены вместе задействуют почти всех экспертов, и преимущество по задержке сокращается. Поэтому тем, кому важна задержка при большой нагрузке, NVIDIA советует перед выбором проверить обе модели.
Есть и сложности с доработкой. Полное дообучение смеси экспертов может нарушить баланс маршрутизатора: одни эксперты становятся слишком востребованными, другие перестают работать совсем. Помогают облегчённые методы вроде LoRA или заморозка маршрутизатора. При сжатии маршрутизатор тоже оставляют в более высокой точности: даже небольшая погрешность меняет, к каким экспертам уходит токен. Кроме того, перед сжатием стоит проверить исходный формат весов. Например, Mistral Small 4 изначально выпущена в 8-битном виде, поэтому переход на 4 бита уменьшает её не вчетверо, а примерно в 1,7 раза: со 121 до 71 ГБ.