Red Hat, IBM и Google выпустили llm-d 1.0 для запуска моделей в компаниях
Открытая система llm-d 1.0 делит видеокарты компании между людьми и ИИ-агентами; в опыте IBM и Red Hat работа 3 000 агентов-программистов вышла в 5–10 раз дешевле, чем у коммерческих сервисов с той же моделью.
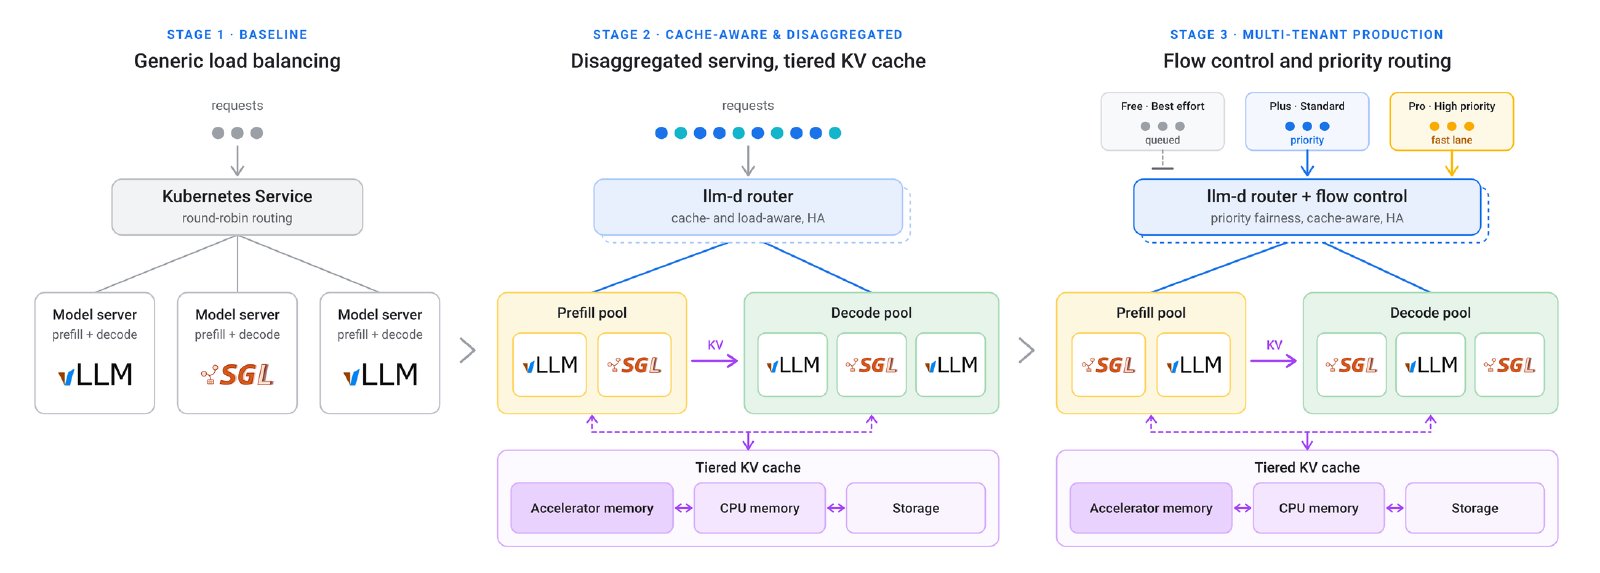
Red Hat, IBM и Google, ведущие разработчики открытого проекта llm-d1, выпустили версию 1.0 — систему, которая распределяет запросы к языковым моделям по видеокартам компании. Выпуск объявили на конференции PyTorch Conference North America в Сан-Хосе.
Почему это важно: агент за одну задачу обращается к модели много раз и каждый раз перечитывает тот же контекст, поэтому работа моделей стала постоянной статьёй расходов. Система даёт компаниям открытый способ держать модели на собственных серверах и не зависеть целиком от одного поставщика моделей, облака или чипов.
Как это работает: система — надстройка над движками vLLM и SGLang, которые запускают модель на ускорителях. Она встраивается в Kubernetes — систему, которой компании управляют программами на множестве серверов, — и отправляет запрос на ту копию модели, где уже лежит его контекст, чтобы не обрабатывать текст заново.
Повод: приёмы ускорения в версии 1.0 прежние. Новое в том, что они работают вместе, когда меняется нагрузка, отказывает оборудование или выходит обновление. «Версия 1.0 добавляет зрелость, чтобы эксплуатировать llm-d как любой другой критически важный сервис», — сказал Карлос Коста, инженер IBM Research и один из основателей проекта.
Детали: версия 1.0 добавляет четыре возможности.
- Приоритеты в очереди: запросы людей, которым нужен быстрый ответ, и всплески запросов от агентов делят одни видеокарты и не отнимают их друг у друга.
- Обновления без остановки: чтение запроса и генерация ответа идут на разных машинах, теперь эти две части системы обновляют согласованно, а у маршрутизатора появился горячий резерв.
- Стабильный интерфейс настроек версии v1, проверенный в разных облаках и на разных ускорителях, — на него компании могут опираться как на стандарт.
- Режим для агентов: сессия держится на копии модели со своим контекстом, ведь агент шлёт пачку запросов, ждёт инструмента и возвращается к тем же документам.
В цифрах: замеры IBM и Red Hat на тестовых нагрузках.
- На задаче агентов-программистов маршрутизатор системы повторно использовал 97% контекста, который вообще можно было взять из кэша.
- По пресс-релизу, открытая GLM 5.2 примерно на 753 млрд параметров на видеокартах NVIDIA обслуживала до 3 000 агентов-программистов сразу и на пике выдавала больше 6,6 млн выходных токенов2 в минуту.
- По ценам аренды облачных видеокарт токен вышел в 5–10 раз дешевле, чем токен той же модели через коммерческие API, сильнее всего — когда на входе много текста, как у агентов.
- В пресс-релизе описан и случай IBM Research: агенты, которые перебирали варианты чипа для квантовой коррекции ошибок3, тратили около 0,11 доллара за миллион токенов, а работа моделей обошлась в 11,5 раза дешевле, чем на одних закрытых моделях.
Расклад: по пресс-релизу, систему уже используют в работе.
- JetBrains: на системе держится значительная часть запросов к Junie Lite — бесплатному тарифу её агента для программирования Junie.
- DigitalOcean: на ней работают облачные сервисы Serverless Inference и Managed Agents, через которые проходят триллионы токенов.
- Mistral: при перегрузке система придерживает или отбрасывает запросы низшего приоритета, чтобы ответы платным клиентам укладывались в обещанную задержку.
Но: все цифры экономии — замеры самих разработчиков. В опыте с чипом открытые модели вместе с системой сравнивали с набором из одних закрытых моделей, а не с другой системой для запуска моделей вроде llm-d.
Что дальше: Google Cloud встраивает новую версию в свой сервис Google Kubernetes Engine для ускорителей TPU и видеокарт NVIDIA. NVIDIA обещает перенести систему на ускорители следующего поколения Vera Rubin, сроков компания не назвала.
Проект основали в мае 2025 года Red Hat, IBM, Google Cloud, CoreWeave и NVIDIA, позже к нему присоединились AMD, Cisco, Hugging Face, Intel, Lambda и Mistral AI. Сейчас проектом управляет фонд CNCF4, а участников у проекта больше 500 из более чем 25 организаций.