Поисковый ИИ-агент стал точнее, когда планирование отделили от сводки
Метод IterSynth делит работу агента между планировщиком и сводкой найденного: модель на 8 млрд параметров обошла прежних агентов своего размера.
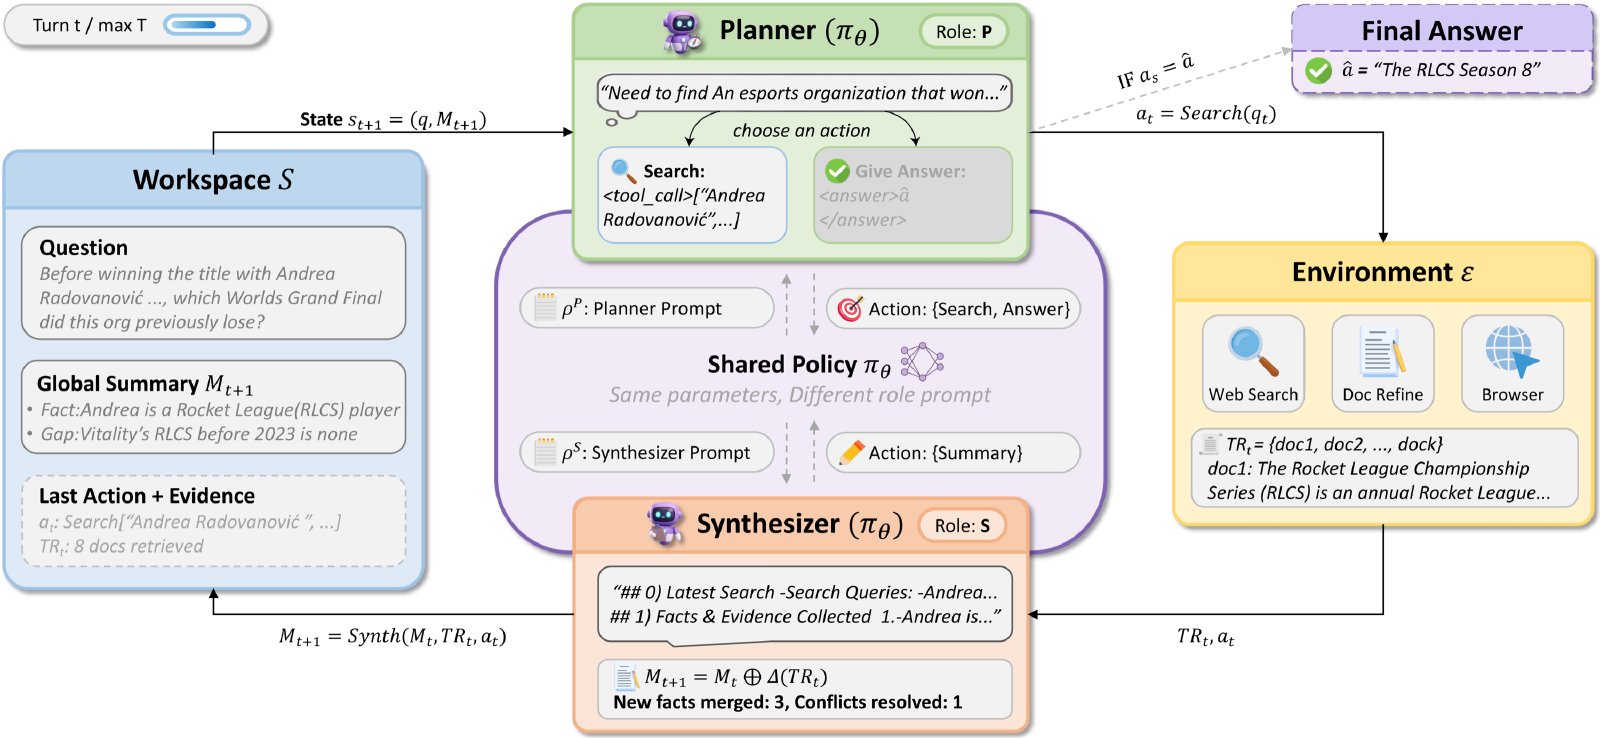
Агент на базе небольшой модели Qwen3-8B обошёл лучшего прежнего агента своего размера на пяти тестах глубокого поиска. В нём одна роль планирует поиск, а другая ведёт сводку найденного. Метод IterSynth описан в препринте, который вышел на arXiv 24 сентября.
Почему это важно: В глубоком поиске агент собирает ответ из многих источников за десятки шагов. Обычно он хранит в памяти всю историю поиска, и лишний текст мешает ему найти нужное. Авторы предлагают, как этого избежать, в том числе у больших закрытых моделей без переобучения.
Как это работает: В обычном агенте по схеме ReAct1 одна и та же модель решает, что искать, читает найденное и пишет ответ. IterSynth разводит эти задачи:
- Планировщик на каждом шаге определяет, какой информации ещё не хватает.
- Вторая роль встраивает свежие находки в общую сводку и переписывает её.
- Вместо растущей истории поиска агент держит в памяти только эту сводку.
Детали: Для обучения авторы придумали метод RDPO — вариант обучения с подкреплением2. Модель получает награду за итоговый ответ и оценки по критериям за каждый шаг. Вклад планировщика и составителя сводки считается отдельно, чтобы точнее понять, какая роль принесла результат.
В цифрах:
- IterSynth-8B набрала в среднем 50,7 балла на BrowseComp3, его китайской версии, текстовой части GAIA4 и двух версиях Xbench-DeepSearch.
- Это на 4,2 больше, чем у сильнейшего прежнего агента с моделью до 8 млрд параметров.
- По данным авторов, агент обходит несколько агентов на 30 млрд параметров и приближается к IterResearch-30B-A3B и WebSailor-V2-30B, хотя меньше их втрое.
Если шире: Схему можно применить и без дообучения, просто как инструкцию к чужой модели. С Claude Opus 4.5 она набрала в среднем 66,1 балла, с DeepSeek-V3.1 — 47,9. В обоих случаях это больше, чем у ReAct и схемы IterResearch на тех же моделях.
Но: Код выложен в репозитории Tencent на GitHub, а веса обученной модели — нет. Там только код обучения с подкреплением, без первого этапа обучения на готовых примерах и без обученных версий модели. Все результаты — данные самих авторов, препринт ещё не прошёл рецензирование.