Маленькая модель-подсказчик вдвое повысила долю решённых задач у большой
Обученная давать подсказки модель на 7 млрд параметров помогла модели на 32 млрд решить 39% трудных задач по математике вместо 19% при том же числе попыток.
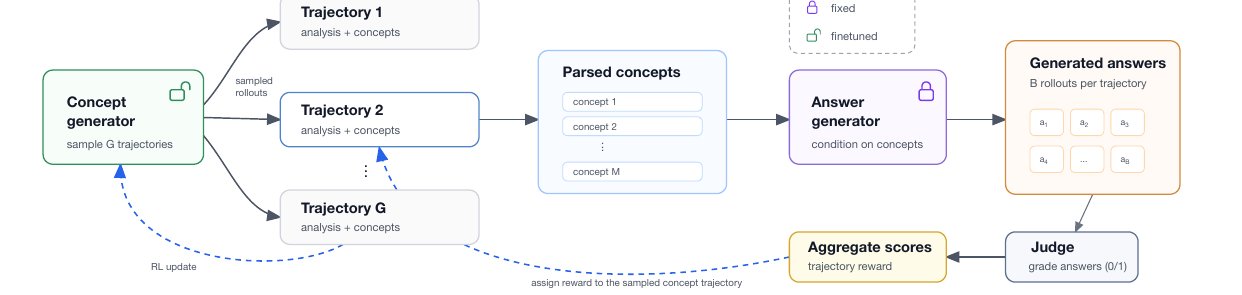
Модель на 7 млрд параметров, которую обучили подсказывать идеи решения, вдвое подняла долю трудных задач по математике, решённых моделью на 32 млрд, — при том же числе попыток. Такой результат описан в препринте Исмаила Лабиада и четырёх соавторов, среди них Реми Мюнос; работу выложили на arXiv1 22 сентября.
Почему это важно: самые сильные модели часто нельзя дообучить: они слишком велики или доступны только через API. Здесь учат только маленькую модель, а большая остаётся как есть — авторы называют это «рычагом для обучения» моделей, которые иначе не обучить.
Общая картина: трудные задачи модели обычно решают перебором — пишут сотню решений и оставляют верное, если оно нашлось. По наблюдению авторов, такие попытки часто почти повторяют друг друга: они различаются случайным выбором слов, а не идеями.
Как это работает: подсказчик не решает задачу сам, а задаёт направления поиска.
- Сначала он разбирает условие и выписывает до десяти идей: нужную теорему, подстановку, способ подступиться к задаче.
- Затем 128 попыток большой модели делятся между этими идеями поровну, по 12–13 на каждую.
- Подсказчика тренировали методом обучения с подкреплением2: награду он получал, когда с его идеями большая модель отвечала верно.
В цифрах: подсказывала Qwen2.5-7B, решала Qwen2.5-32B. Задачи отобраны так, что при отборе Qwen2.5-32B не решила ни одной из них за 128 попыток.
- Без подсказок при новом прогоне она решила 19% из 1 000 таких задач из набора DeepMath-103K3, с подсказками обученной 7B-модели — 39,2%.
- Та же 7B-модель до обучения давала 28,9%, а Qwen2.5-32B, подсказывая сама себе без всякого обучения, — 33,8%.
- Llama-3.3-70B, которую подсказчик в обучении не видел, с его идеями решила 34,3% задач против 26,2% без подсказок.
- На олимпиадных задачах Omni-MATH-24, которых не было в обучении, прирост скромнее: 18,6% против 11,3% без подсказок.
Детали: авторы проверили, откуда берётся прирост.
- Подсказки от чужих задач подняли результат лишь до 23,9%: примерно 15 из 20 пунктов прироста дают идеи, относящиеся к самой задаче.
- Готовый ответ нашёлся только в 0,44% подсказок, поэтому авторы делают вывод, что подсказчик направляет поиск, а не выдаёт решение.
- Ту же 7B-модель учили решать задачи напрямую, и она справилась хуже, чем необученный подсказчик в паре с большой моделью.
- Подсказки обходятся меньше чем в 0,3% вычислений, которые уходят на 128 попыток большой модели.
Интрига: сначала авторы повторили похожий метод GuidedSampling и не нашли у него преимущества. В исходной работе обычный перебор был настроен на однообразные ответы, а когда ему дали больше свободы, подсказки перестали помогать и даже немного вредили.
Но: у метода есть ограничения.
- Обучение дорогое: чтобы оценить подсказки к одной задаче, большая модель пишет 1 024 ответа, и столько же раз их проверяет модель-судья.
- Метод проверяли только на математике, а судьёй служила та же Qwen2.5-32B, что решала задачи.
- Обучение дольше 200 шагов прироста не дало, а лучший вариант около 750-го шага начал выдавать слишком длинные подсказки и резко просел.
Что дальше: авторы хотят удешевить оценку подсказок, делить попытки между идеями не поровну, а по их полезности, и проверить подход за пределами математики.