Microsoft научила ИИ-агентов учиться на опыте без переобучения модели
Фреймворк EvoLib от Microsoft Research превращает прошлые попытки модели в библиотеку навыков и выводов, которую постоянно уточняет. Модель при этом не меняется, поэтому подход работает даже с моделями, доступными только через API.
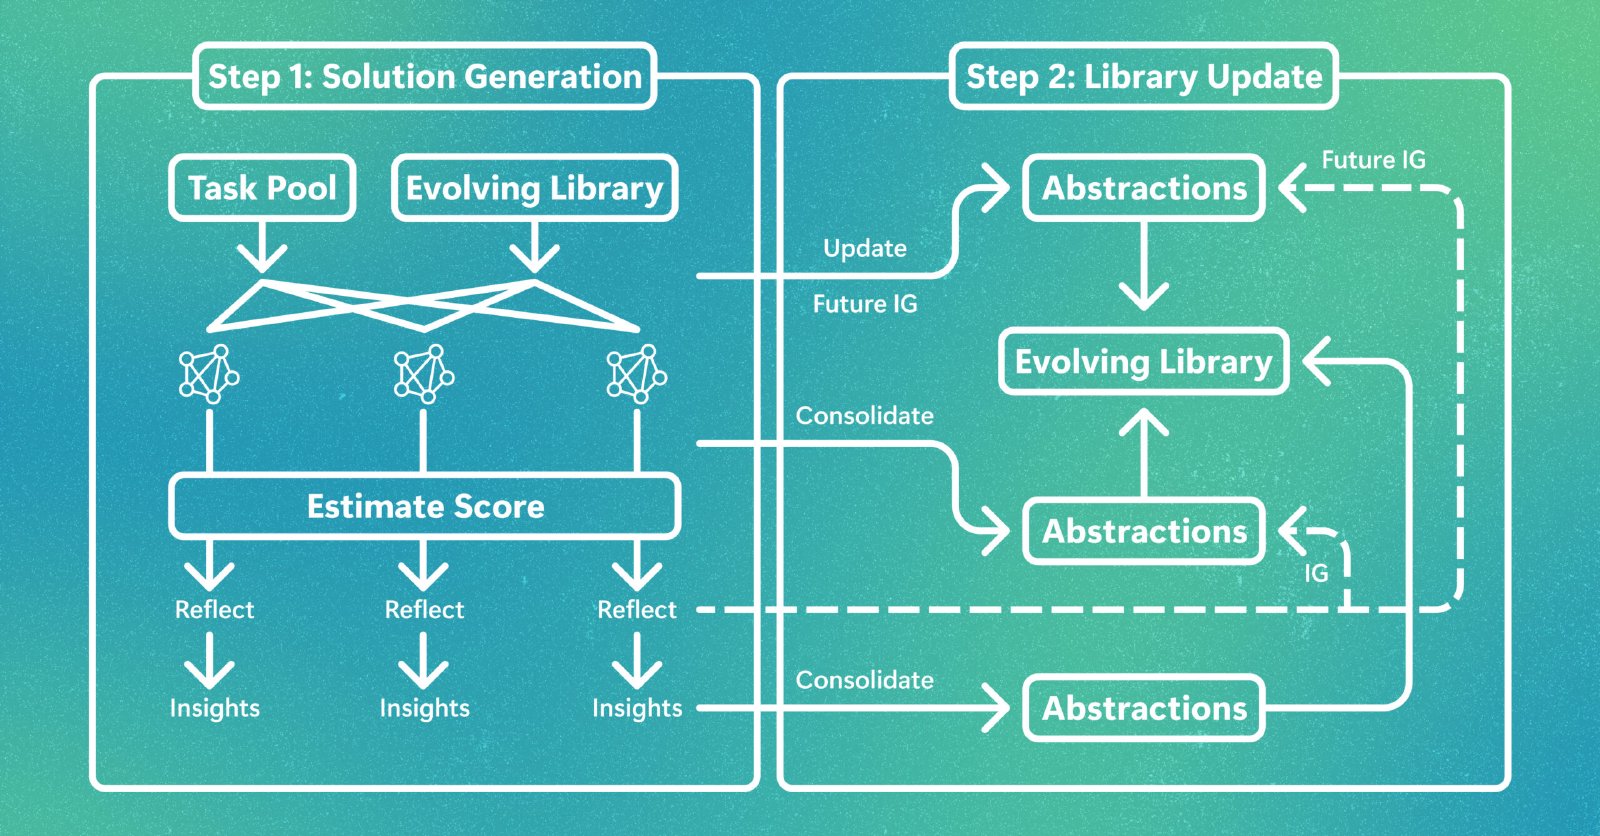
Исследователи Microsoft Research представили EvoLib — способ, которым языковая модель учится на своих прошлых попытках уже после запуска в работу. Саму модель при этом не переобучают. Меняется библиотека знаний, к которой она обращается.
Авторы исходят из простой мысли: хранить всё подряд — ещё не значит учиться. Сегодня многие ИИ-агенты запоминают прошлые разговоры и действия. Со временем такой архив разрастается, и найти в нём нужное для новой задачи становится всё труднее. Человек, пишут исследователи, помнит не каждую деталь, а то, что сработало, и ошибки, которых стоит избегать.
EvoLib работает похожим образом. Из удачного решения он извлекает навык, который можно применить снова. Из ошибки — вывод. Когда появляется новое знание, система ищет в библиотеке похожее и объединяет их в более общее правило. Каждому знанию она присваивает вес. Вес зависит не только от того, помогло ли оно в текущей задаче, но и от того, помогает ли оно получать полезные знания дальше. Правильных ответов и внешней оценки для этого не нужно: система учится сама.
Авторы проверили подход на трёх бенчмарках. Среди задач — написание кода с ограничениями по эффективности и долгие задачи, где агент исследует среду и принимает решения. По их данным, EvoLib стабильно обходит лучшие системы памяти, построенные на поиске по прошлым записям, и тратит при этом меньше токенов. Если дать ему больше вычислений во время работы, результат растёт быстрее, чем у конкурирующих методов.
Исследователи проверили и порядок задач. Реальный агент получает запросы вперемешку, и учиться ему приходится без продуманной программы. EvoLib показал стабильный результат при разном порядке задач.
Поскольку модель не меняется, EvoLib можно подключить к любой закрытой модели, доступной через API. Код и результаты экспериментов выложены на GitHub. Конкретных цифр прироста в блоге нет: они приведены в статье и на графиках.