Hugging Face объяснила, как устроен поиск статей на возрождённом Papers with Code
Поиск на Papers with Code объединяет поиск по словам и поиск по смыслу. Статьи переводит в векторы модель Qwen3-Embedding-0.6B. Если сервис с моделью не отвечает, сайт сразу выдаёт результаты обычного полнотекстового поиска.
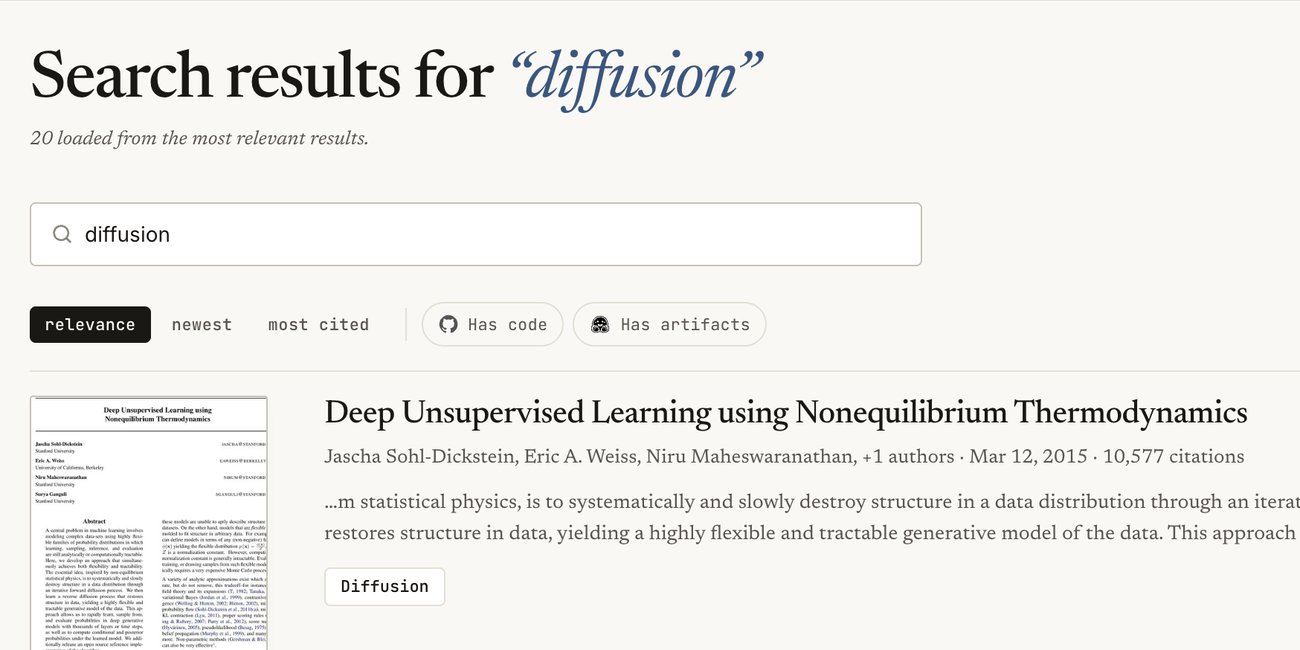
Поиск на Papers with Code понимает запросы вроде «малые языковые модели для генерации кода», даже если в самих статьях эти слова вместе не встречаются. Команда Hugging Face, которая три месяца назад возродила каталог научных статей по ИИ, рассказала, как этот поиск устроен. В базе уже больше 110 000 статей с arXiv и Daily Papers.
Поиск гибридный. Обычный полнотекстовый поиск в PostgreSQL отвечает за точные совпадения: названия, идентификаторы arXiv, редкие имена. Параллельно работает поиск по смыслу: статьи и запрос переводятся в числовые векторы, и система ищет близкие к запросу. Каждая ветка приносит до 50 кандидатов. Затем алгоритм взаимного ранжирования смешивает списки, и выше оказываются статьи, которые высоко стоят в обоих. Точное название или номер arXiv всегда остаются первыми, а запрос «оригинальная статья про BERT» система распознаёт как поиск конкретной работы.
Векторы строит модель Qwen3-Embedding-0.6B, её выбрали по рейтингу MTEB. Модель умеет укорачивать векторы почти без потерь, и команда оставила 256 чисел вместо 1 024. В пилотном тесте на 5 000 статей такая база заняла около 27% прежнего объёма, а качество поиска почти не изменилось. Одна запись находилась примерно за 1–2 миллисекунды. Всю базу переводят в векторы разовыми задачами на арендованной видеокарте NVIDIA L4, она обрабатывает около 75 статей в секунду. Новые и исправленные статьи раз в час отправляются в тот же сервис, который обрабатывает запросы пользователей.
Главное инженерное решение касается сбоев. Сервис с моделью в простое отключается, чтобы не платить за пустое время, и после паузы запускается не сразу. Поэтому, если он «холодный», перегружен или вернул мусор, сайт не ждёт его ответа и сразу показывает результаты обычного поиска. Разработчики советуют не усложнять систему без нужды. Начинать стоит с поиска по ключевым словам, а смысловой поиск добавлять, только если он заметно улучшает выдачу.
Те же векторы теперь подбирают похожие статьи на странице каждой работы, и для этого даже не нужно заново вызывать модель. Поиском можно пользоваться на paperswithcode.co, а ИИ-агенты подключаются к нему через консольную команду.