По отчёту DeepSeek её маржу на запросах к моделям оценили примерно в 80%
Час работы одного ИИ-ускорителя приносит DeepSeek 38 долларов по ценам для часов низкой нагрузки. Если этот час обходится компании в 5–10 долларов, после таких расходов остаётся 74–87% выручки.
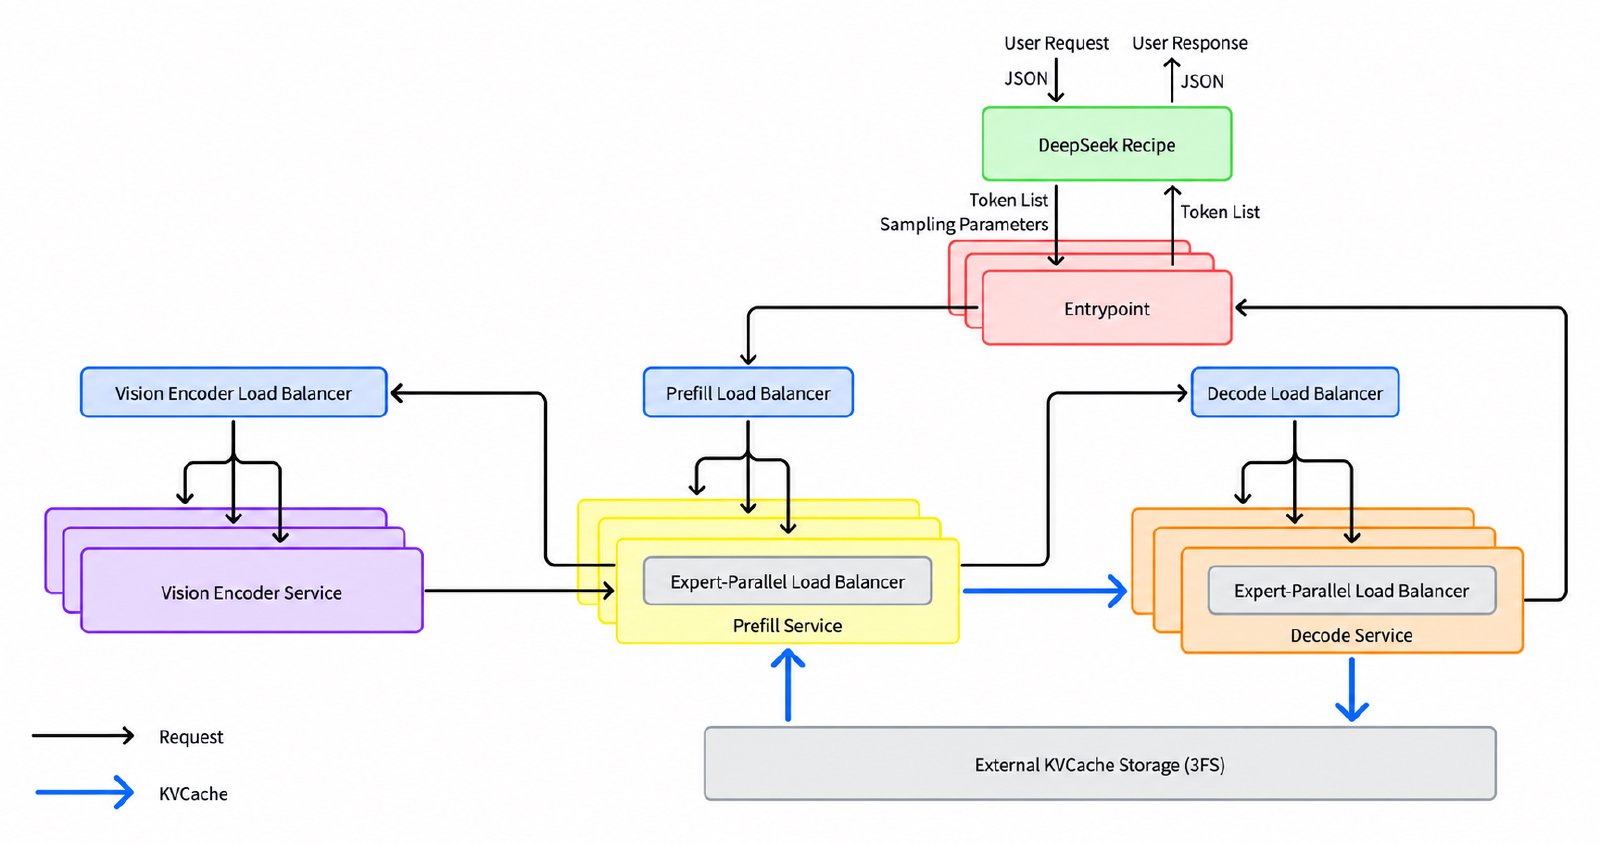
DeepSeek сообщила в отчёте о своём движке DeepInfer, что один ускоритель приносит ей 38 долларов в час. По этой цифре комментаторы оценили её маржу на обслуживании запросов примерно в 80%.
Почему это важно: по цифрам рабочего сервиса можно прикинуть, окупается ли у ИИ-лаборатории само обслуживание запросов. А по замерам самой команды vLLM, почти такую же скорость генерации ответа могут получить не только в DeepSeek, но и все, кто запускает модели на её общедоступном движке.
Предыстория: 20 октября DeepSeek открыла код DeepInfer — движка, на котором сама запускает модель V4.1-Flash, обновлённую 17 октября. Систему кэша и распределение нагрузки между серверами компания пока выложила не полностью: по её словам, они завязаны на внутреннюю инфраструктуру.
В цифрах: так DeepSeek описала свой рабочий сервис:
- Одна группа серверов обрабатывает 155 трлн токенов1 в сутки, считая и прочитанные моделью, и написанные ею.
- 96% входящих токенов сервис берёт из кэша, то есть не пересчитывает заново то, что модель уже читала раньше.
- Первый токен ответа пользователь получает в среднем через 400 мс, а дальше модель пишет по 230 токенов в секунду.
- Час работы одного ускорителя приносит 38 долларов выручки, и это по сниженным ценам для часов низкой нагрузки.
Детали: уже обработанное начало разговоров DeepSeek хранит в отдельном хранилище на SSD-дисках объёмом больше 100 петабайт: для агентов три дня, для чат-бота неделю. Агентам это особенно выгодно, ведь они раз за разом присылают модели всю растущую историю работы. OpenAI на днях добавила в свой API хранение кэша на 12 часов, по умолчанию оно длится 30 минут.
Откуда цифра: на каких ускорителях получены 38 долларов, DeepSeek не сказала, поэтому их стоимость берут с допущениями:
- Если час работы ускорителя обходится в 5–10 долларов, после его оплаты остаётся от 74 до 87% выручки.
- Один из комментаторов по тестовым замерам скорости сначала насчитал 88–97%, а потом снизил оценку до 84–96%: в работе ускорители DeepSeek приносят меньше, чем следовало из тестов.
- Latent Space2 прикинула для целого кластера, за сколько дней такая маржа окупит ускорители, и получила 81 день. По словам издания, сама DeepSeek закладывает на окупаемость десять месяцев.
Но: в расчёт входит только сам ускоритель. Хранилище, процессоры, сеть, запасные мощности, инженеры и обучение моделей остаются за скобками. К тому же цифры держатся на очень выгодной нагрузке: почти все входящие токены сервис берёт из кэша и не считает заново. Где повторов меньше, ускорителю приходится больше считать, и маржа выходит ниже.
Другая сторона: DeepInfer вырос в основном из vLLM — общедоступного движка для запуска моделей. Команда vLLM повторила настройки DeepSeek на ускорителях NVIDIA GB2003: по числу токенов, которые ускоритель выдаёт в секунду, разница с цифрами DeepSeek не больше 6%, а рецепты для проверки выложены. Правда, сравнивали только генерацию ответа, а не весь сервис с кэшем, и замеры делала сама команда vLLM.
Что дальше: DeepSeek обещает выкладывать в тот же репозиторий движки и оптимизации для своих будущих моделей.