SemiAnalysis вынесла часть DeepSeek V4.1-Flash из видеопамяти в ОЗУ
Engram — таблица, в которой модель хранит частые сочетания токенов. По замерам SemiAnalysis, из оперативной памяти сервера она работает не хуже, чем из видеопамяти, а с SSD выходит дороже.
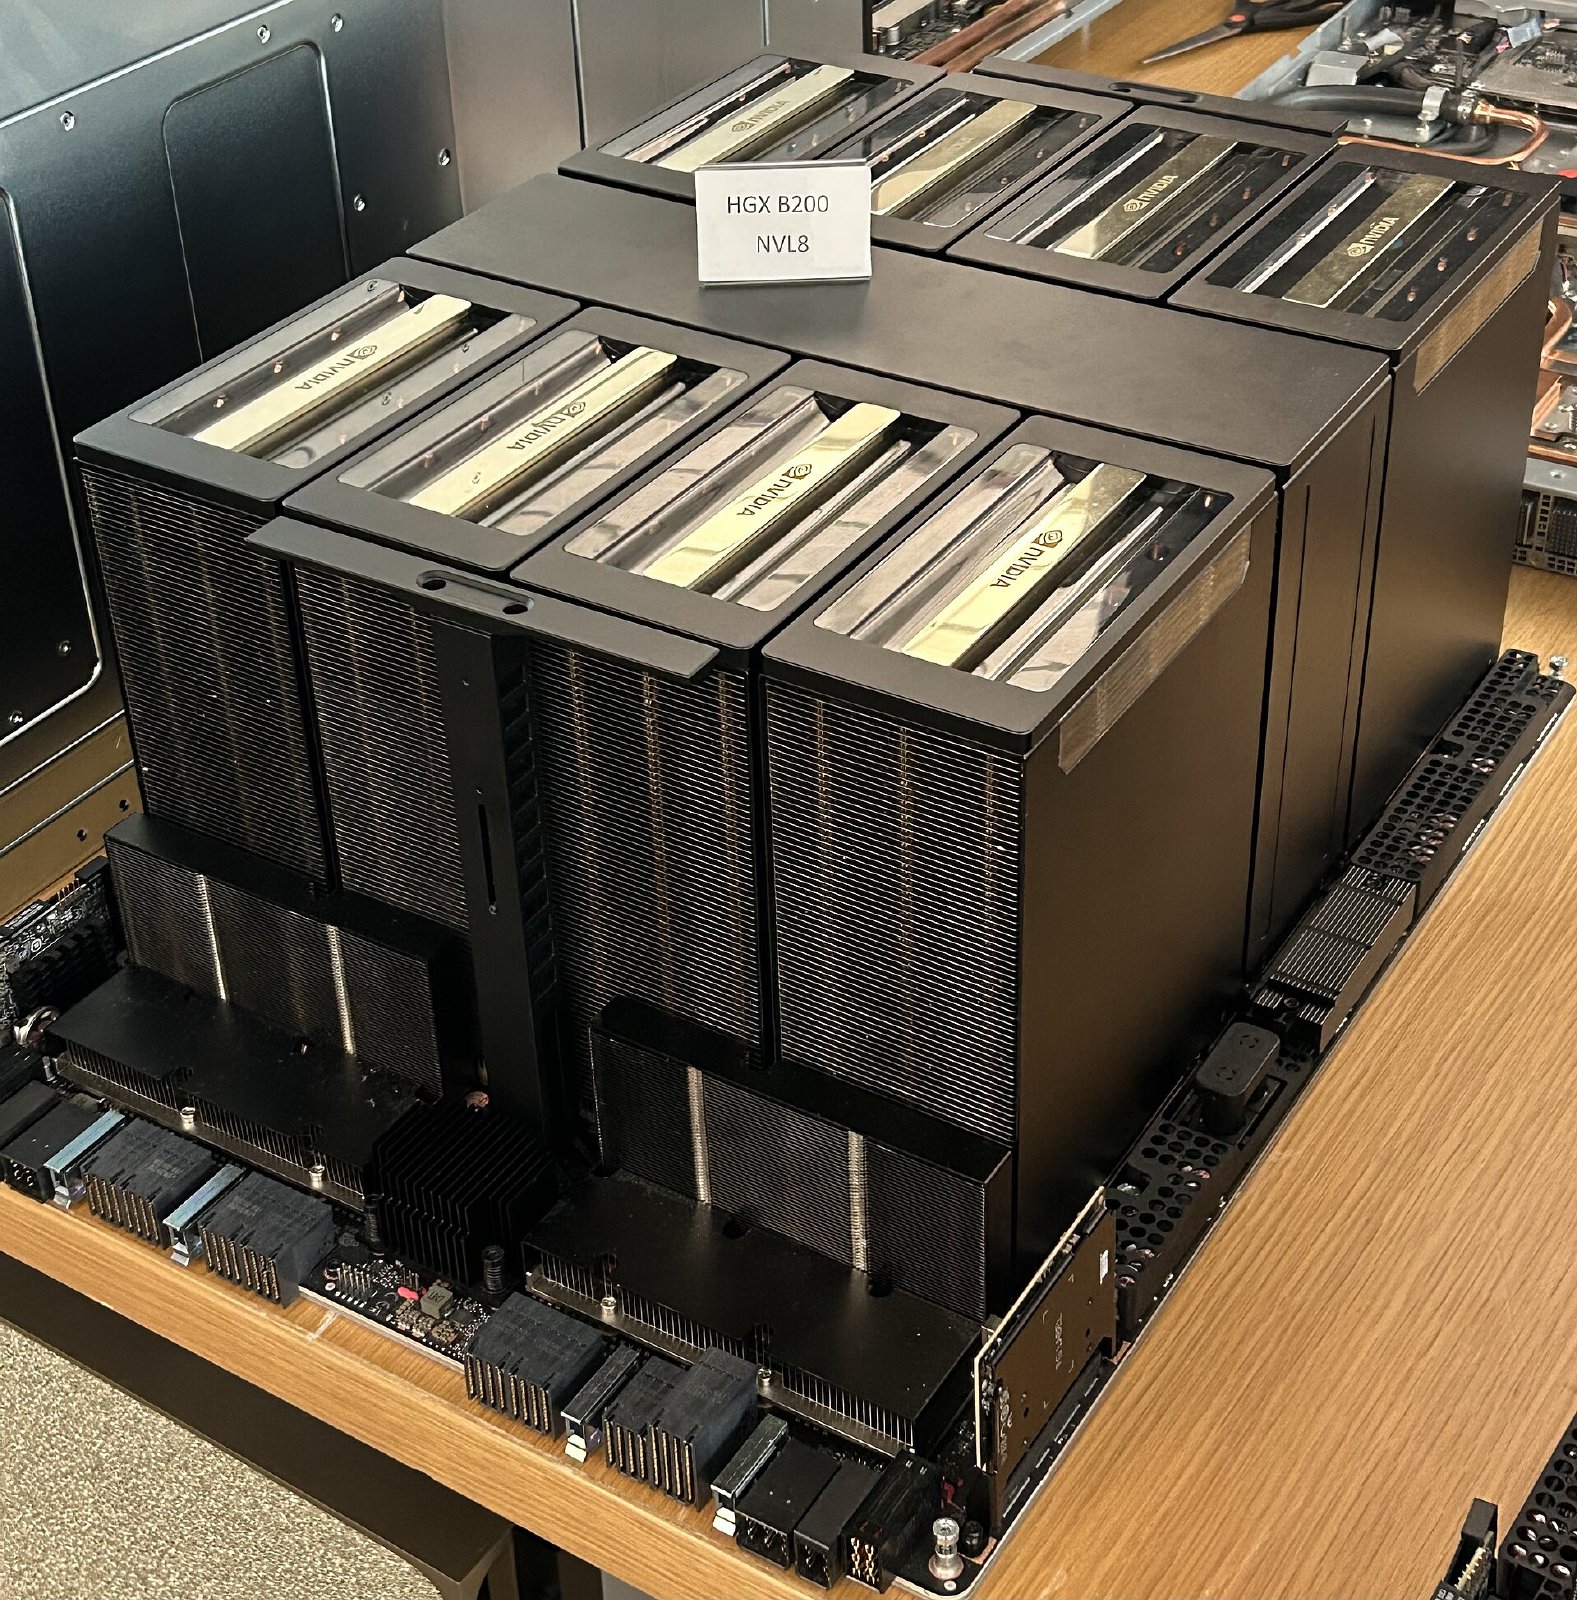

Аналитики SemiAnalysis перенесли 189 ГиБ модели DeepSeek V4.1-Flash из видеопамяти в обычную оперативную память сервера. Работать модель от этого не стала медленнее, а в некоторых режимах даже ускорилась. Отчёт вышел 18 сентября, через восемь дней после выхода модели.
Почему это важно: видеопамять HBM на ускорителях стоит дорого и её не хватает. Освобождённые гигабайты можно отдать под кэш контекста, а значит, возможно, обслуживать больше пользователей одновременно.
Общая картина: по данным SemiAnalysis, Nvidia пришлось урезать HBM у будущего ускорителя Rubin Ultra с 1024 ГБ до примерно 200 ГБ на чип. Аналитики считают, что с архитектурами вроде Engram пропускная способность HBM важнее её объёма.
Как это работает: Engram DeepSeek описала в январской статье. Это большая таблица частых сочетаний из нескольких токенов: знакомый фрагмент текста модель берёт из неё готовым, а не собирает заново в основных слоях нейросети.
Детали: какие строки таблицы понадобятся, зависит только от самих токенов текста, а не от промежуточных вычислений. Поэтому сервер подгружает их из оперативной памяти заранее, пока видеокарта считает предыдущие слои.
В цифрах: вот что показали замеры SemiAnalysis.
- В конфигурации аналитиков таблица Engram у V4.1-Flash занимает около 189 ГиБ.
- На каждый токен модель читает по 24 строки в двух слоях, это около 12,4 КиБ, или 3,1 КиБ на каждую из четырёх видеокарт.
- На Nvidia B300 возврат таблицы в видеопамять не дал прироста сверх обычного разброса между прогонами.
- Без таблицы в видеопамяти одна копия модели на B300 поместилась на двух видеокартах вместо четырёх, и соотношение пропускной способности и скорости улучшилось до 1,6 раза.
Но: переносить таблицу ещё дальше, на SSD, невыгодно. На B200 при скорости около 125 токенов в секунду на пользователя оперативная память дала 121 млн токенов на доллар, а SSD — 52 млн. Правда, для опыта с SSD аналитики взяли неоптимизированную версию vLLM1.
Что говорят: «Более дешёвое хранилище не делает сервис инференса автоматически дешевле. Перенос Engram на SSD оставляет на месте те же четыре дорогие видеокарты и весь остальной сервер», — пишут аналитики SemiAnalysis.
Интрига: просто отключить Engram, как внешний словарь, нельзя. Без таблицы модель меняет выбор «экспертов» — внутренних подсетей, между которыми делится работа, — и так отчасти восполняет потерю:
- без таблицы модель хуже предсказывает текст во всех проверенных областях, сильнее всего в энциклопедических статьях и коде;
- точность на школьных задачах GSM8K2 осталась в пределах разброса между прогонами;
- на тесте CRUXEval, где нужно предсказать результат небольшой функции на Python, потери на правильном ответе выросли с 0,2848 до 0,3093 бита на токен;
- когда модель без таблицы заставили выбирать тех же экспертов, что и с ней, потери выросли до 0,3375 бита на токен.
Расклад: в бенчмарке InferenceX3 аналитики сравнили, как V4.1-Flash работает на ускорителях Nvidia и AMD.
- В день выхода модели vLLM для Nvidia без проблем запустился на всех шести ускорителях, от H100 до GB300.
- Образ vLLM для AMD, на который ссылается документация компании, 23 часа после выхода модели не был выложен в открытый доступ.
- Первая сборка для AMD давала на доллар до 14,8 раза меньше производительности, чем H200, и до 42 раз меньше, чем B200 и B300.
- На седьмой день MI355X отставал от B200 по производительности на доллар в 2–4 раза, даже с учётом его более низкой стоимости владения.
Подробнее: DeepSeek выпустила V4.1-Flash 10 сентября и открыла её веса. В модели 552 млрд параметров, из которых на каждый токен работают 8–16 млрд.