Бенчмарк MindTopo: ИИ видит узел на картинке, но теряет его, когда распутывает
Microsoft Research и соавторы выпустили MindTopo — бенчмарк на понимание связности, замкнутости, порядка и узлов. Мультимодальные модели узнают такие связи на статичной картинке заметно лучше, чем сохраняют их, пока действуют.
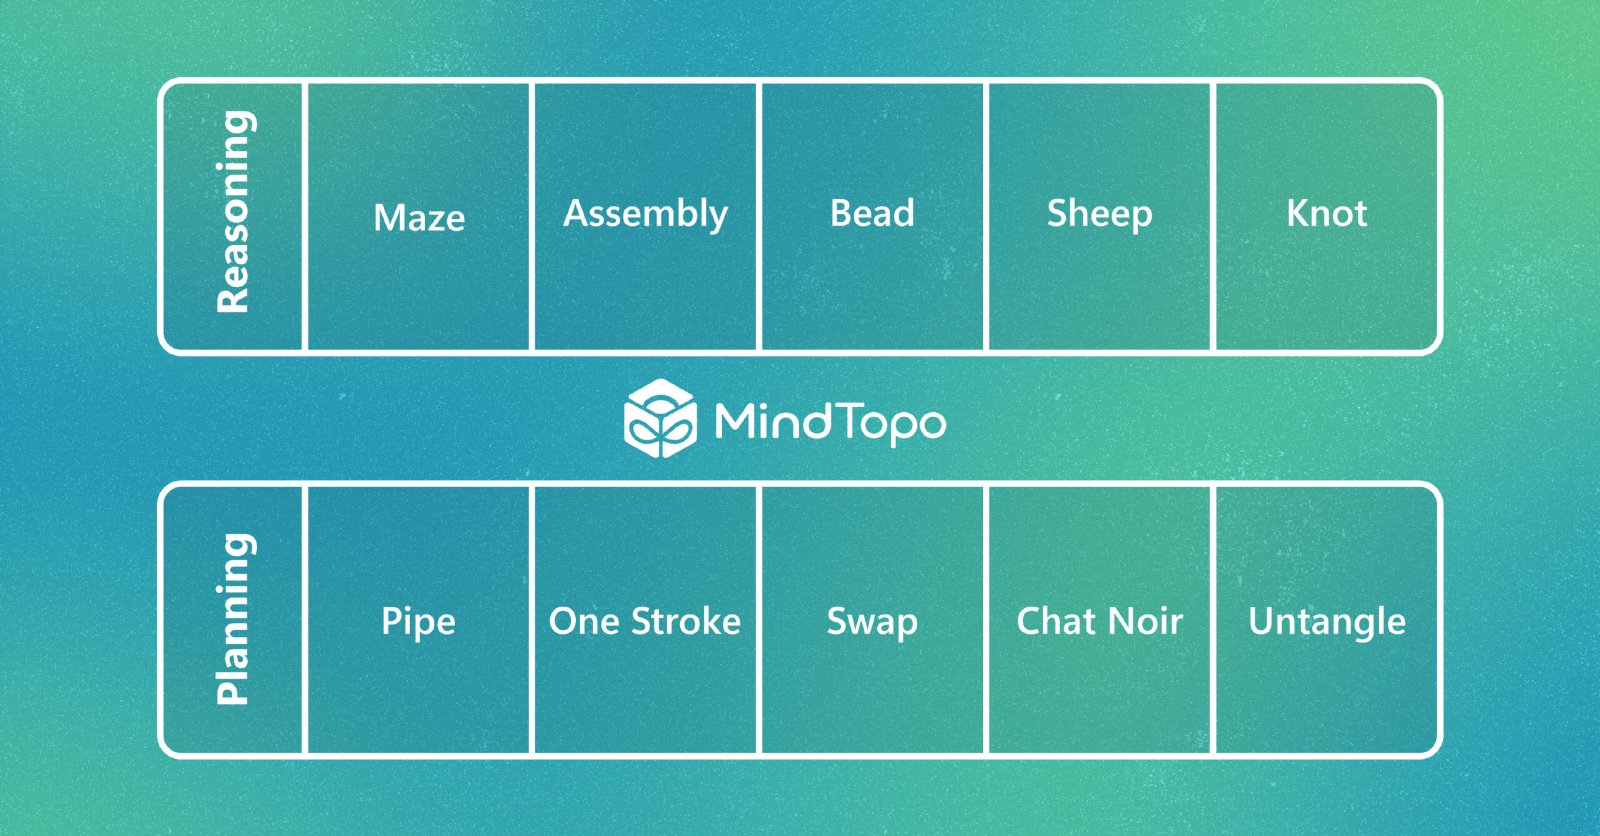
Мультимодальные модели неплохо замечают, что овцы стоят внутри забора или что верёвка завязана узлом. Но когда нужно пошагово что-то сделать — распутать верёвки или перегородить комнату, — это понимание быстро рассыпается. К такому выводу пришли авторы MindTopo, нового бенчмарка от Microsoft Research и соавторов.
Бенчмарк проверяет не расстояния и углы, а топологию — свойства, которые не меняются, когда предмет гнут или растягивают. Задания разбиты на пять групп. Проверяется, не разорван ли путь, одна ли это конструкция или несколько, в каком порядке идут элементы, есть ли у границы «внутри» и «снаружи». Пятая группа — настоящий ли перед нами узел или просто спутанная петля. Классификацию авторы взяли из когнитивной психологии, в том числе у Пиаже.
Каждую группу проверяют на двух уровнях. В заданиях на рассуждение модель смотрит на картинку и отвечает на вопрос: соединены ли две точки лабиринта, завязана ли верёвка. В заданиях на планирование она действует в симуляторе: поворачивает трубы, переставляет блоки, запирает движущегося агента, распутывает верёвки. Симулятор не даёт жульничать: протащить одну верёвку сквозь другую нельзя.
Все испытанные модели, закрытые и с открытыми весами, лучше справлялись со статичными картинками, чем с действиями. В обоих случаях они заметно отставали от людей. Ошибки тоже разные. На картинках модели в основном ошибаются в зрении: пропускают стену, проход или пересечение. При планировании сцену они уже поняли, но делают ход, который выглядит разумно сейчас и губит задачу через несколько шагов. Бывает, что модель теряет нить задачи за несколько ходов или предлагает физически невозможное действие.
Авторы проверили, помогут ли генераторы картинок и видео. Сгенерированное изображение иногда помогало, если нужная связь видна в одном кадре, но на цепочке ходов подводило. Сгенерированные видео часто сами меняли топологию сцены или нарушали правила задачи.
По мнению исследователей, для роботов и интерактивных помощников этот пробел критичен. Закрыть его, возможно, помогут модели, которые явно хранят топологическое состояние сцены, или модели мира, чьи предсказания сохраняют топологию по построению. Конкретных цифр по моделям в блоге Microsoft нет.