NVIDIA показала, как перенести симуляцию робота с процессора на видеокарту
В примере рука-манипулятор SO-101 ставит кубик на кубик: сначала в одной копии сцены, потом в 2 048 копиях одновременно. Такой масштаб, по словам авторов, нужен для обучения с подкреплением, где робот учится на опыте множества попыток.
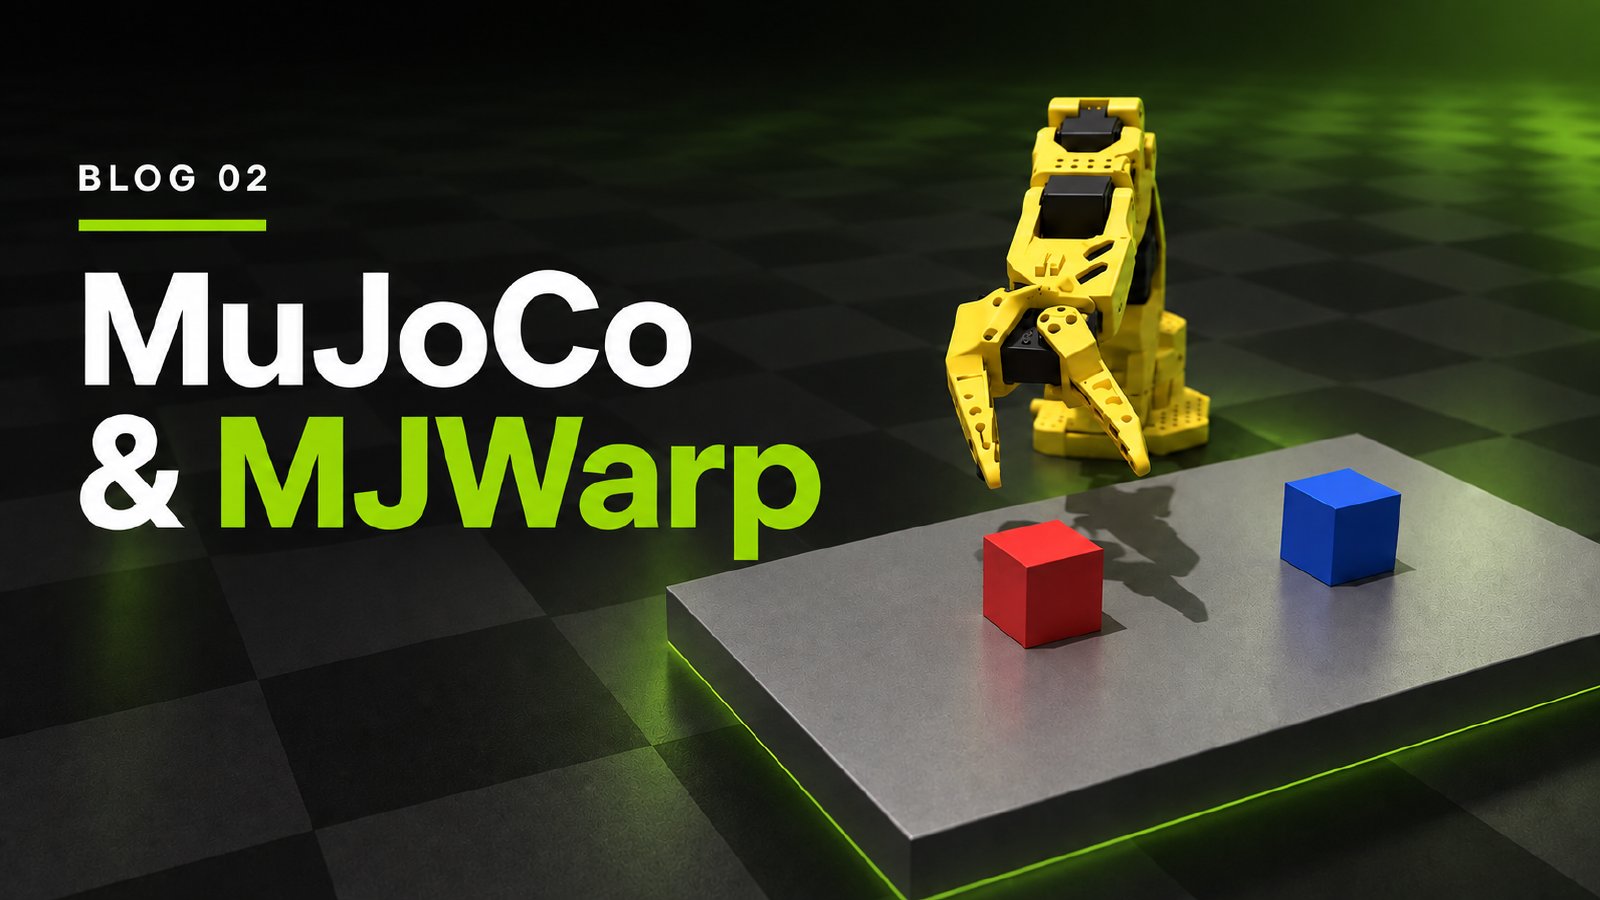
Симуляцию робота можно перенести с процессора на видеокарту в несколько шагов и проверить каждый, показала NVIDIA в руководстве на Hugging Face. Для этого используют физический симулятор MuJoCo и его версию для видеокарт — MuJoCo Warp (MJWarp). В примере рука-манипулятор SO-101 берёт красный кубик с ребром 44 мм и ставит его на синий. Число копий сцены, которые работают одновременно, растёт с одной до 2 048.
«Ценность MJWarp не обязательно в том, что один мир делает шаг быстрее. Она в том, что сотни или тысячи миров продвигаются вместе», — пишут авторы. Миром они называют независимую копию сцены с собственным состоянием: в одной рука тянется к кубику из одной позы, в другой — из немного другой. По их словам, такой режим выгоден для обучения с подкреплением1: там важнее, сколько опыта набрано всего, чем то, как быстро делает шаг один мир.
MuJoCo развивает Google DeepMind, классическая версия симулятора считает на процессоре. MJWarp делают вместе Google DeepMind и NVIDIA, код у неё открытый. Эта версия повторяет физику MuJoCo, но держит на видеокарте модель и состояния всех копий сцены, поэтому один вызов продвигает все копии разом. Написана она на Warp — фреймворке NVIDIA, который превращает код на Python в программы для видеокарты. SO-101 — недорогая рука-манипулятор с открытыми чертежами от Hugging Face, детали для неё печатают на 3D-принтере.
Сначала задачу решают в обычном MuJoCo и проверяют успех по двум числам. Центры кубиков по горизонтали должны расходиться не больше чем на 15 мм, а по вертикали — на 35–55 мм. Затем на видеокарте запускают одну копию сцены и после каждого шага копируют её состояние обратно, чтобы сверить те же числа. Только после этого копий становится 2 048, а обмен данными с процессором на каждом шаге убирают.
Авторы предупреждают о нескольких ловушках. Шаг физики нужно задать заранее, 0,002 секунды, иначе симулированное время в двух версиях разойдётся. Память под контакты — точки, где тела касаются друг друга, — MJWarp выделяет заранее. Если контактов больше, лишним места не хватает, но расчёт не останавливается: MJWarp только выводит предупреждение. Такой прогон авторы советуют считать недействительным. Засекать скорость простым таймером тоже нельзя: видеокарта работает асинхронно, и таймер покажет, как быстро Python поставил задачи в очередь.
Своих замеров скорости авторы не приводят. Результат зависит от сцены, настроек и оборудования, поэтому замерить его предлагают на своей видеокарте. Адрес репозитория с кодом примера в тексте не указан.
Это вторая статья цикла NVIDIA о симуляции для физического ИИ2. В следующей тот же пример перенесут в физический движок Newton3, а потом в Isaac Lab4. Newton будет управлять моделью, состояниями и контактами, а физику твёрдых тел внутри него будет считать MJWarp.